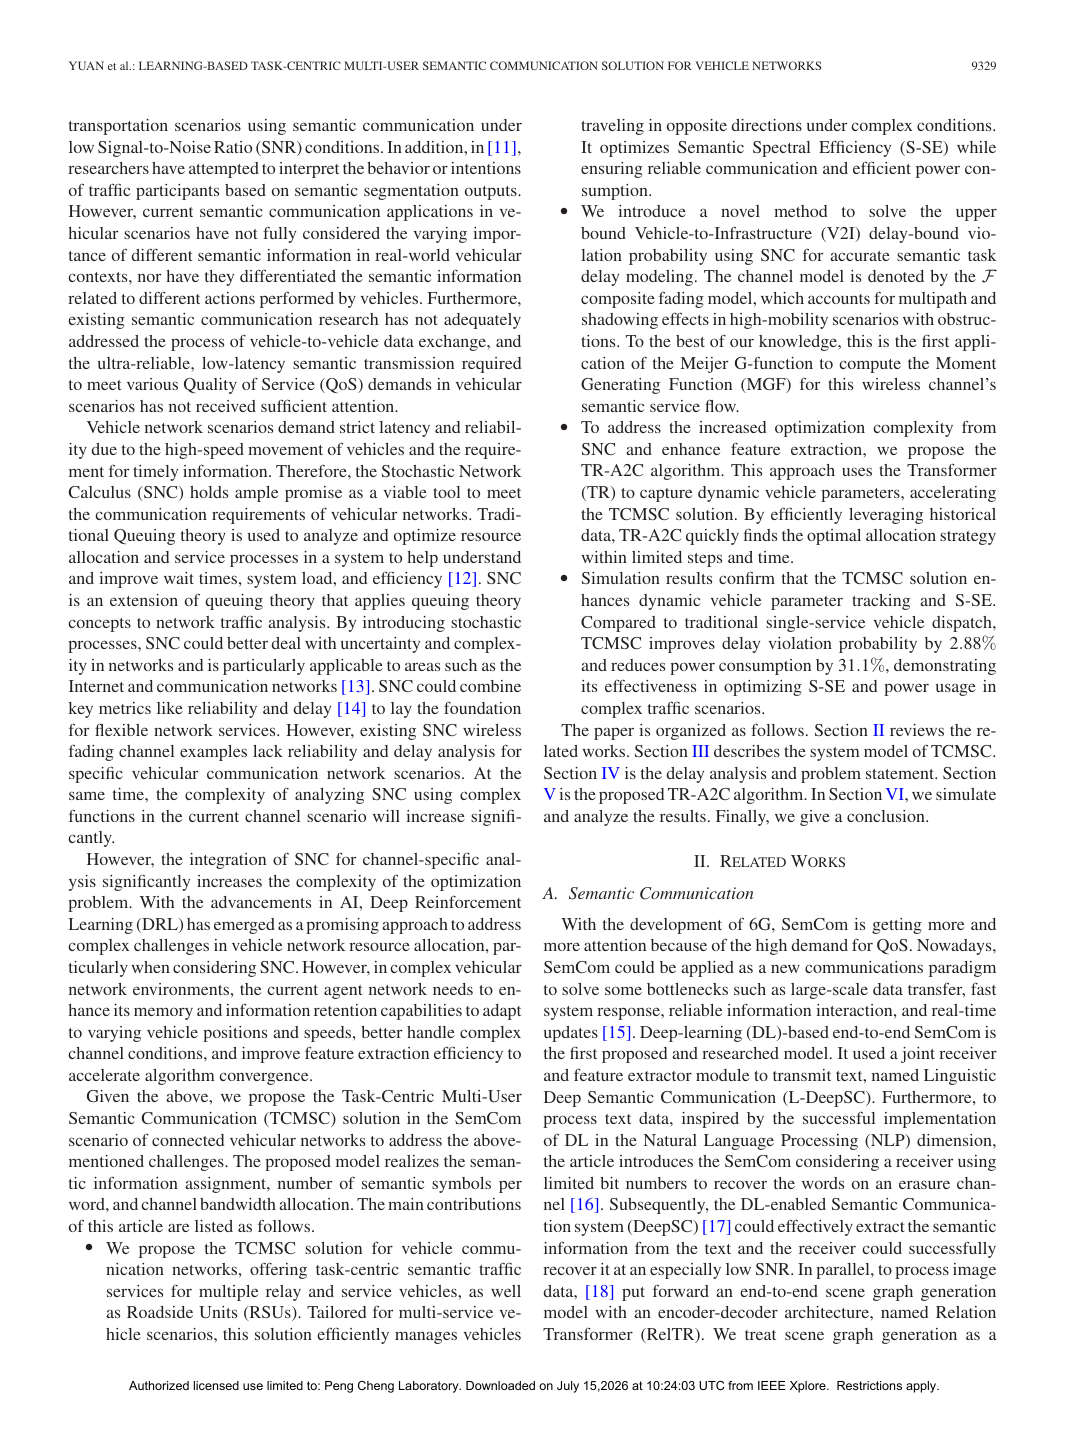
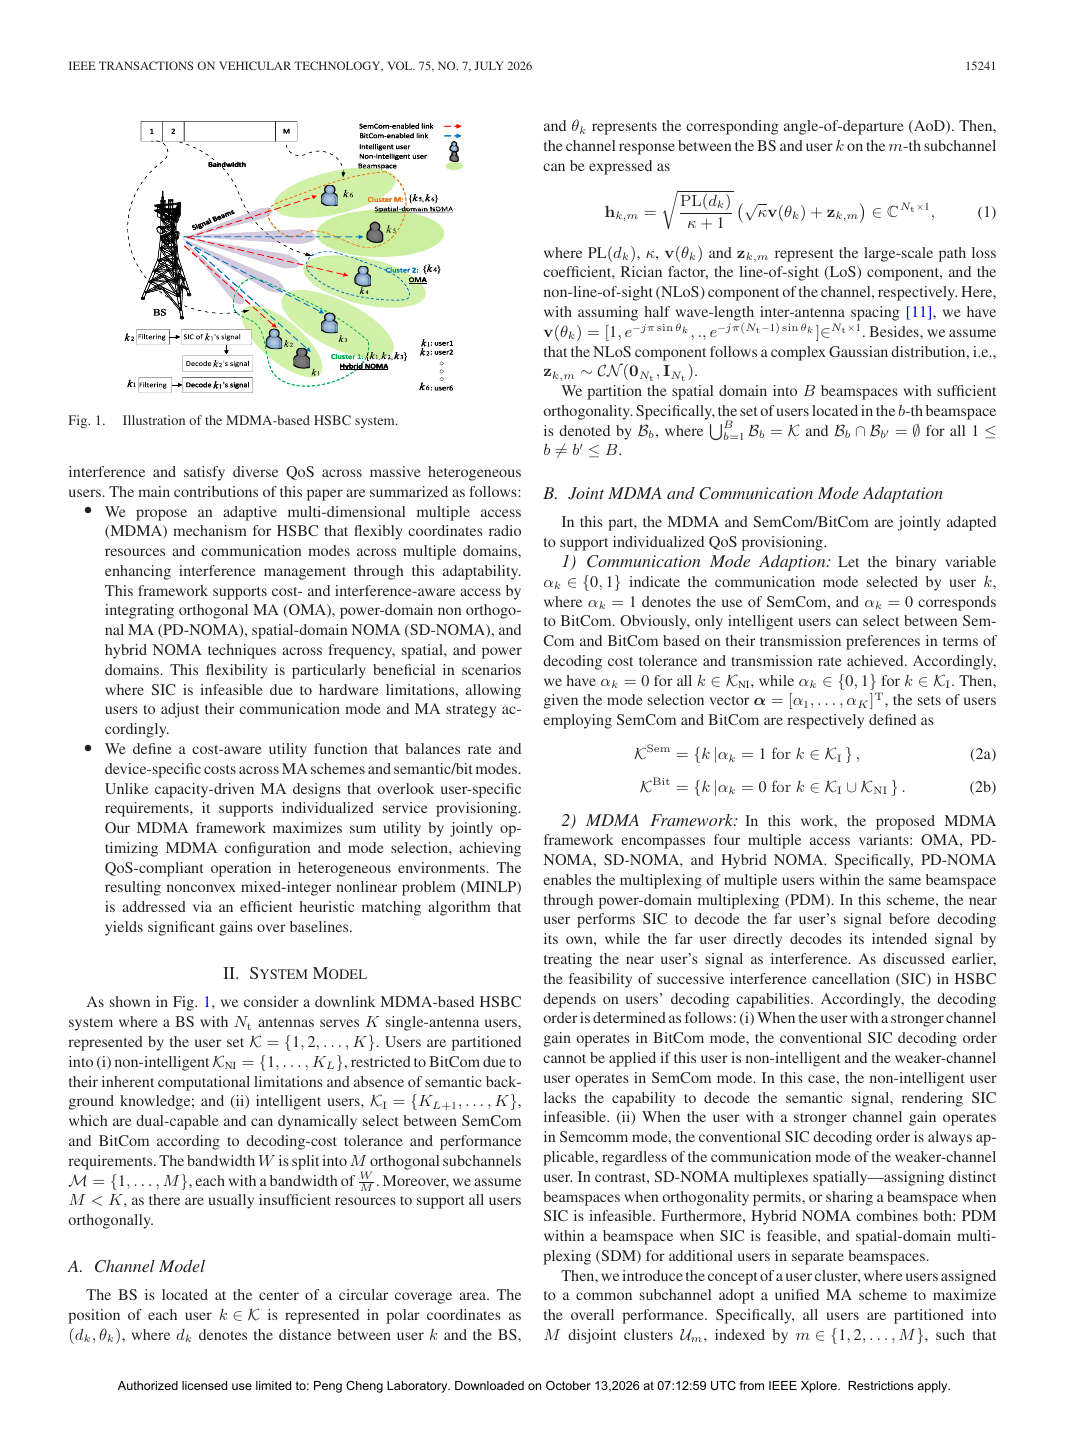
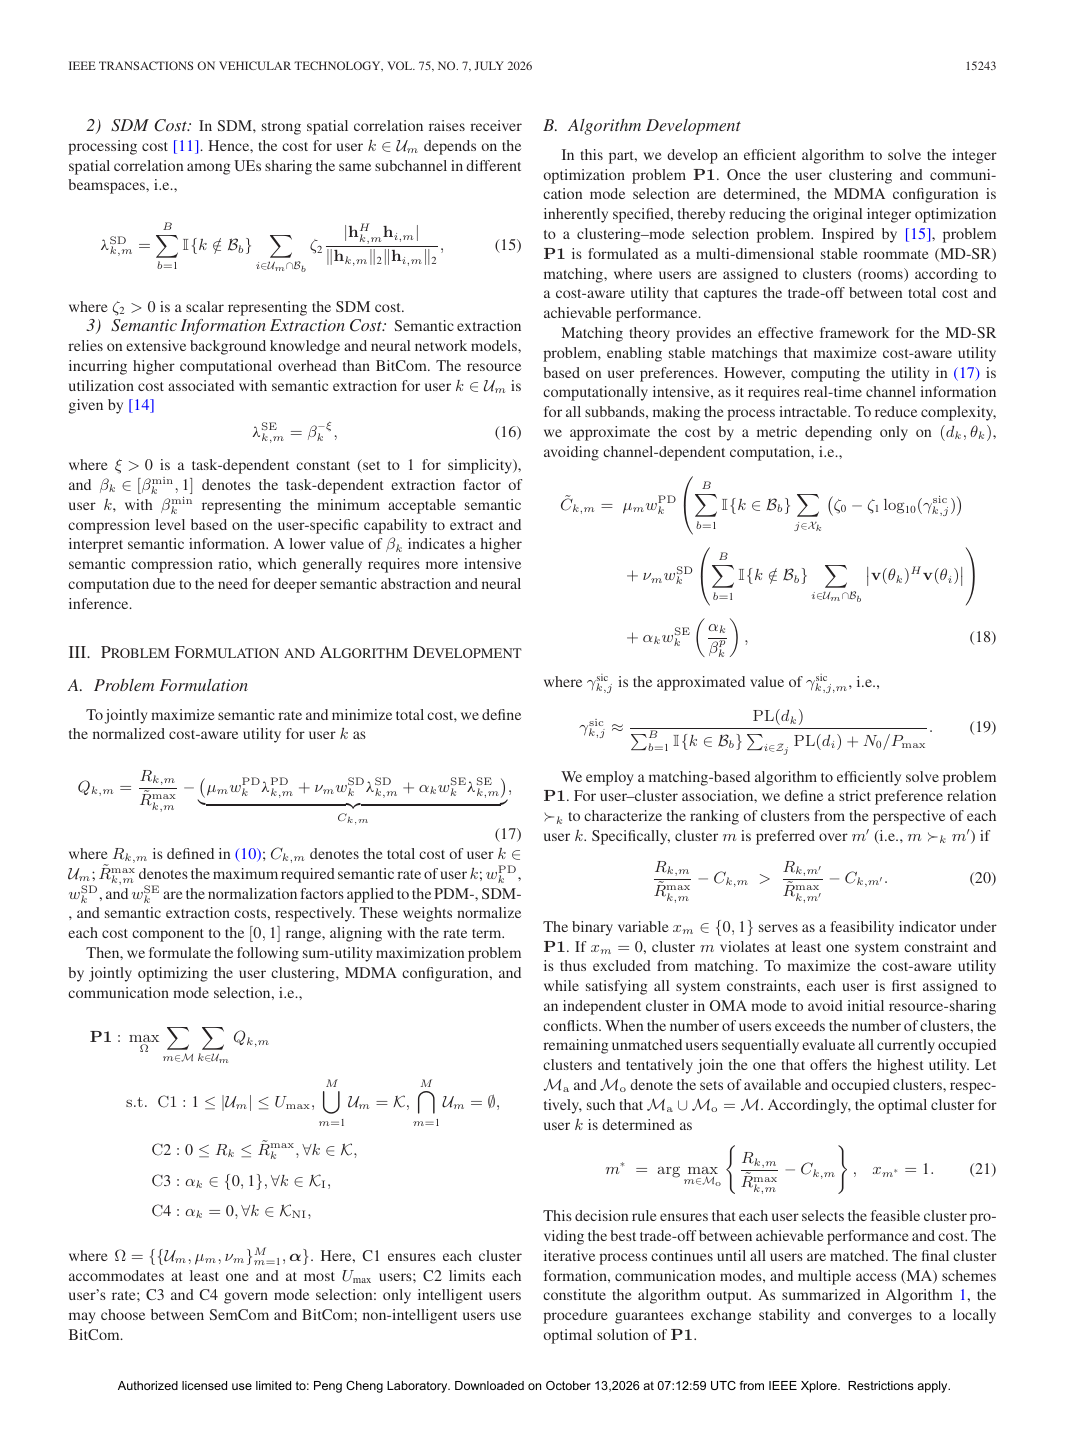
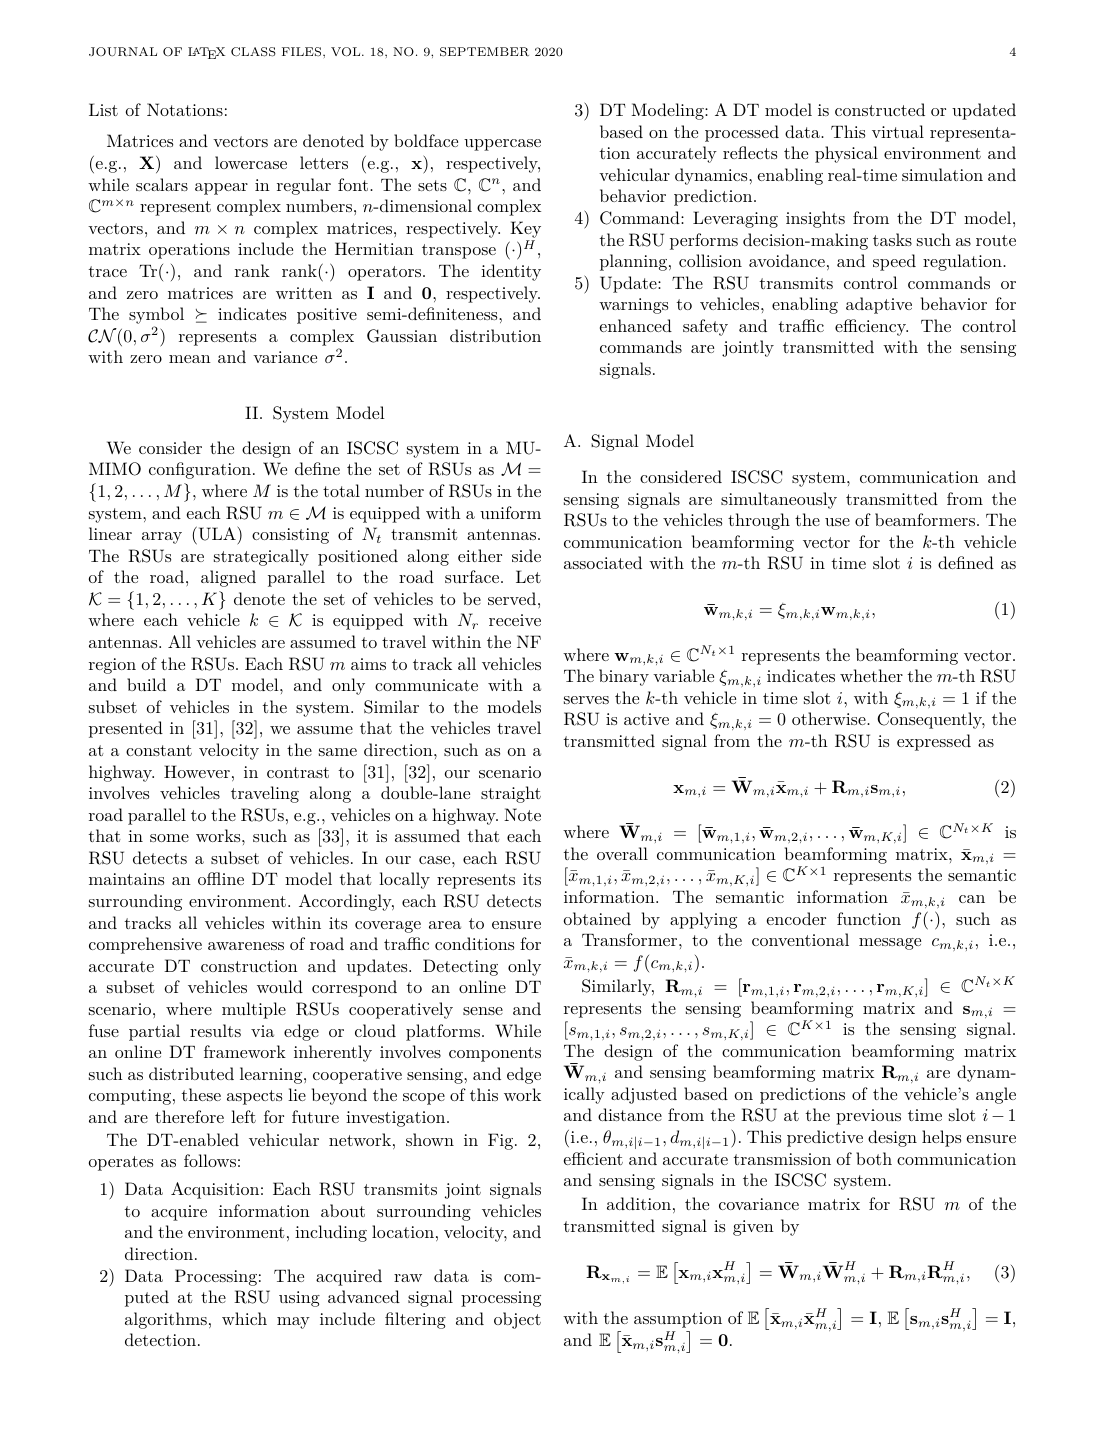
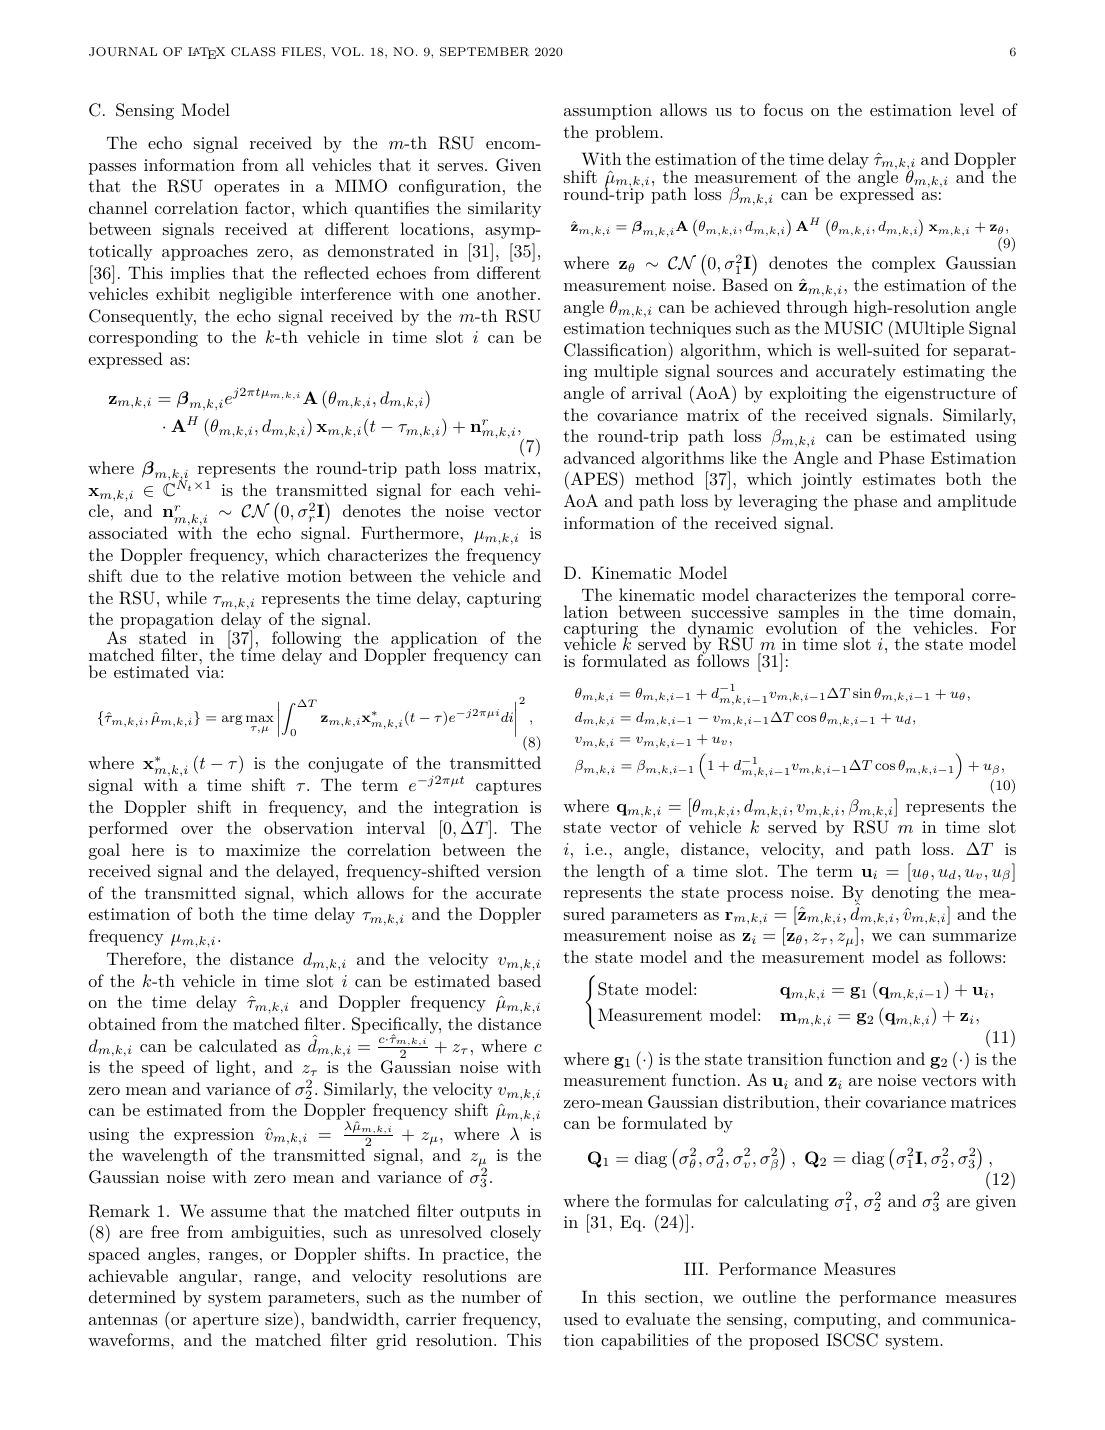
仍然存在的问题:然而,由于计算资源的限制,难以在边缘设备上支持精确语义模型的训练过程。 PDF p.1
为什么已有方法解决不了:分离压缩与信道编码优化的是中间 bit 可靠性,未必等价于本文关心的语义/任务质量;反过来,只做端到端网络而不交代带宽、功率和信道作用点也无法形成公平通信比较。 PDF p.1
为什么这个问题重要:语义质量必须在真实的带宽、功率和时延预算下成立,否则模型收益不能转化为通信系统收益。 PDF p.1
本文提出什么:因此,本文提出了一种层次化的交易系统,可以同时支持语义模型交易和语义信息交易。 PDF p.1
方案为何可能有效:语义通信技术使得无线边缘设备能够通过传输数据的语义来进行有效的通信。 PDF p.1
作者希望证明什么:对于语义信息交易,我们设计的拍卖方法能够支持多个语义信息买卖者之间的交易,同时保证了个体理性、激励相容性和预算平衡性,并使它们获得了比基线方法更高的效用。 PDF p.1
方法与端到端信息流
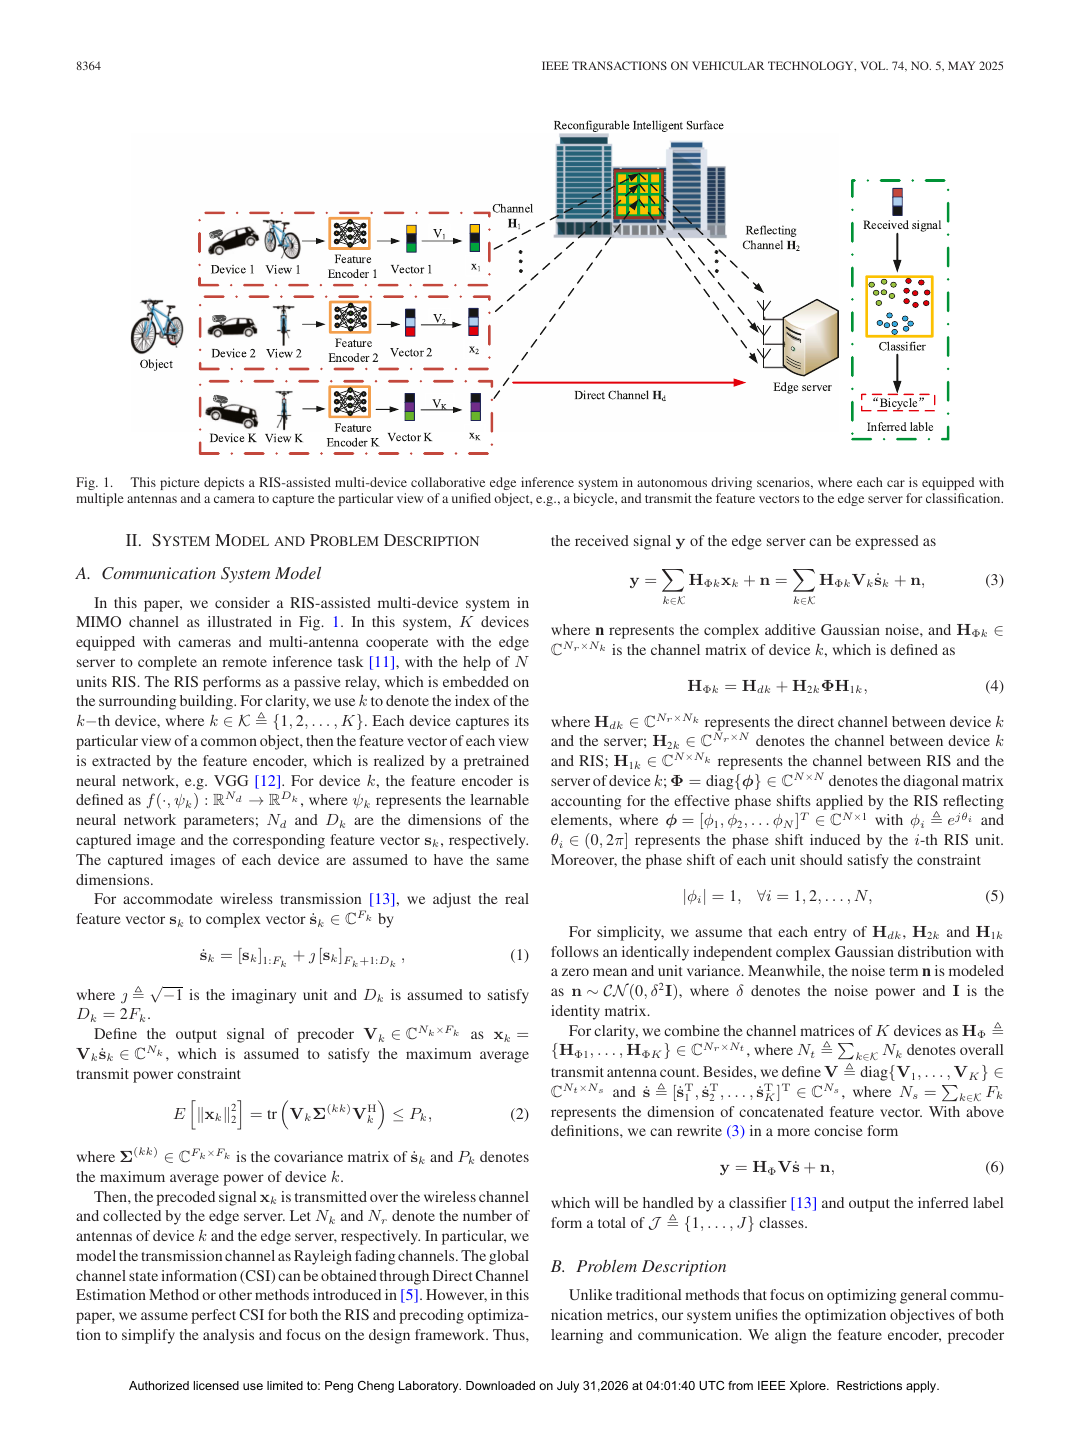
因此,在本文中,我们提出了一个层次化的交易系统,以共同支持语义模型交易和语义信息交易。语义通信技术使无线边缘设备能够通过传递数据的语义来进行有效通信。我们率先提出了一种深度学习(DL),以确定语义模型到边缘设备的分配以及边缘设备要向模型提供商支付的价格。 PDF p.1PDF p.2
输入输入是通用语义通信系统所需的信源数据和接收端任务。
发送端发送端采用 Economics of Semantic Communication System: An Auction Approach:因此,在本文中,我们提出了一个层次化的交易系统,以共同支持语义模型交易和语义信息交易。语义通信技术使无线边缘设备能够通过传递数据的语义来进行有效通信。我们率先提出了一种深度学习(DL),以确定语义模型到边缘设备的分配以及边缘设备要向模型提供商支付的价格。
实际发送实际发送对象是功率归一化的实数或复数神经信道符号。
信道信道作用方式按“类别 3:连续语义变量直接经过有噪声信道并端到端恢复”解释。
接收端接收端从AWGN/衰落作用后的带噪连续符号开始,再执行语义解码、任务推理或生成。
输出最终输出为重建内容或任务输出。
它在通信系统中的位置:在同一系统中共同设计压缩、语义保真和抗信道噪声机制。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:连续神经 JSCC latent / 实复信道符号
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“连续神经 JSCC latent / 实复信道符号”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:Economics of Semantic Communication System: An Auction Approach 的主传输单位属于“连续神经 JSCC latent / 实复信道符号”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
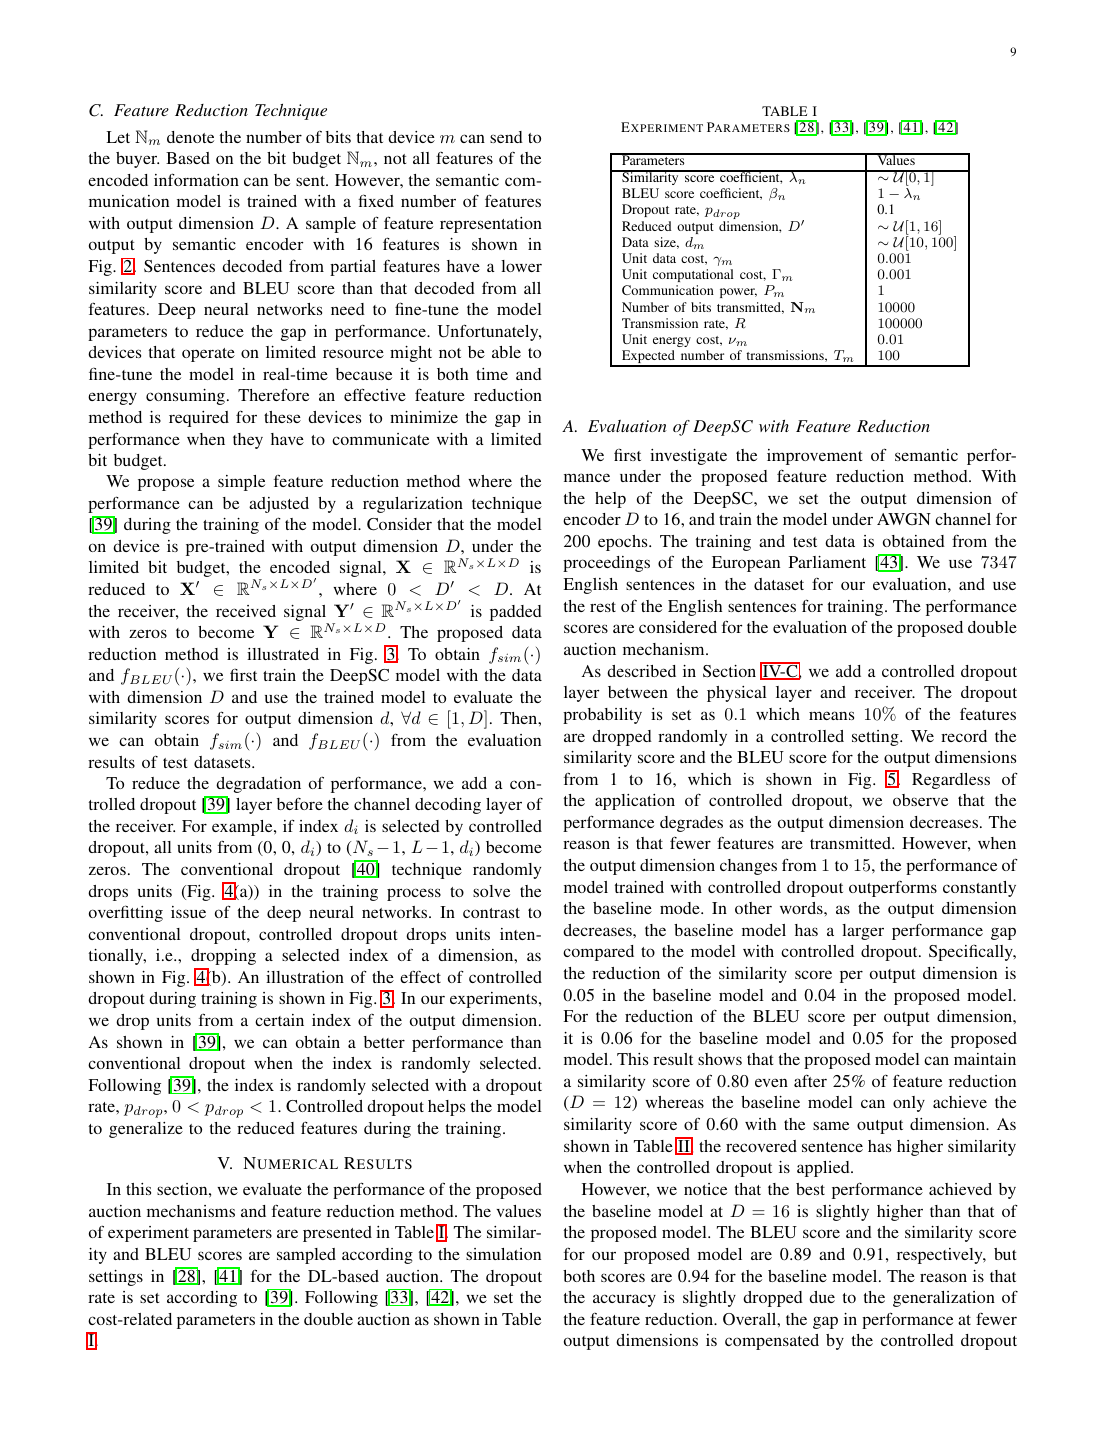
论文未同时报告输入尺寸、encoder 输出尺寸、量化精度/码本大小和帧级开销,因此不能从全文唯一重建总 bit 数。页面保留论文实际使用的 CBR、bpp、token 数或信道使用次数;缺失项不作臆测。 PDF p.2PDF p.9
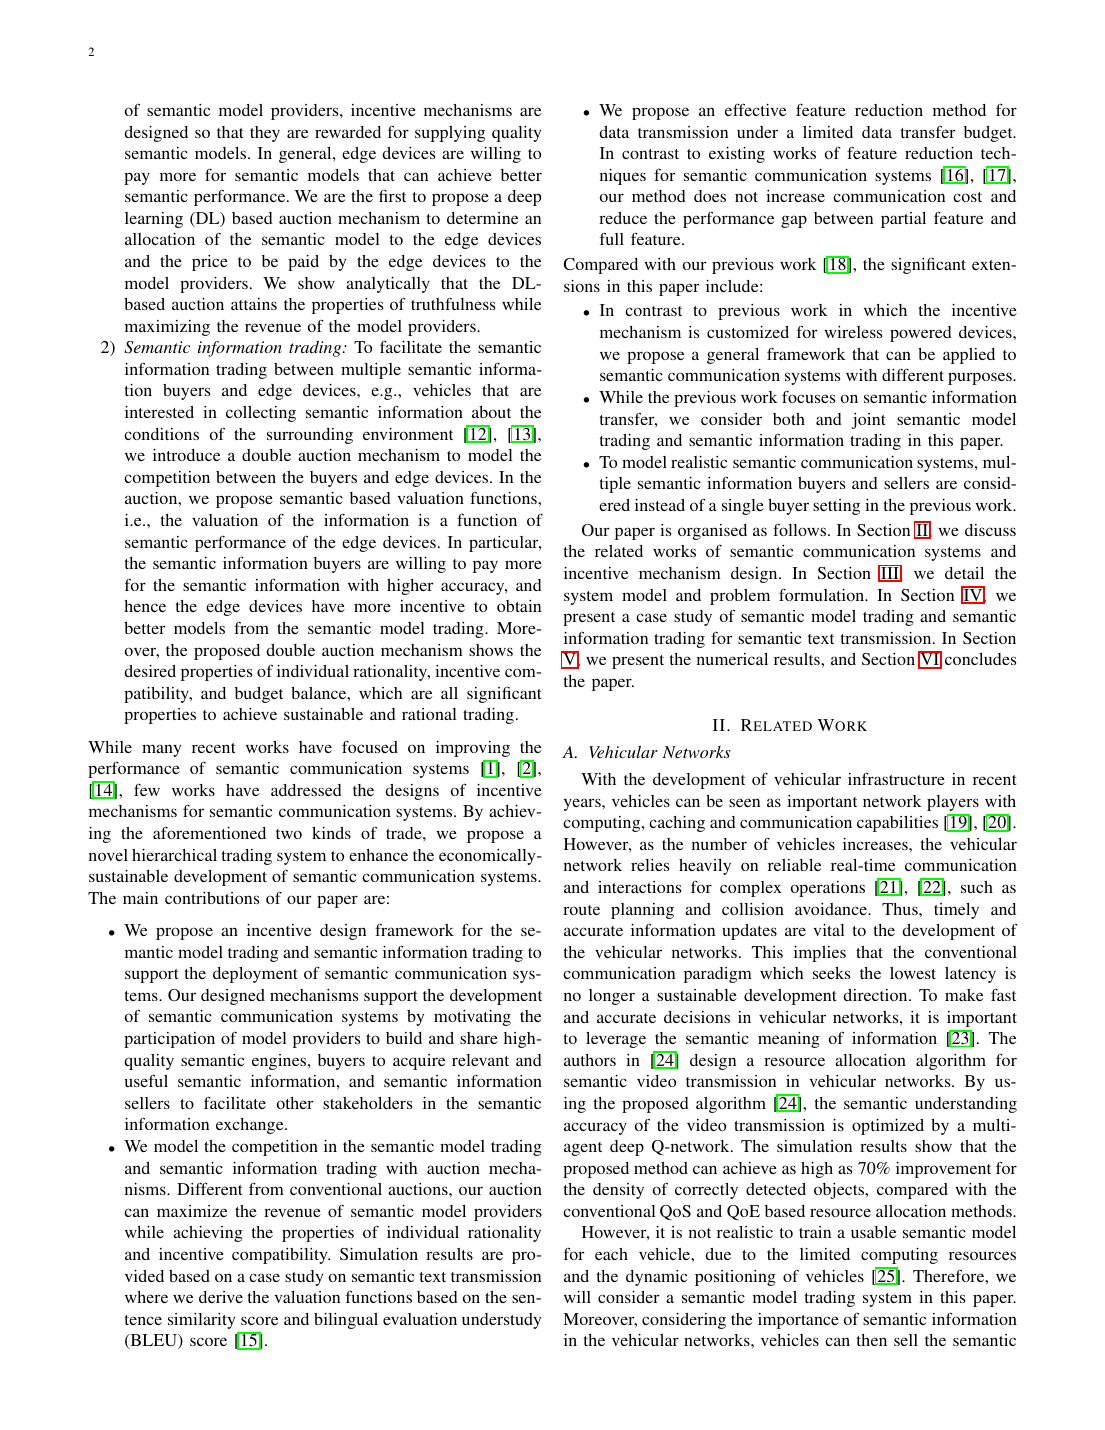
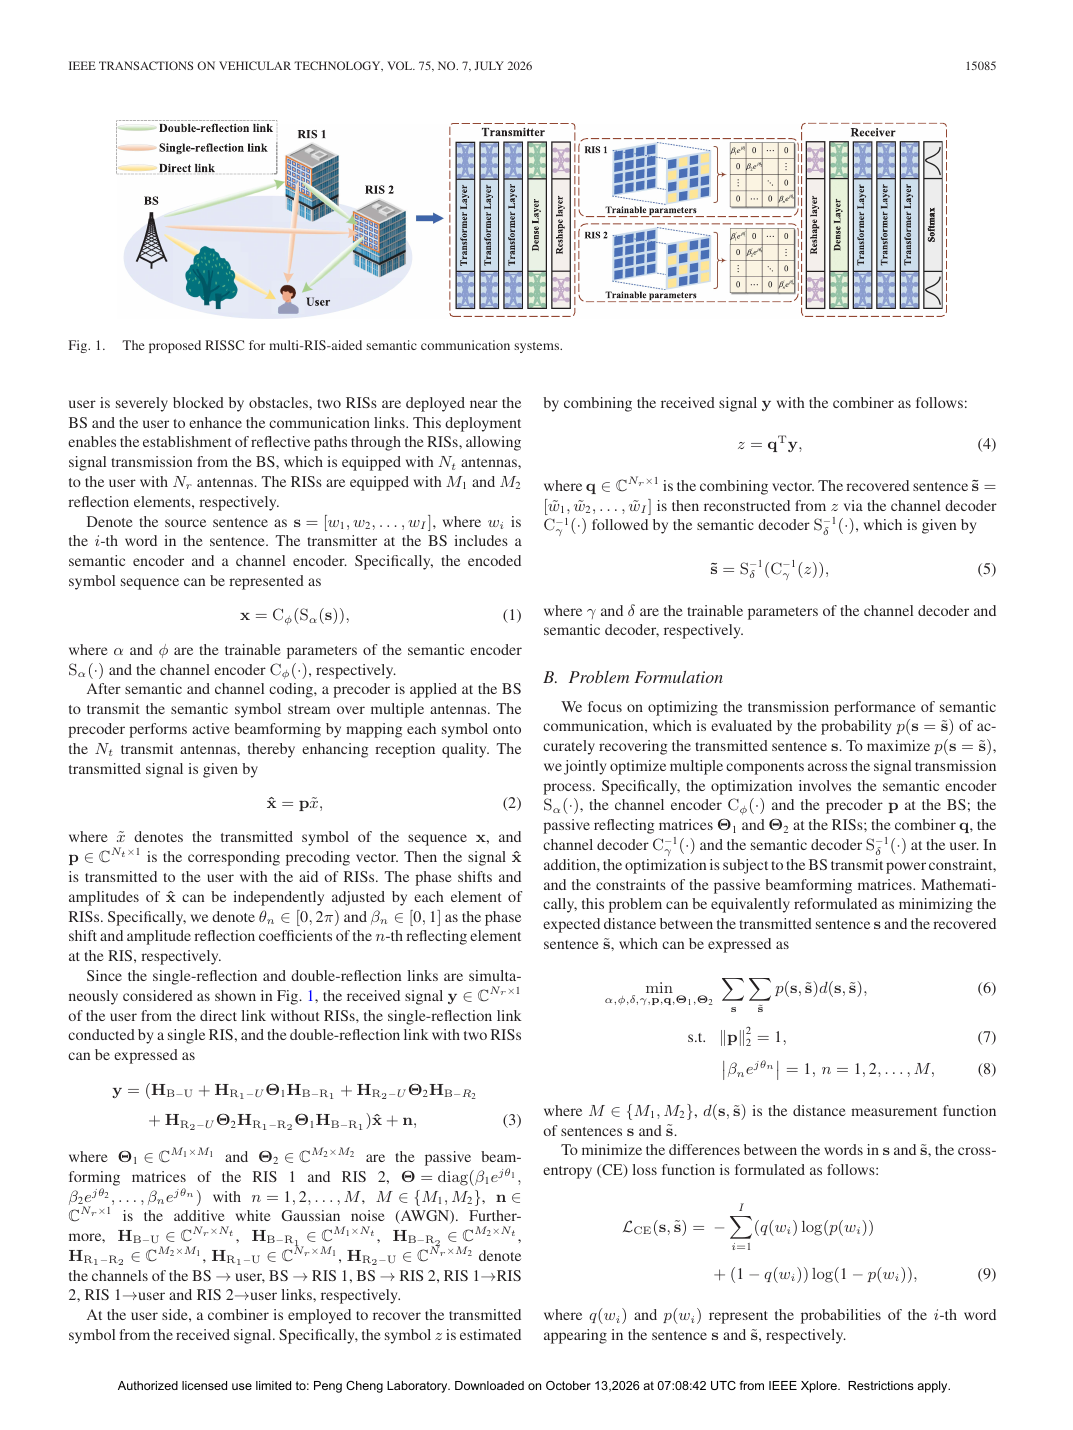
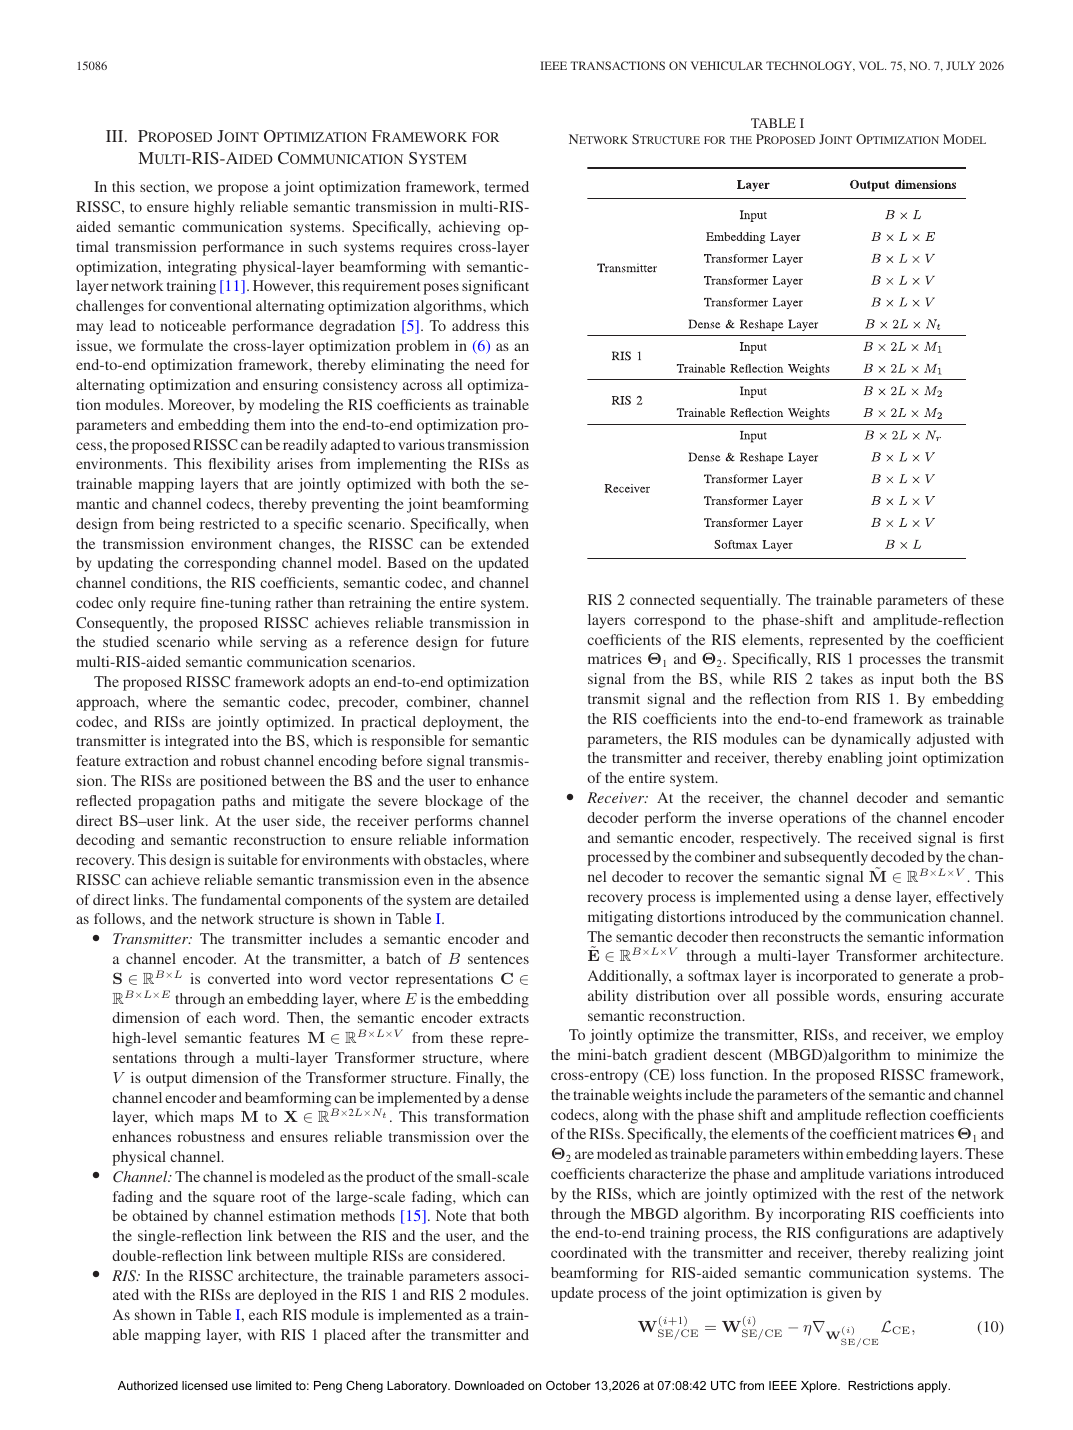
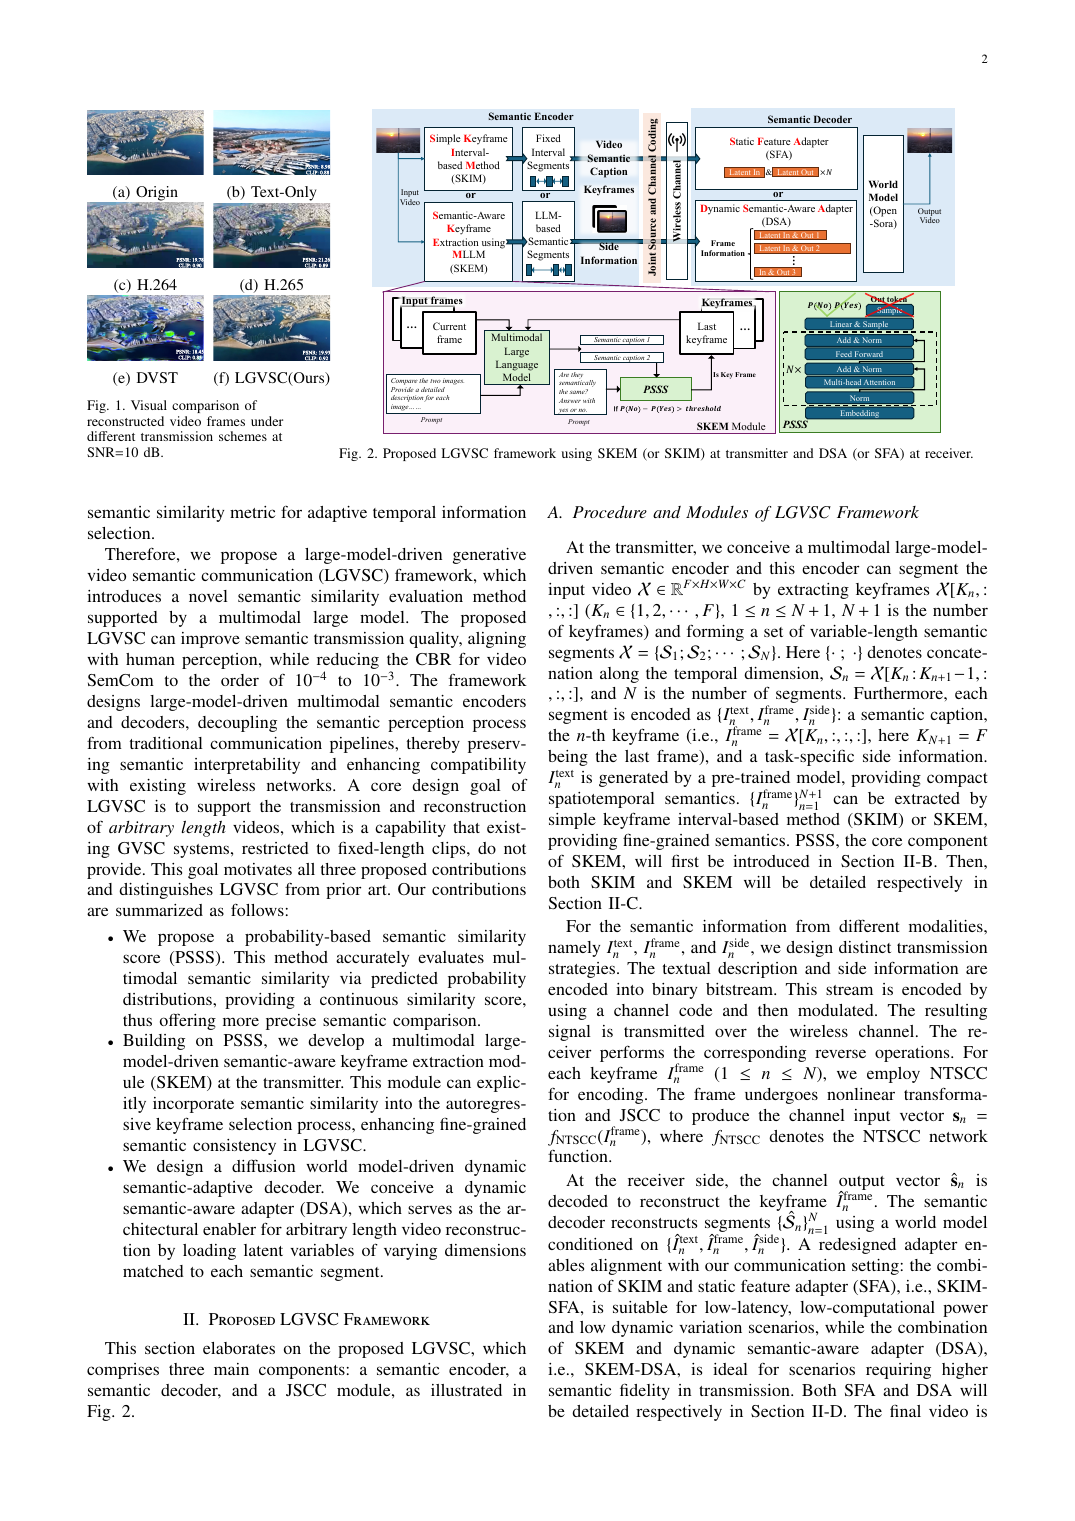
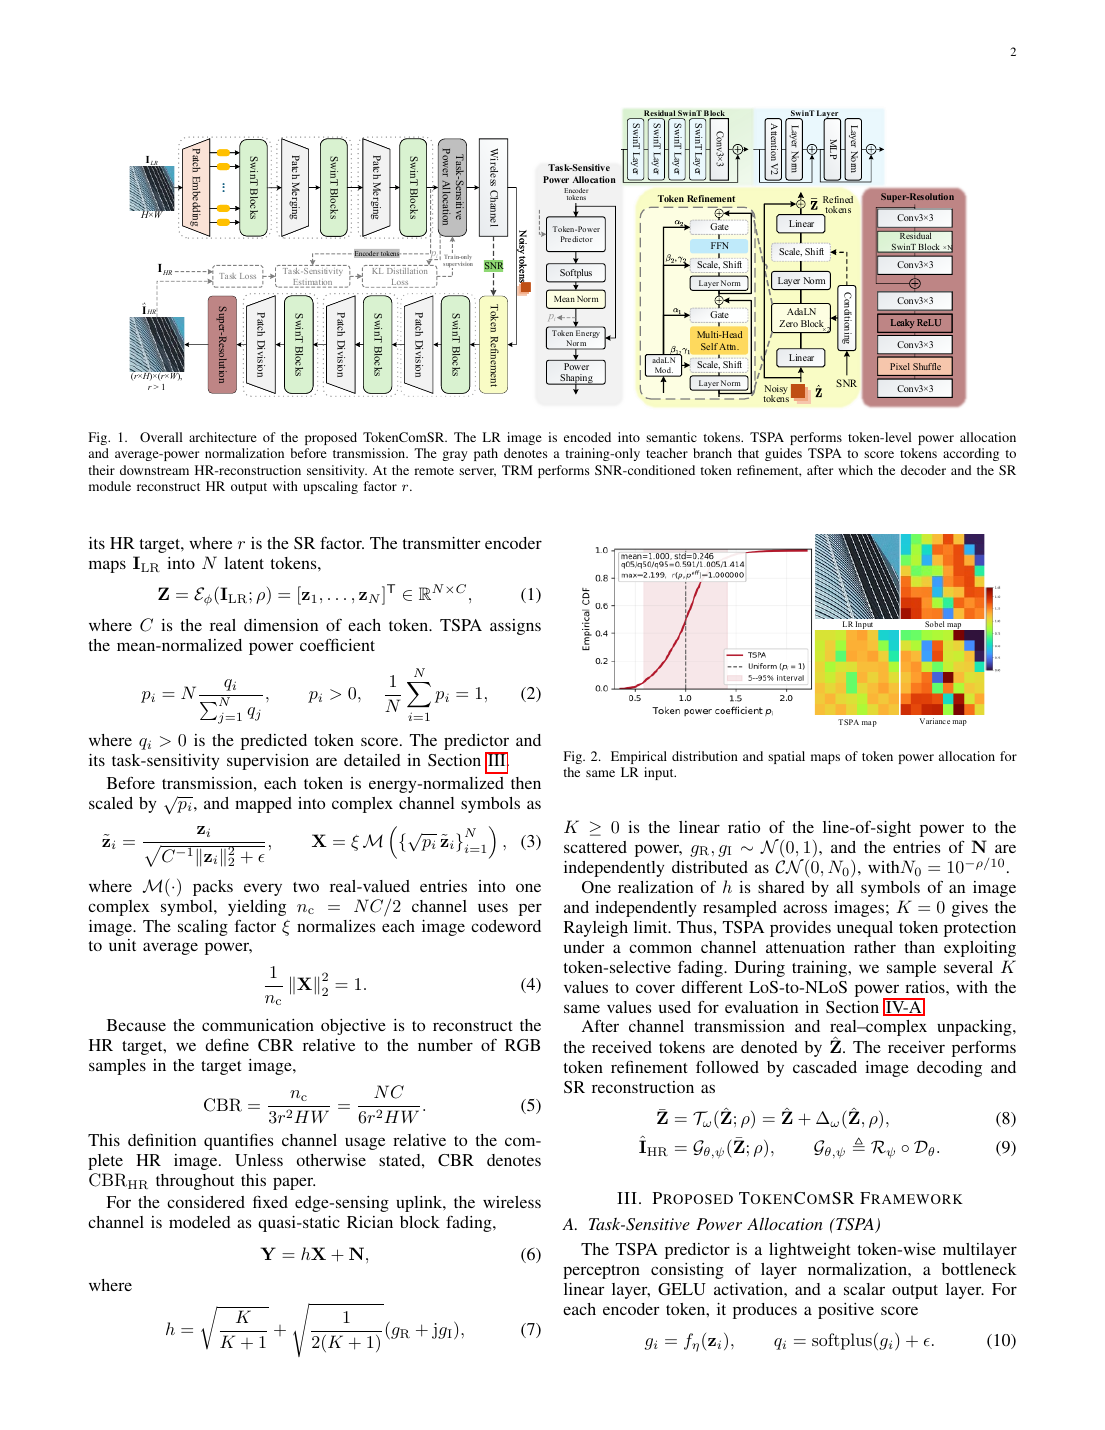
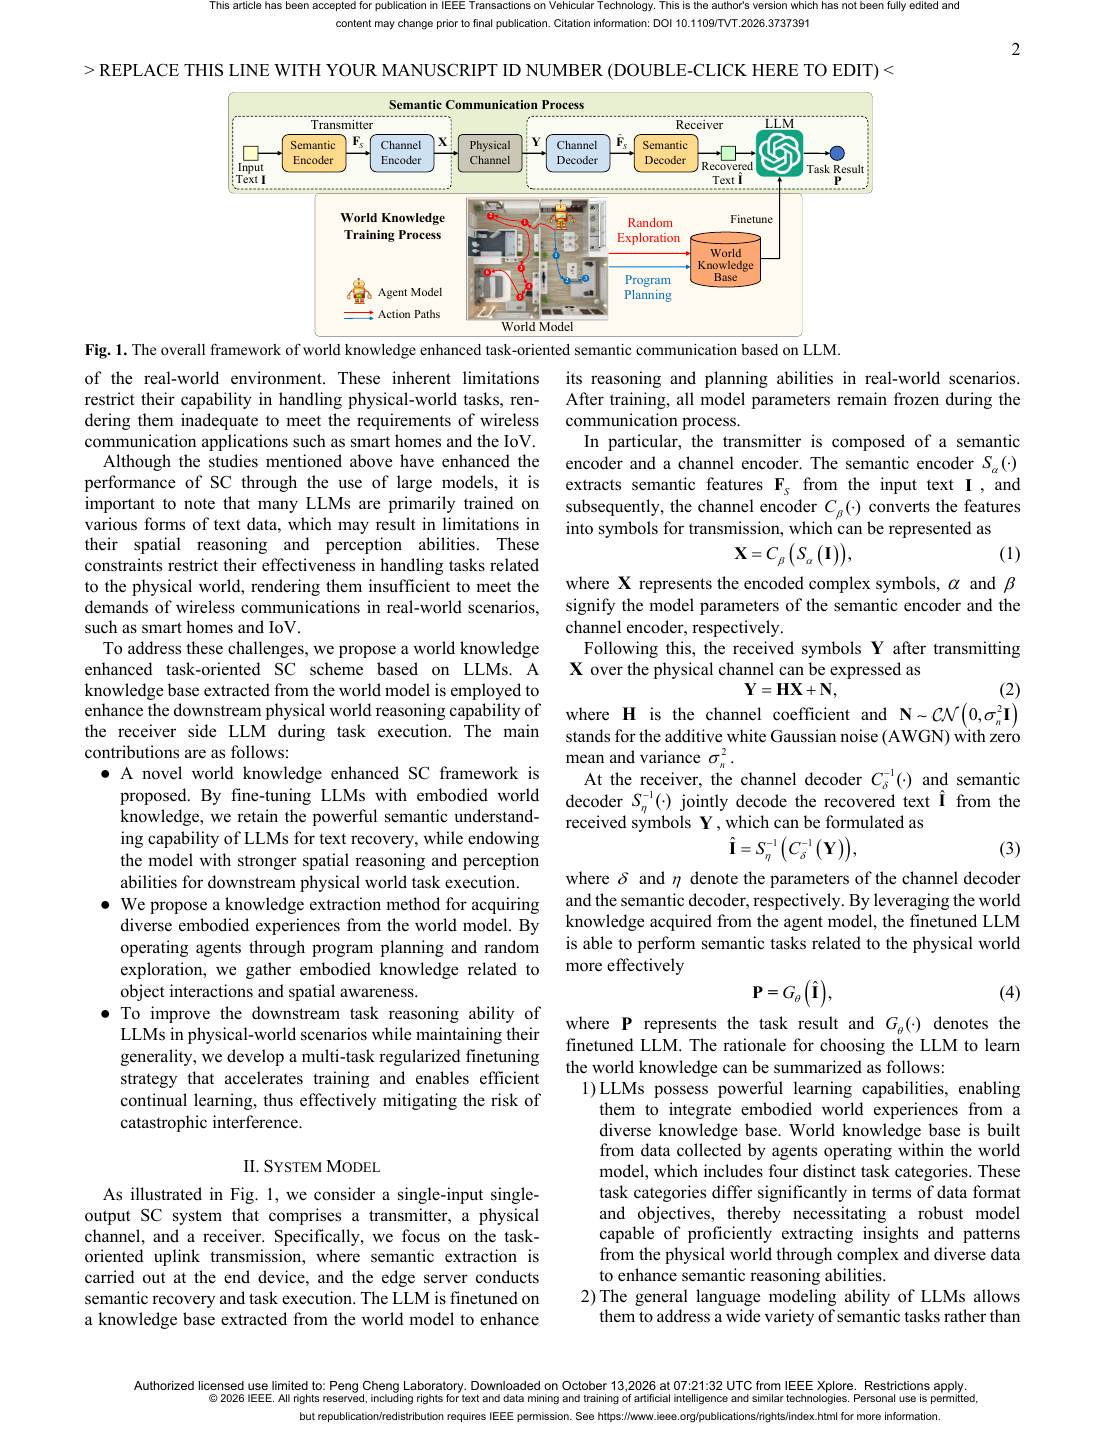
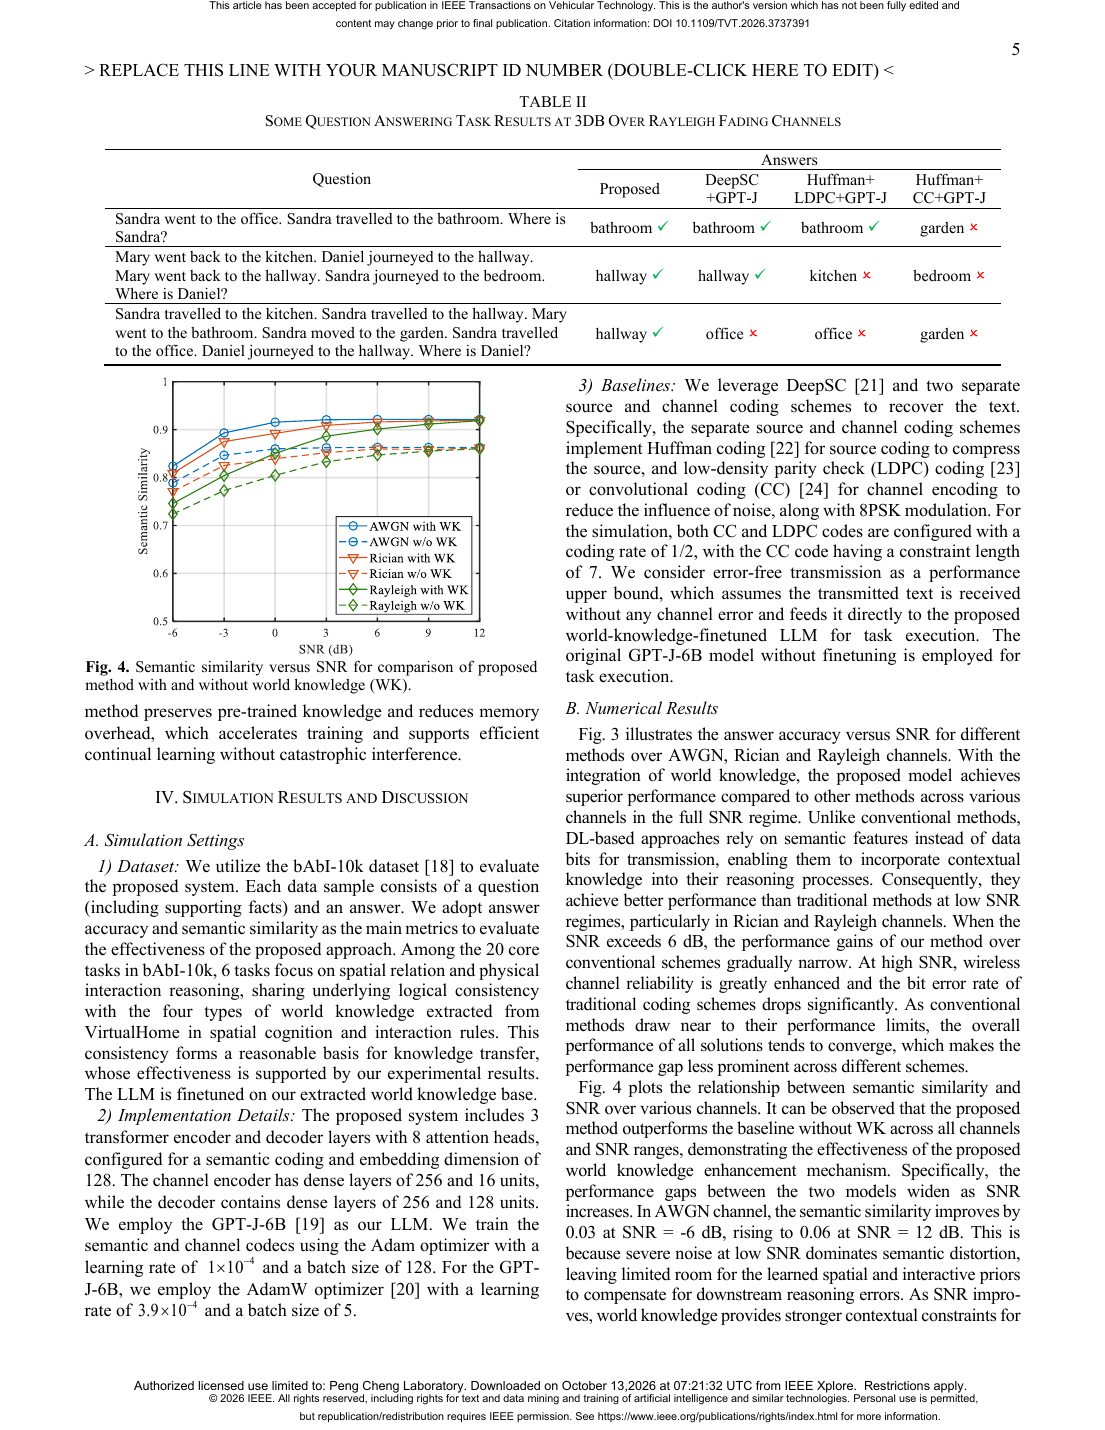
架构/方法图|来源:《Economics of Semantic Communication System: An Auction Approach》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Economics of Semantic Communication System: An Auction Approach》,原 PDF p.9,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2023语义信息度量与理论
Joint User Association and Bandwidth Allocation in Semantic Communication Networks
现有进展:语义通信(SemCom)被认为是保证未来无线网络高资源利用率和传输可靠性的一种有前途的解决方案。 PDF p.1
仍然存在的问题:但是,若要将本材料用于任何其他目的,必须通过向pubs-permission@ieee.org发送请求,从IEEE获得许可。 PDF p.1
为什么已有方法解决不了:不同论文各自报告准确率或重建指标,不能替代统一、可计算且与通信资源相联系的定义或可达界;缺失的是比较坐标而不是更深的网络。 PDF p.1
为什么这个问题重要:没有定义清楚的语义目标和资源坐标,就无法判断收益来自通信机制还是更换了数据集、模型或评价指标。 PDF p.1
本文提出什么:为此,本文从网络的角度对SemCom进行了研究,系统地讨论了SC-Net中的用户关联(UA)和带宽分配(BA)两个基本问题。 PDF p.1
方案为何可能有效:在此基础上,针对每个SC-Net场景,提出了一个UA和BA的联合STM最大化问题,并给出了相应的最优解。 PDF p.1
作者希望证明什么:然而,在SemCom-enabled网络(SC-Nets)中,对背景知识匹配的独特需求使得为多个用户实现高效的无线资源管理具有挑战性。 PDF p.1
方法与端到端信息流
为此,本文从网络的角度研究了SemCom,系统地研究了SC-Net中的用户关联(UA)和带宽分配(BA)这两个基本问题,并针对每种SC-Net场景建立了UA和BA的联合STM-最大化问题,给出了相应的最优解。我们的主要任务是在SemCom-enabled网络(SC-Net)中寻求最佳的无线资源管理策略,以语义感知的方式优化其整体网络性能。 PDF p.1PDF p.2
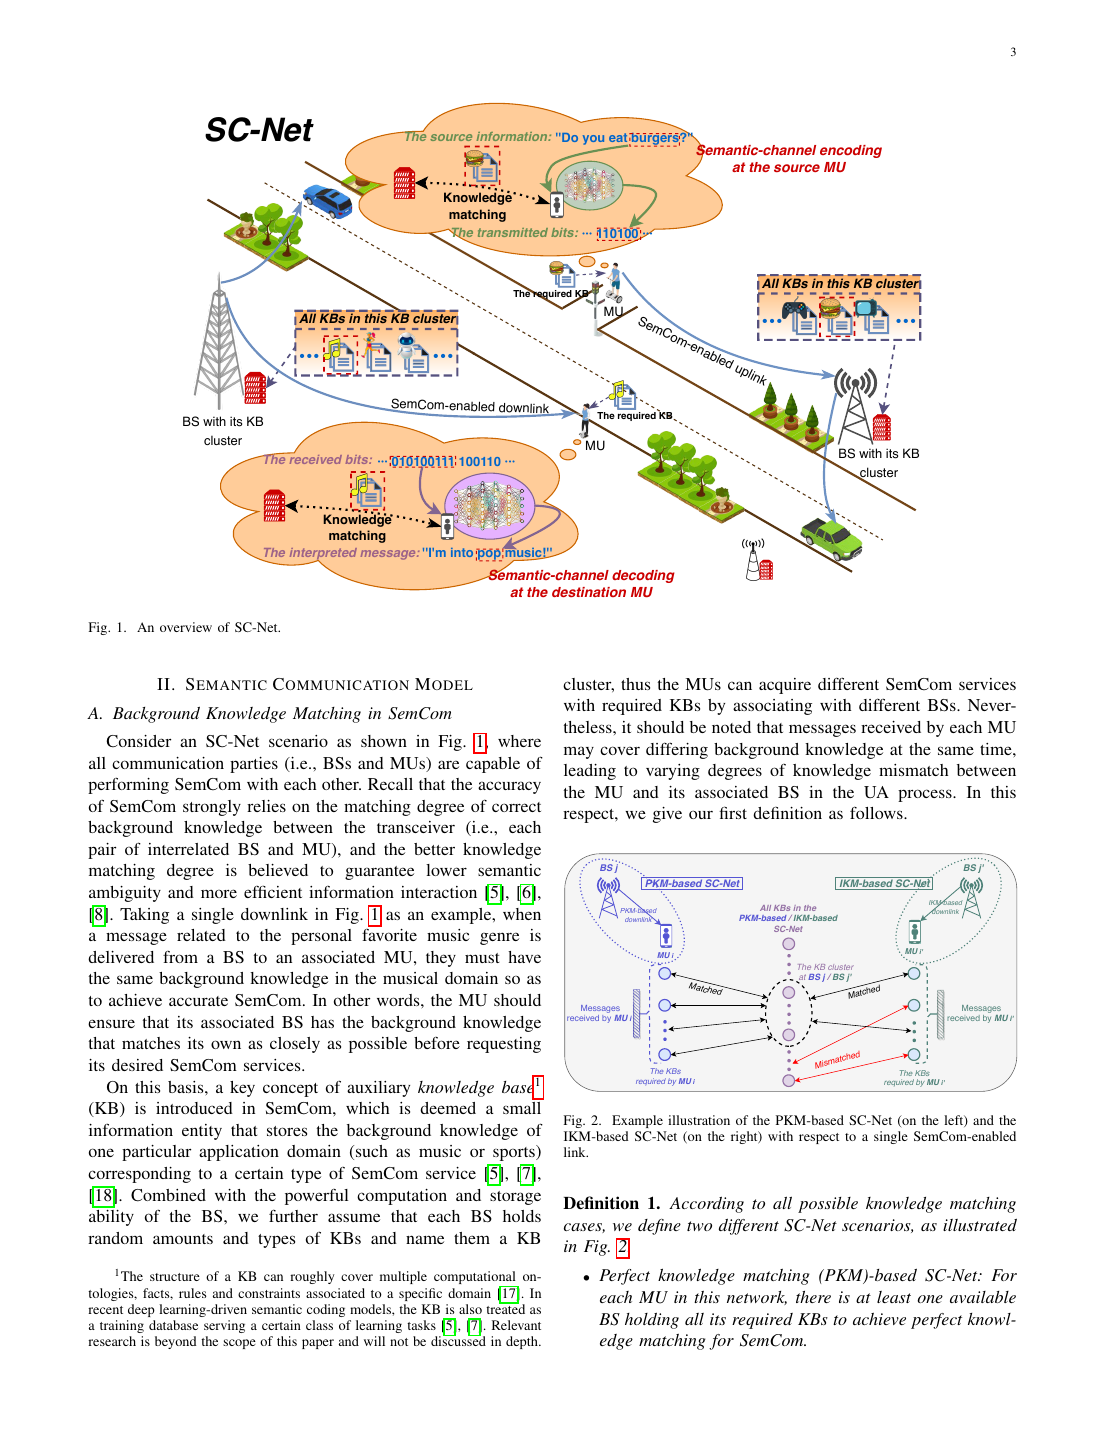
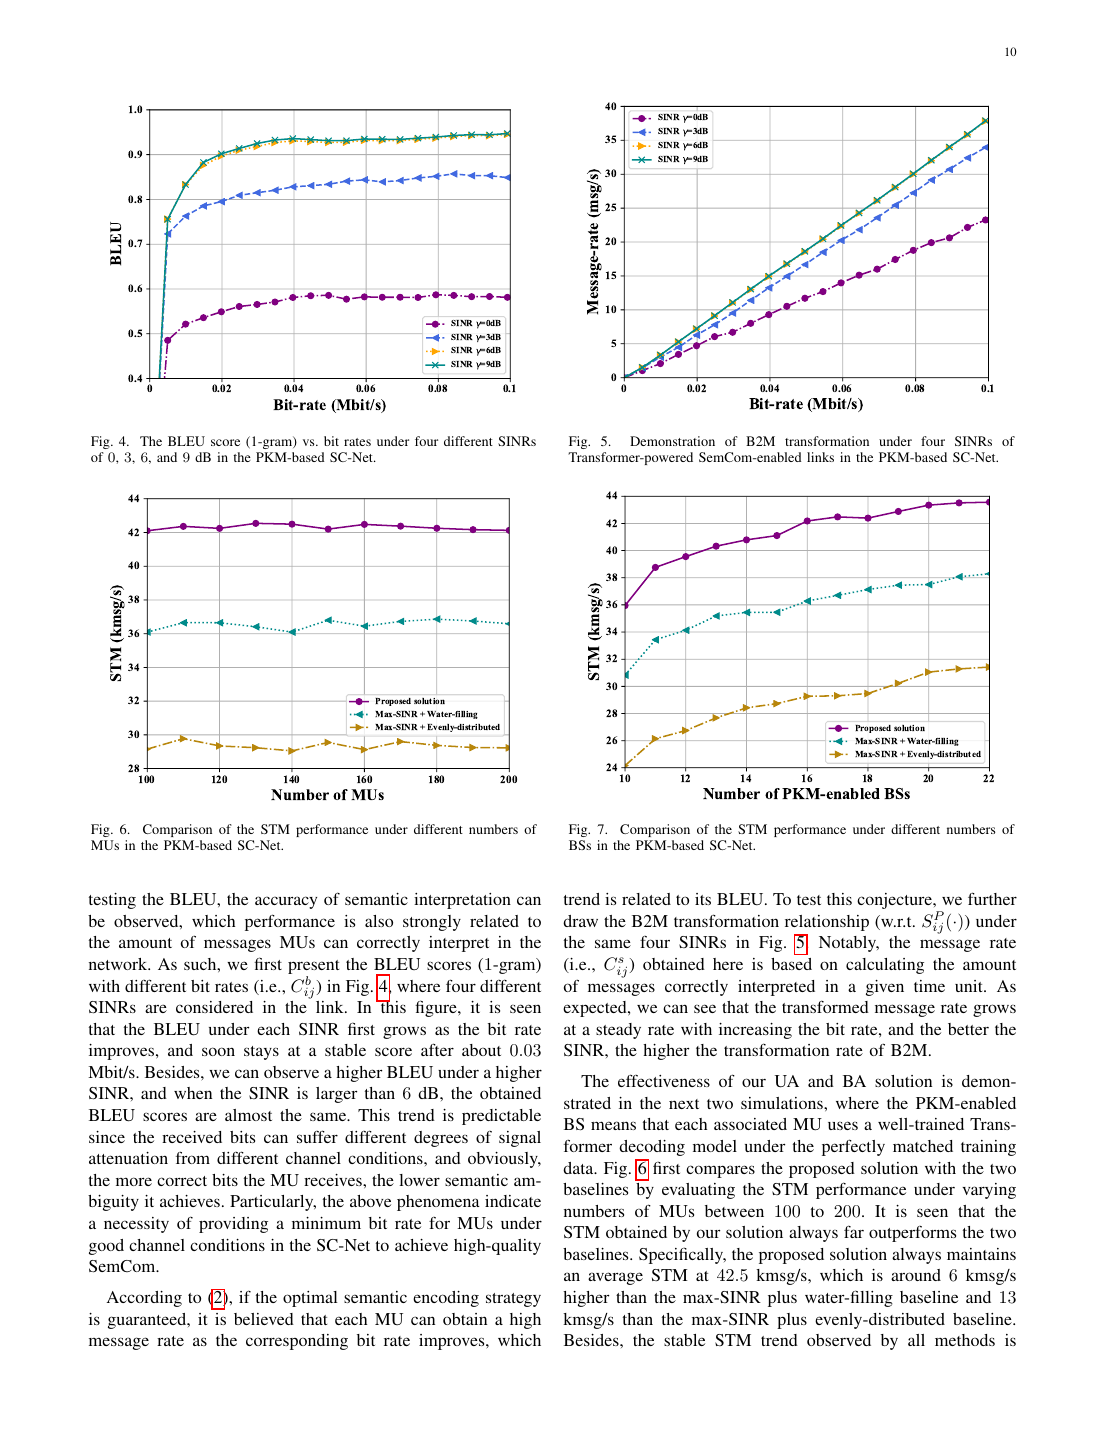
架构/方法图|来源:《Joint User Association and Bandwidth Allocation in Semantic Communication Networks》,原 PDF p.3,Fig. 1 An overview of SC-Net 核对论文关键实验结果图/表|来源:《Joint User Association and Bandwidth Allocation in Semantic Communication Networks》,原 PDF p.10,Fig. 6 Comparison of the STM performance under different numbers of MUs in the PKM-based SC-Net 核对论文
相关但非核心2023文本传输或语言任务
Knowledge-Aware Semantic Communication System Design and Data Allocation
架构/方法图|来源:《Knowledge-Aware Semantic Communication System Design and Data Allocation》,原 PDF p.11,Fig. 5b From the plot we observe that both the schemes outperform DeepSC 核对论文关键实验结果图/表|来源:《Knowledge-Aware Semantic Communication System Design and Data Allocation》,原 PDF p.11,Fig. 7a From this plot, we observe that the proposed scheme transmits a significantly smaller number of symbols compared with both schemes, from ρ = 0 to ρ = 0.6 核对论文
相关但非核心2023通用语义通信系统
LDPC Coded Compressive Sensing for Joint Source-Channel Coding in Wireless Sensor Networks
仍然存在的问题:然而,在实际应用中,无线传感器网络不仅面临着能量资源的限制,而且通信信道的不可靠性也是制约网络性能的重要因素,因此,将联合信源信道编码(Joint Source-Channel Coding,JSCC)与CS技术相结合,可以有效地提高无线传感器网络的性能。 PDF p.1
为什么已有方法解决不了:连续 latent 或独立设计的传统链路没有回答语义特征怎样量化、映射为有限符号,以及 bit/index 出错后为何不会跳到完全不同的语义。仅改进信源网络无法补上这一接口。 PDF p.1
为什么这个问题重要:语义质量必须在真实的带宽、功率和时延预算下成立,否则模型收益不能转化为通信系统收益。 PDF p.1
本文提出什么:更明确地说,我们将这一概念用于一个特定的方案,该方案使用少量的基于CS概念的物联网节点(IoTN)同时支持大量信号。 PDF p.1
方案为何可能有效:基于DP-LDPC码在JSCC中的优势,以及无线传感器网络在能量受限和通信信道不可靠的情况下的特殊特性,本文提出了一种CS-LDPC方案,该方案允许少量的IoTN观测到大量稀疏时变信号。 PDF p.2
作者希望证明什么:自然地,该增益是以使所提出的迭代联合LDPC-CS解码方案的复杂度近似加倍为代价来实现的。 PDF p.1
方法与端到端信息流
更明确地说,我们证明了这一概念的一个特定的计划,它支持大量的信号同时,使用少量的物联网节点(IoTN)的概念的基础上CS。受DP-LDPC码的优势JSCC和无线传感器网络的特殊属性,遭受约束的能源和不可靠的通信信道的启发,在本文中,我们提出了一种CS-LDPC方案,该方案允许少量的物联网节点观测到大量稀疏时变信号。受DP-LDPC码用于JSCC的优点以及无线传感器网络遭受能量资源受限和不可靠通信信道的特殊性质的启发,本文,我们设想了一种CS-LDPC方案,其允许少量的IoTN观察大量的稀疏时变信号。 PDF p.1PDF p.2
架构/方法图|来源:《LDPC Coded Compressive Sensing for Joint Source-Channel Coding in Wireless Sensor Networks》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《LDPC Coded Compressive Sensing for Joint Source-Channel Coding in Wireless Sensor Networks》,原 PDF p.13,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2023语义感知资源分配与网络优化
Mechanism Design for Semantic Communication in UAV-Assisted Metaverse: A Combinatorial Auction Approach
现有进展:语义通信在数据传输过程中利用深度神经网络对语义信息进行编码和解码,具有降低通信代价的优点,在抗噪性和节省资源方面表现出了良好的鲁棒性。 PDF p.1
仍然存在的问题:然而,为了提供真实的体验,VSP需要从无人机(UAV)等边缘设备收集最新的相关数据,这些数据对延迟敏感且资源密集。 PDF p.1
为什么已有方法解决不了:只按 bit rate、吞吐量或平均失真分配资源,无法区分不同样本和任务的语义价值;外层优化必须得到可用的语义效用—资源曲线。 PDF p.1
为什么这个问题重要:功率、带宽、算力和时延是共享资源;若调度器不知道语义效用,它可能增加吞吐量却没有改善任何用户真正关心的任务。 PDF p.1
本文提出什么:为了解决这一挑战,我们提出了一个语义通信框架,该框架利用场景图的提取和交易来降低通信成本,并促进Metaverse服务的数据传输。 PDF p.1
方案为何可能有效:这些模型不是为特定的通信系统设计的,因此我们可以将它们部署为Metaverse中大量不同应用程序和服务的语义编码器和解码器。 PDF p.2
作者希望证明什么:仿真实验表明,该系统在传输过程中仅使用12.5%的特征就能保持模型的平均查全率。 PDF p.1
方法与端到端信息流
为了解决这一挑战,我们提出了一个语义通信框架,该框架利用场景图的提取和交易来降低通信成本并促进Metaverse服务的数据传输。这些模型不是为特定的通信系统设计的,因此我们可以将它们部署为Metaverse中大量不同应用程序和服务的语义编码器和解码器。为了解决这些挑战,在本文中,我们提出了一个用于Metaverse的语义通信框架,其中数据传输和交易被联合考虑,以经济有效的方式维持物理和虚拟世界之间的同步。 PDF p.1PDF p.2
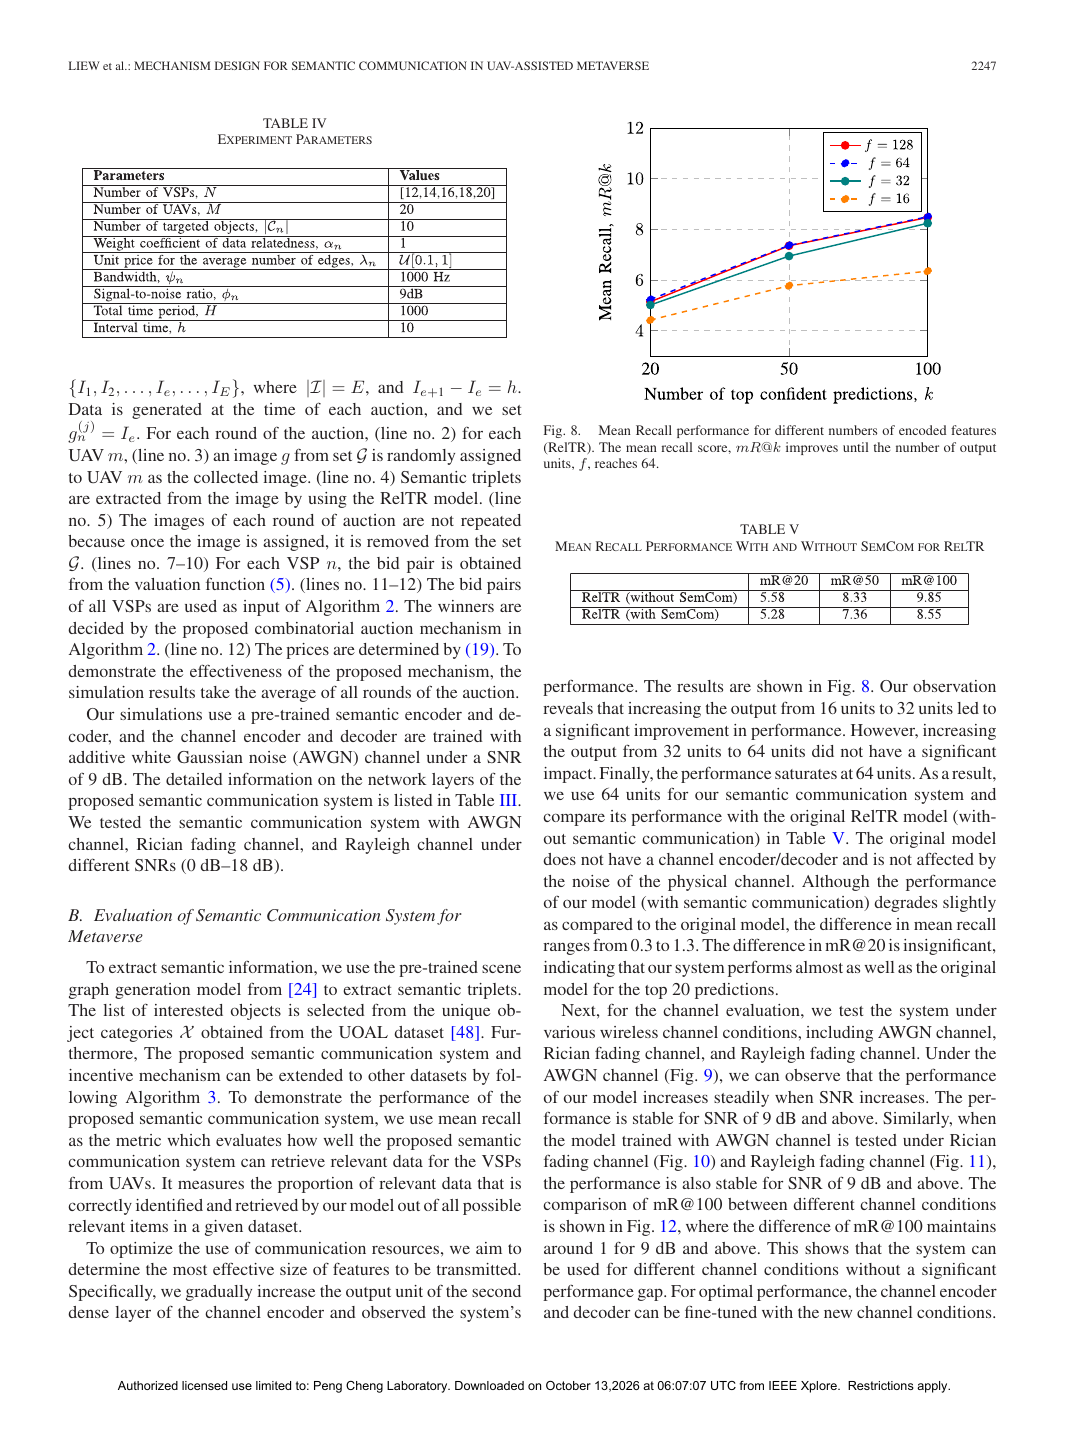
架构/方法图|来源:《Mechanism Design for Semantic Communication in UAV-Assisted Metaverse: A Combinatorial Auction Approach》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Mechanism Design for Semantic Communication in UAV-Assisted Metaverse: A Combinatorial Auction Approach》,原 PDF p.12,Fig. 8 Mean Recall performance for different numbers of encoded features (RelTR) 核对论文
相关但非核心2023语义感知资源分配与网络优化
Semantic Communication-Based Dynamic Resource Allocation in D2D Vehicular Networks
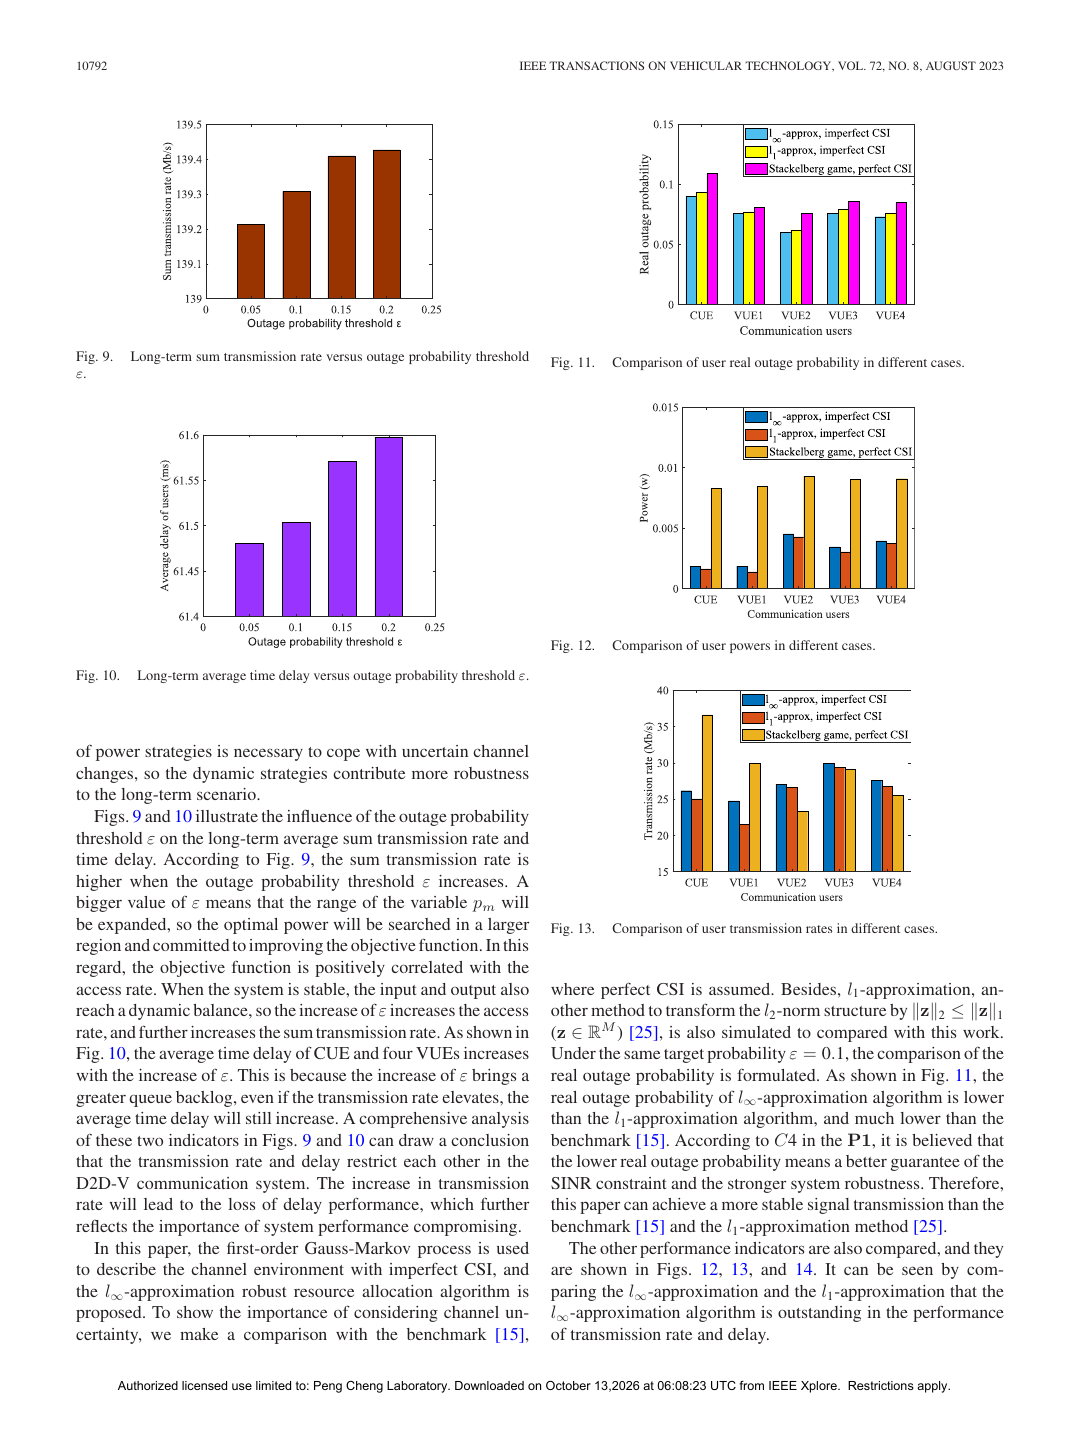
架构/方法图|来源:《Semantic Communication-Based Dynamic Resource Allocation in D2D Vehicular Networks》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Semantic Communication-Based Dynamic Resource Allocation in D2D Vehicular Networks》,原 PDF p.9,Fig. 12 Comparison of user powers in different cases 核对论文
核心纳入2023语音/音频传输或识别
Understand-Before-Talk (UBT): A Semantic Communication Approach to 6G Networks
仍然存在的问题:然而,相对于通信的目的,它们对于可能在实时约束内的多模态数据可能是不切实际的。 PDF p.1
为什么已有方法解决不了:只优化合法接收端的重建或任务 loss,并不会自动消除 latent 泄露、窃听或操纵风险;缺少的是把攻击者与保护目标放进同一系统模型。 PDF p.1
为什么这个问题重要:语音的可懂度、识别正确率与波形误差并不总是同步,少量包丢失也可能破坏整段语言内容;有限码率下应优先保护语言与说话人语义。 PDF p.1
本文提出什么:为此,大多数新兴的SC作品都专注于特定的数据类型,并采用复杂的机器学习模型,包括深度学习和神经网络。 PDF p.1
方案为何可能有效:I-B和II-A,我们的目标是为SC开发一种准确的语义提取方法,以促进6G网络上的联合优化(信息收集,信息传播和决策)。 PDF p.2
作者希望证明什么:这种方法可以动态地最大化6G网络的效用,显著降低采样率和工厂侧的相应能耗,这对于工业4.0系统中的低功耗和能量收集传感器至关重要。 PDF p.8
方法与端到端信息流
为此,大多数新兴的SC作品都专注于特定的数据类型,并采用复杂的机器学习模型,包括深度学习和神经网络。I-B和II-A,我们的目标是为SC开发准确的语义提取方法,以促进联合优化I-B和II-A,我们的目标是为SC开发一种精确的语义提取方法,以促进6G网络上的联合优化(信息收集、信息分发和决策)。 PDF p.1PDF p.2
架构/方法图|来源:《Understand-Before-Talk (UBT): A Semantic Communication Approach to 6G Networks》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Understand-Before-Talk (UBT): A Semantic Communication Approach to 6G Networks》,原 PDF p.7,该页包含论文的关键实验结果图或表。 核对论文
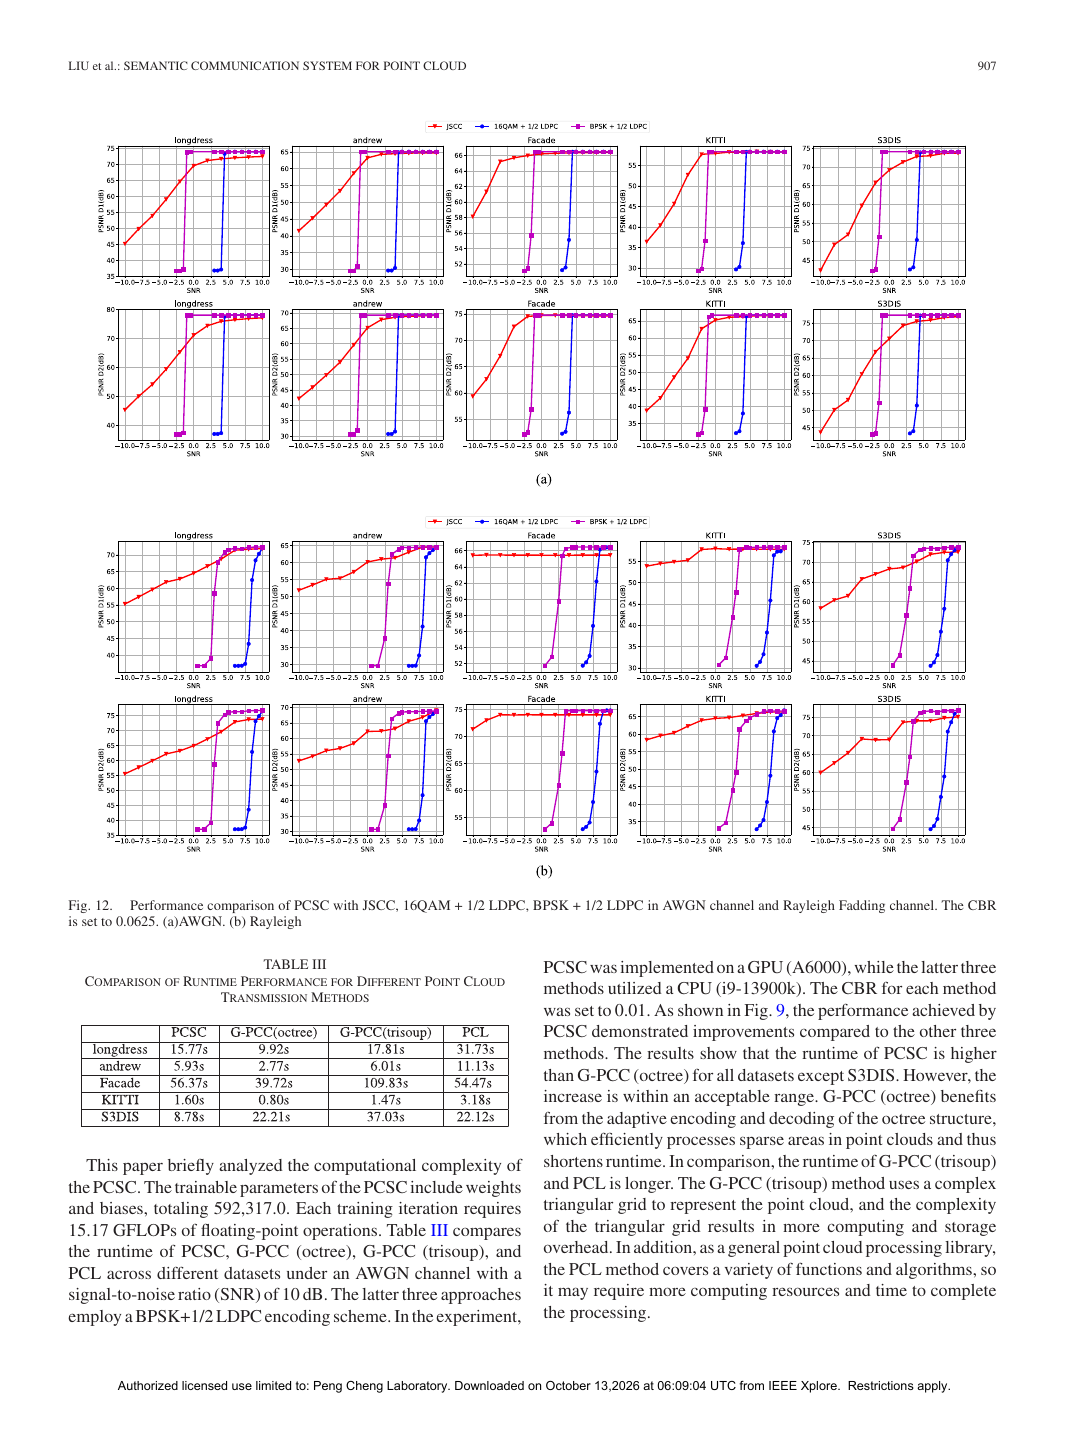
信道与工作点AWGN、Rayleigh、SNR = 10 dB、SNR=10 dB、SNR of 10 dB、at 0 dB SNR
数据集为ShapeNet、S3DIS、KITTI、UVG;实验小节中明确出现的比较对象包括DeepSC、JSCC、LDPC、ResNet;指标包括PSNR、MSE、mAP、PER;信道/链路条件包括AWGN、Rayleigh;正文可定位的代表性工作点有SNR = 10 dB、SNR=10 dB、SNR of 10 dB、at 0 dB SNR。 PDF p.10
实验结果表明,在PSNR D1和PSNR D2指标下,该方法比传统方法提高了10 dB,同时有效地抑制了传输中的“悬崖效应”,并且VSV和VGSV方法在文本、图像和视频中的性能都略高于基于熵的方法。 PDF p.1PDF p.12
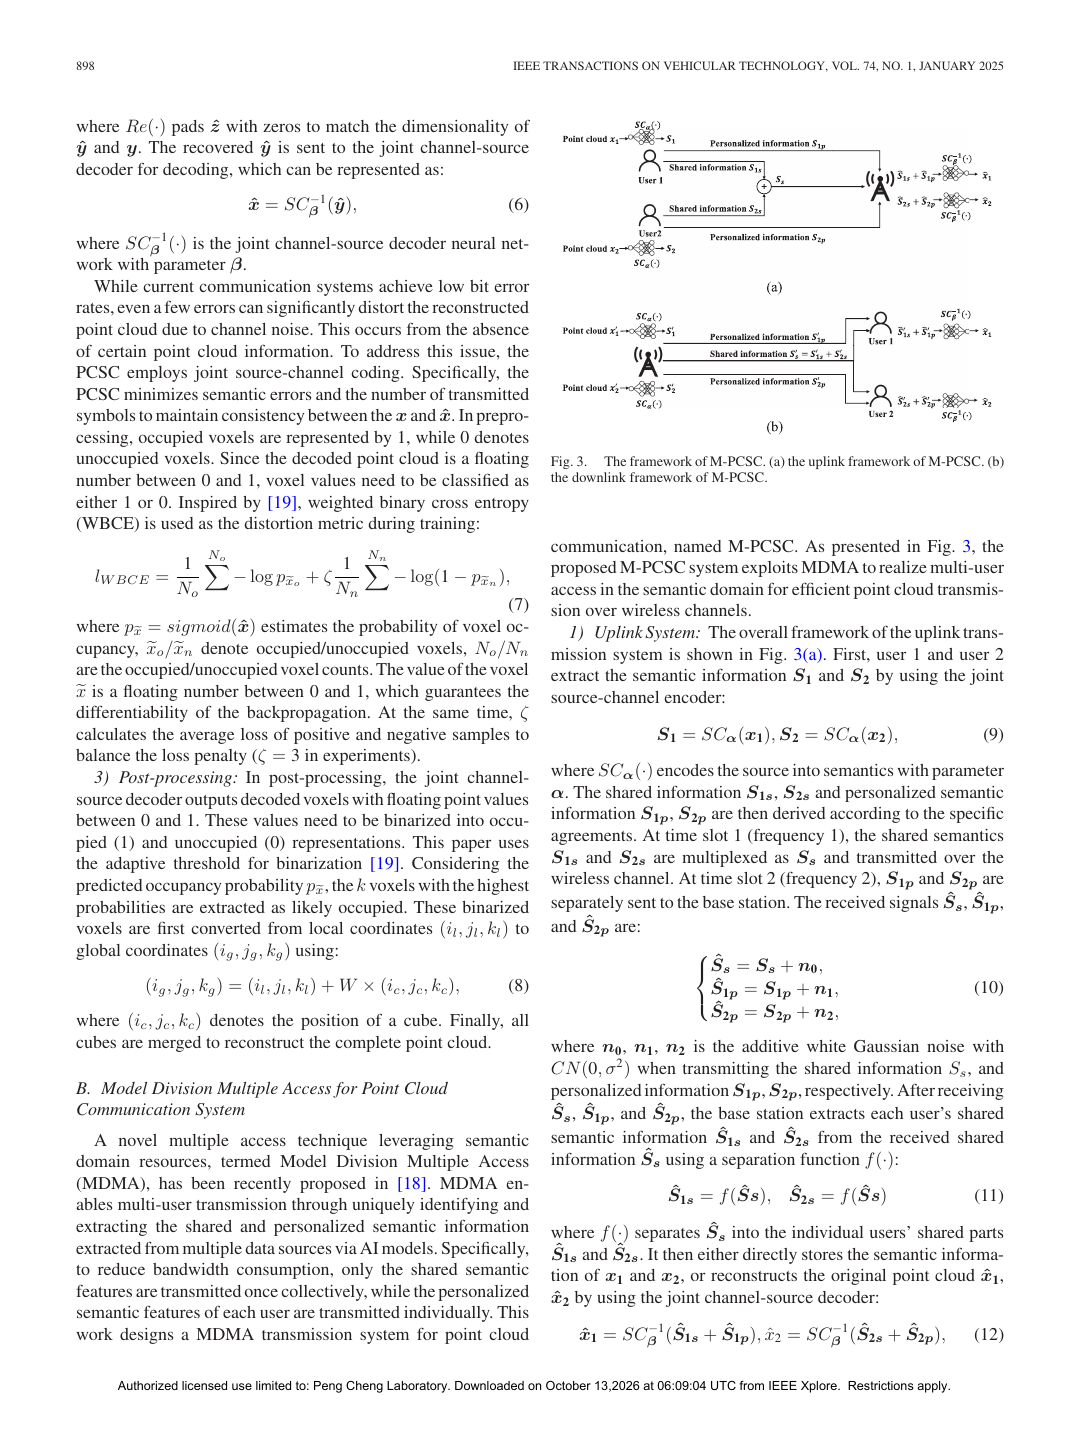
架构/方法图|来源:《A Semantic Communication System for Point Cloud》,原 PDF p.5,Fig. 3 The framework of M-PCSC 核对论文关键实验结果图/表|来源:《A Semantic Communication System for Point Cloud》,原 PDF p.14,Fig. 12 Performance comparison of PCSC with JSCC, 16QAM + 1/2 LDPC, BPSK + 1/2 LDPC in AWGN channel and Rayleigh Fadding channel 核对论文
相关但非核心2024边缘学习与任务通信
An Efficient Federated Learning Framework for Training Semantic Communication Systems
仍然存在的问题:然而,上述工作都没有解决与这种语义通信系统的训练过程相关联的数据隐私问题,这造成了显著的缺点。 PDF p.1
为什么已有方法解决不了:只优化合法接收端的重建或任务 loss,并不会自动消除 latent 泄露、窃听或操纵风险;缺少的是把攻击者与保护目标放进同一系统模型。 PDF p.1
为什么这个问题重要:梯度或中间特征既大又易受噪声影响,通信错误会直接改变训练收敛或推理决策;这使空口聚合与任务 loss 必须一起考虑。 PDF p.1
本文提出什么:此外,我们设计我们的系统,以降低通信开销,减少信息量交付的每一轮FL训练。 PDF p.1
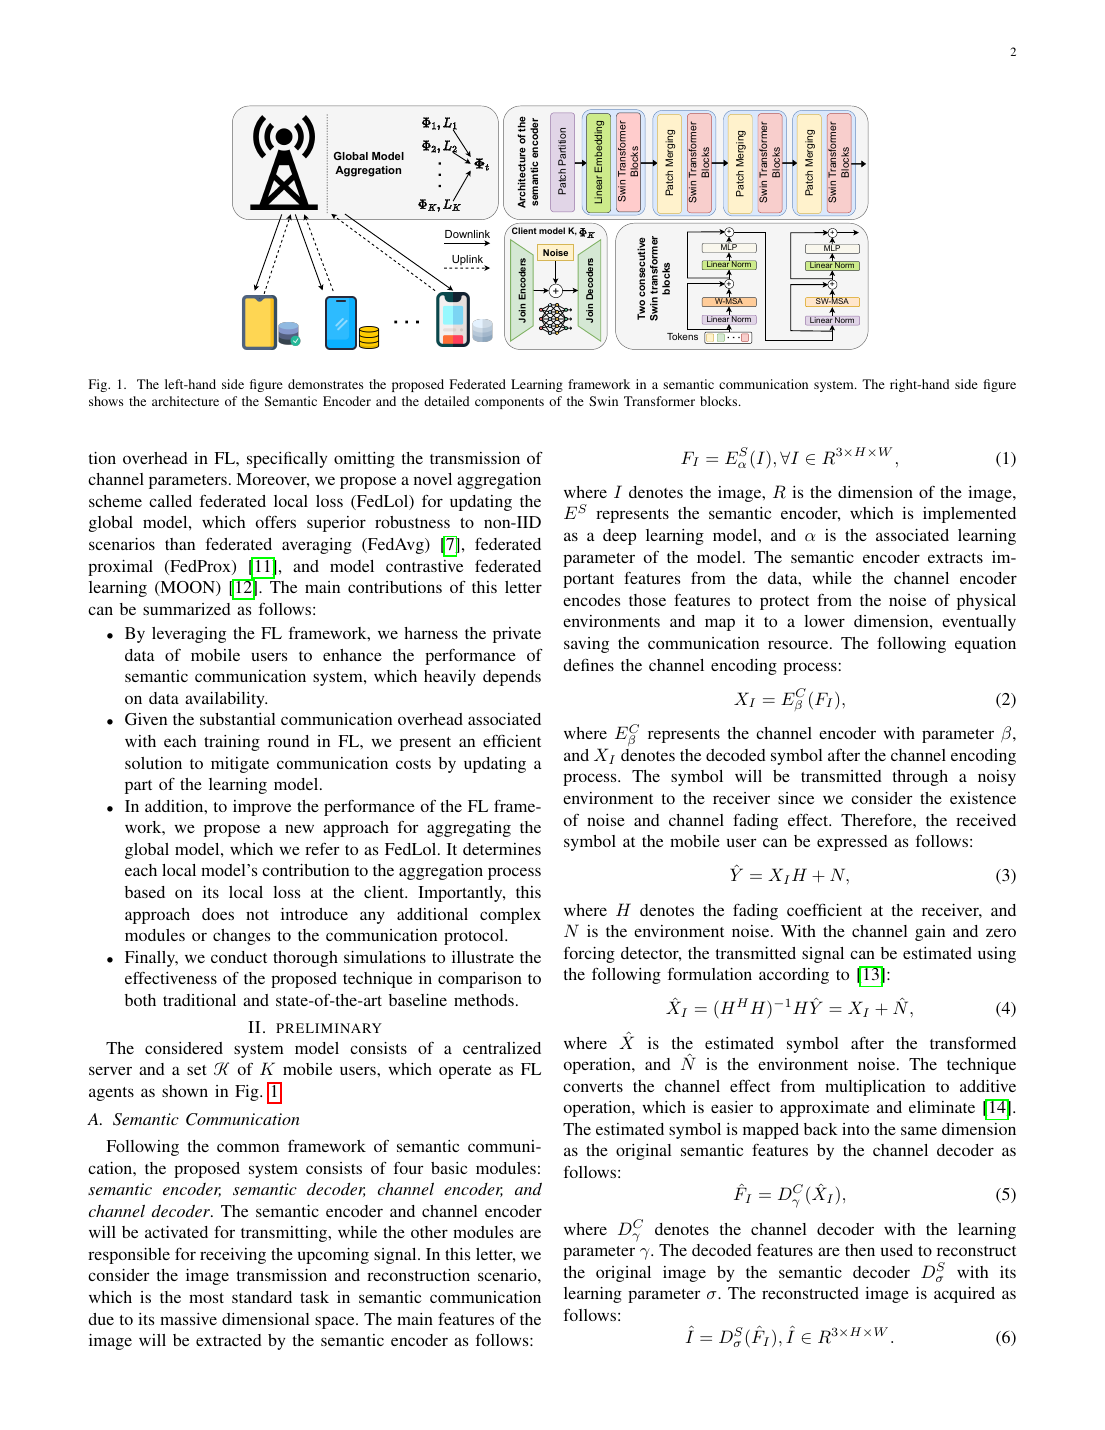
方案为何可能有效:左侧的图展示了在语义通信系统中提出的联邦学习框架。 PDF p.2
作者希望证明什么:一系列仿真实验验证了所提算法的有效性。 PDF p.1
方法与端到端信息流
另外,我们设计了一个系统,通过减少每个FL训练轮中传递的信息量来降低通信开销。左图展示了在语义通信系统中提出的联邦学习框架。 PDF p.1PDF p.2
输入输入是边缘学习与任务通信所需的梯度、模型更新或中间特征。
发送端发送端采用 An Efficient Federated Learning Framework for Training Semantic Communication Systems:另外,我们设计了一个系统,通过减少每个FL训练轮中传递的信息量来降低通信开销。左图展示了在语义通信系统中提出的联邦学习框架。
实际发送实际发送对象是语义 feature 或未完整规定 bit 映射的 latent。
信道信道作用方式按“类别 0:信道作用点不足,或由外部传统链路抽象承担”解释。
接收端接收端从论文假设已经恢复的语义特征开始,再执行语义解码、任务推理或生成。
输出最终输出为聚合模型或边缘推理结果。
它在通信系统中的位置:把窃听、攻击或隐私泄露纳入语义链路,同时考察合法端质量与攻击端获得的信息。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:语义 feature/latent;量化到 bitstream 的接口未完整报告
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“语义 feature/latent;量化到 bitstream 的接口未完整报告”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:An Efficient Federated Learning Framework for Training Semantic Communication Systems 的主传输单位属于“语义 feature/latent;量化到 bitstream 的接口未完整报告”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
论文未同时报告输入尺寸、encoder 输出尺寸、量化精度/码本大小和帧级开销,因此不能从全文唯一重建总 bit 数。页面保留论文实际使用的 CBR、bpp、token 数或信道使用次数;缺失项不作臆测。 PDF p.2PDF p.3
架构/方法图|来源:《An Efficient Federated Learning Framework for Training Semantic Communication Systems》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《An Efficient Federated Learning Framework for Training Semantic Communication Systems》,原 PDF p.3,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2024图像传输、压缩或生成
An Image Adaptive Rate Mechanism in Semantic Communication for Image Endogenous Semantics
现有进展:尽管深度学习在语义通信方面取得了进展,但传统的固定长度编码无法充分解决语义内容的可变复杂性,通常会导致关键细微差别的丢失和通信准确性的降低。 PDF p.1
仍然存在的问题:针对这些挑战,我们的工作引入了一种创新的自适应速率编码机制,该机制捕获图像的内在语义,并根据语义互连概率微调编码速率。 PDF p.1
为什么已有方法解决不了:分离压缩与信道编码优化的是中间 bit 可靠性,未必等价于本文关心的语义/任务质量;反过来,只做端到端网络而不交代带宽、功率和信道作用点也无法形成公平通信比较。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
本文提出什么:目前的方法还引入了不必要的冗余,损害了传输效率。 PDF p.1
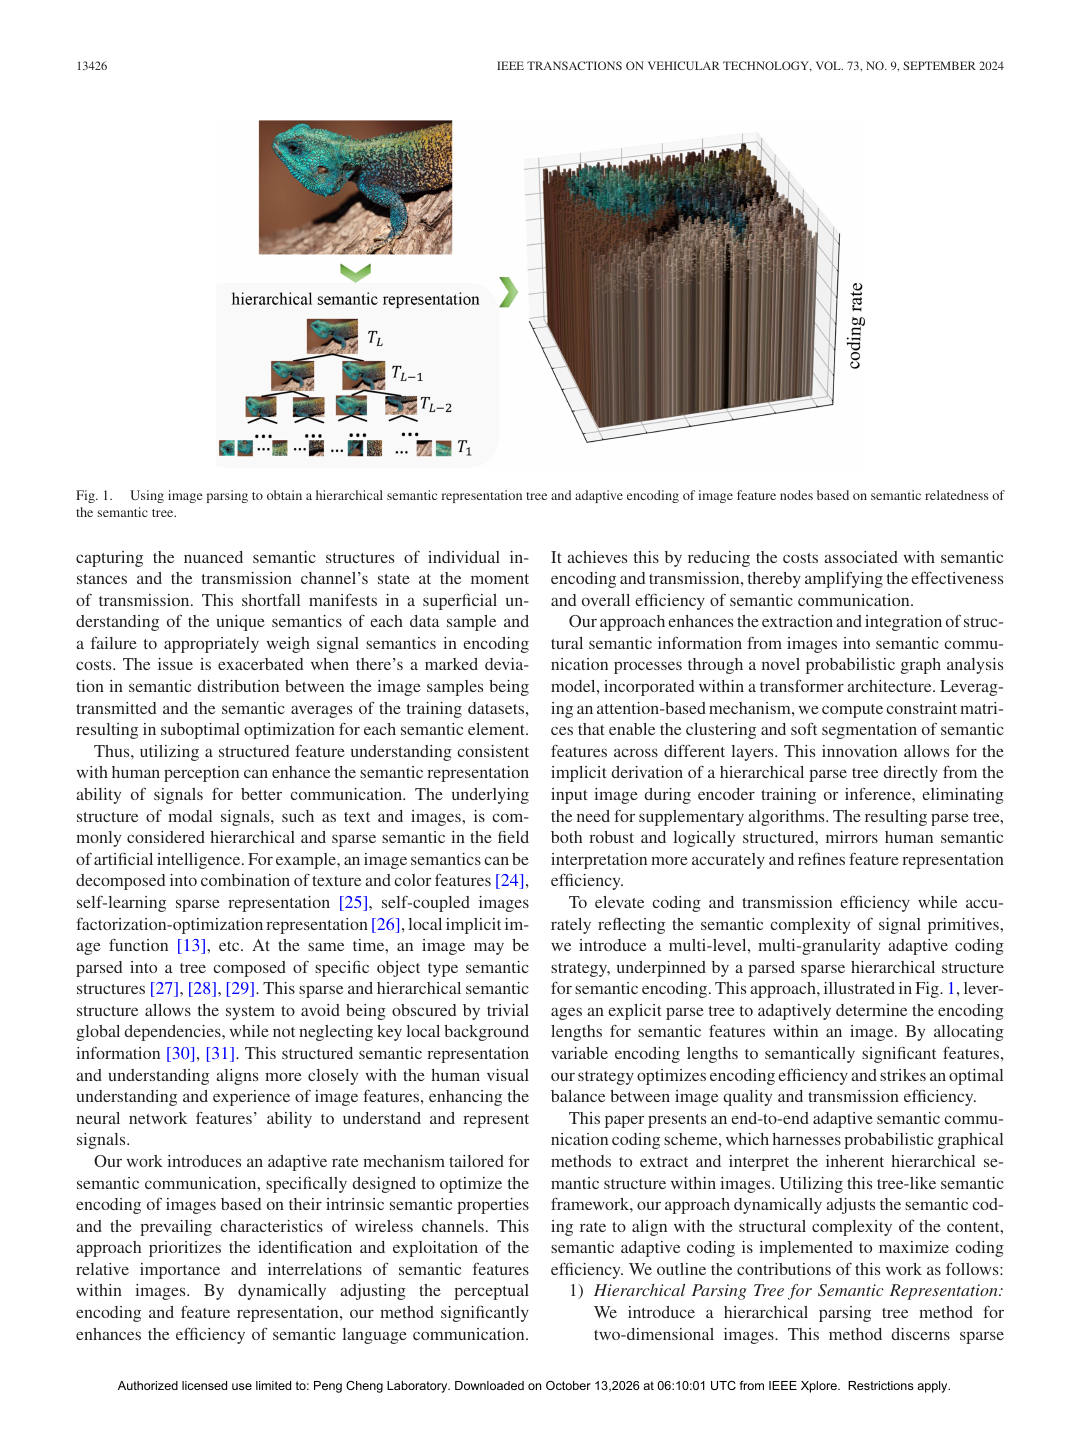
方案为何可能有效:我们的工作介绍了一种自适应速率机制,专门设计用于语义通信,优化编码的图像的基础上,其内在的语义属性和无线信道的普遍特点。 PDF p.2
作者希望证明什么:该方法不仅改进了现有的语义保真度指标,但也减少了传输复杂图像的比特需求。 PDF p.1
方法与端到端信息流
当前的方法也引入了不必要的冗余,损害了传输效率。我们的工作引入了一个自适应的速率机制为语义通信量身定制,专门设计来优化编码的图像的基础上,其内在的语义属性和无线信道的主要特点。 PDF p.1PDF p.2
输入输入是图像传输、压缩或生成所需的图像及其视觉/任务语义。
发送端发送端采用 An Image Adaptive Rate Mechanism in Semantic Communication for Image Endogenous Semantics:当前的方法也引入了不必要的冗余,损害了传输效率。我们的工作引入了一个自适应的速率机制为语义通信量身定制,专门设计来优化编码的图像的基础上,其内在的语义属性和无线信道的主要特点。
实际发送实际发送对象是功率归一化的实数或复数神经信道符号。
信道信道作用方式按“类别 3:连续语义变量直接经过有噪声信道并端到端恢复”解释。
接收端接收端从AWGN/衰落作用后的带噪连续符号开始,再执行语义解码、任务推理或生成。
输出最终输出为重建/生成图像或视觉任务输出。
它在通信系统中的位置:在同一系统中共同设计压缩、语义保真和抗信道噪声机制。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:连续神经 JSCC latent / 实复信道符号
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“连续神经 JSCC latent / 实复信道符号”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:An Image Adaptive Rate Mechanism in Semantic Communication for Image Endogenous Semantics 的主传输单位属于“连续神经 JSCC latent / 实复信道符号”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
在训练方面,利用GPU图形内存比较大的优势,在训练阶段将图像随机裁剪为256 × 256,并且将每个补丁的分辨率设置为(16 × 16),我们的批量大小仍然可以达到180,这有助于提高梯度下降算法的稳定性。 PDF p.8
换算边界:连续 latent 未规定每个符号的 bit-depth,不能无条件换算为 bit rate。
信道怎样作用,以及 decoder 实际拿到什么
信道处理类别:类别 3:连续语义变量直接经过有噪声信道并端到端恢复
我们使用加性白色高斯噪声和瑞利衰落信道来模拟真实的无线通信中的信道条件。 信道处理归类为“类别 3:连续语义变量直接经过有噪声信道并端到端恢复”。 PDF p.5
语义 decoder 实际面对的是:AWGN/衰落作用后的带噪连续符号。 PDF p.5
是否真正处理离散变量出错:不适用 VQ index 跳变。论文处理的是连续噪声/衰落;这不能自动证明量化和调制后的数字链路鲁棒性。
实验设置与主要结论
数据集/场景CIFAR-10、Kodak、CLIC、DIV2K
BaselineBPG、JSCC、LDPC、QAM
评价指标PSNR、SSIM、MS-SSIM、MSE、accuracy、mAP、PER
信道与工作点AWGN、Rayleigh、fading channel、SNR of 10 dB、SNR=10 dB
数据集为CIFAR-10、Kodak、CLIC、DIV2K;实验小节中明确出现的比较对象包括BPG、JSCC、LDPC、QAM;指标包括PSNR、SSIM、MS-SSIM、MSE、accuracy、mAP、PER;信道/链路条件包括AWGN、Rayleigh、fading channel;正文可定位的代表性工作点有SNR of 10 dB、SNR=10 dB。 PDF p.9
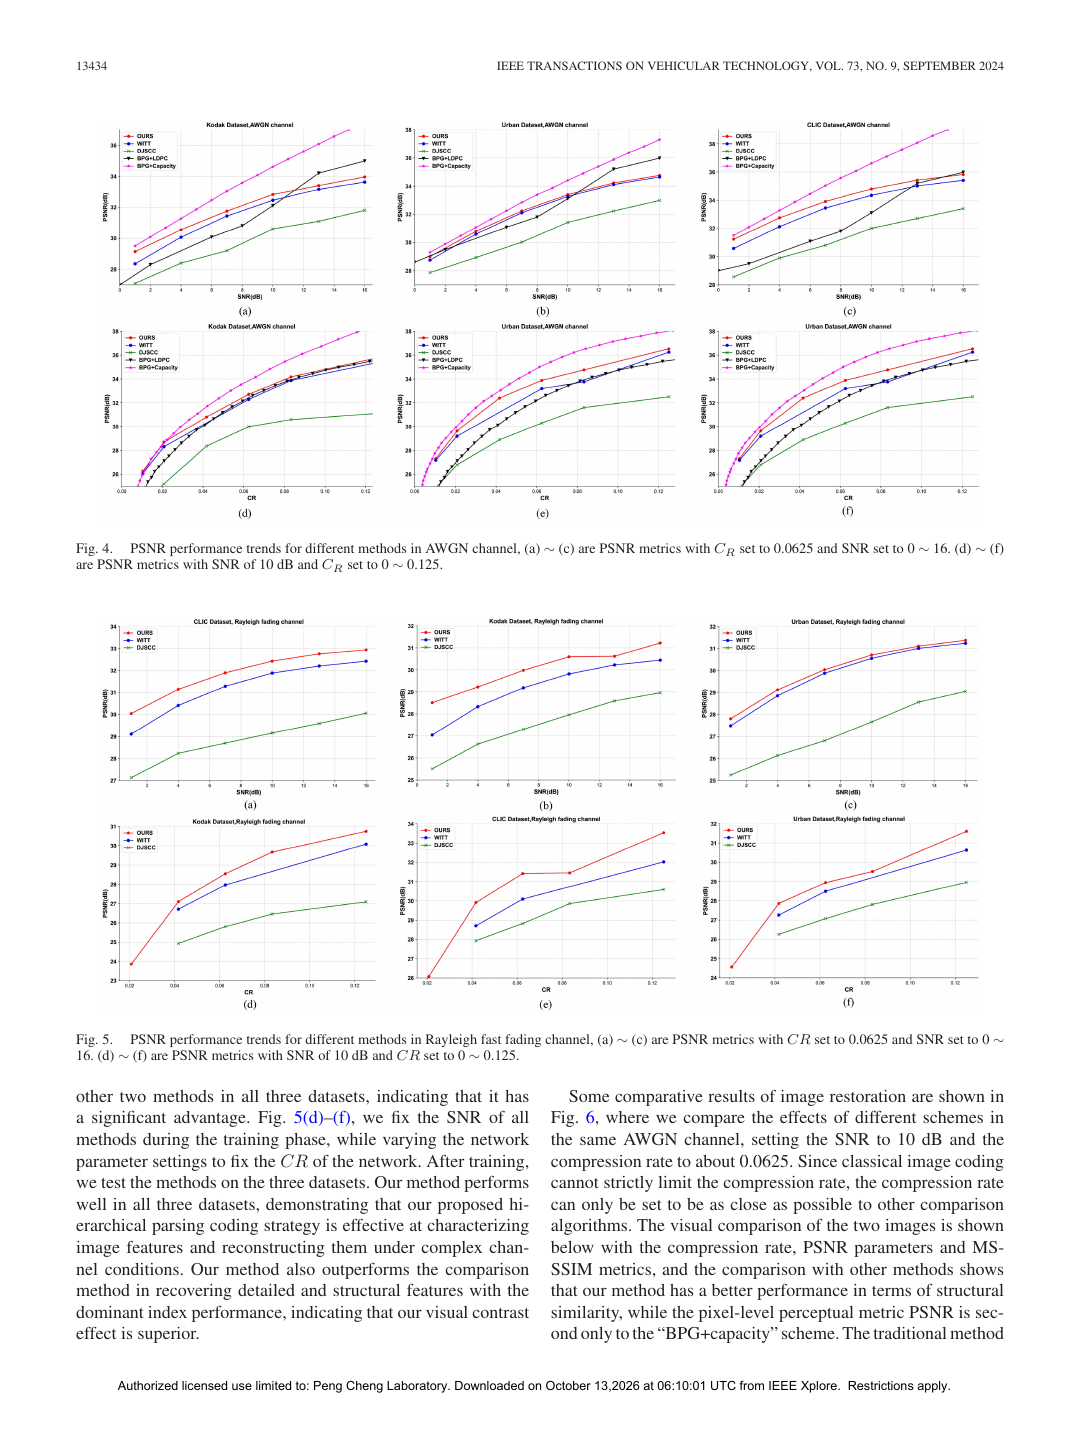
该方法不仅改进了现有的语义保真度指标,而且降低了传输复杂图像的比特需求,可以看出,我们的方法也优于同类型的深度学习方法,并且在更苛刻的压缩率条件下,我们的算法优势更加明显,算法性能更接近“BPG+capacity”方案的容量。 PDF p.1PDF p.9
架构/方法图|来源:《An Image Adaptive Rate Mechanism in Semantic Communication for Image Endogenous Semantics》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《An Image Adaptive Rate Mechanism in Semantic Communication for Image Endogenous Semantics》,原 PDF p.10,Fig. 4 PSNR performance trends for different methods in AWGN channel, (a) ∼ (c) are PSNR metrics with CR set to 0.0625 and SNR set to 0 ∼ 16 核对论文
核心纳入2024图像传输、压缩或生成
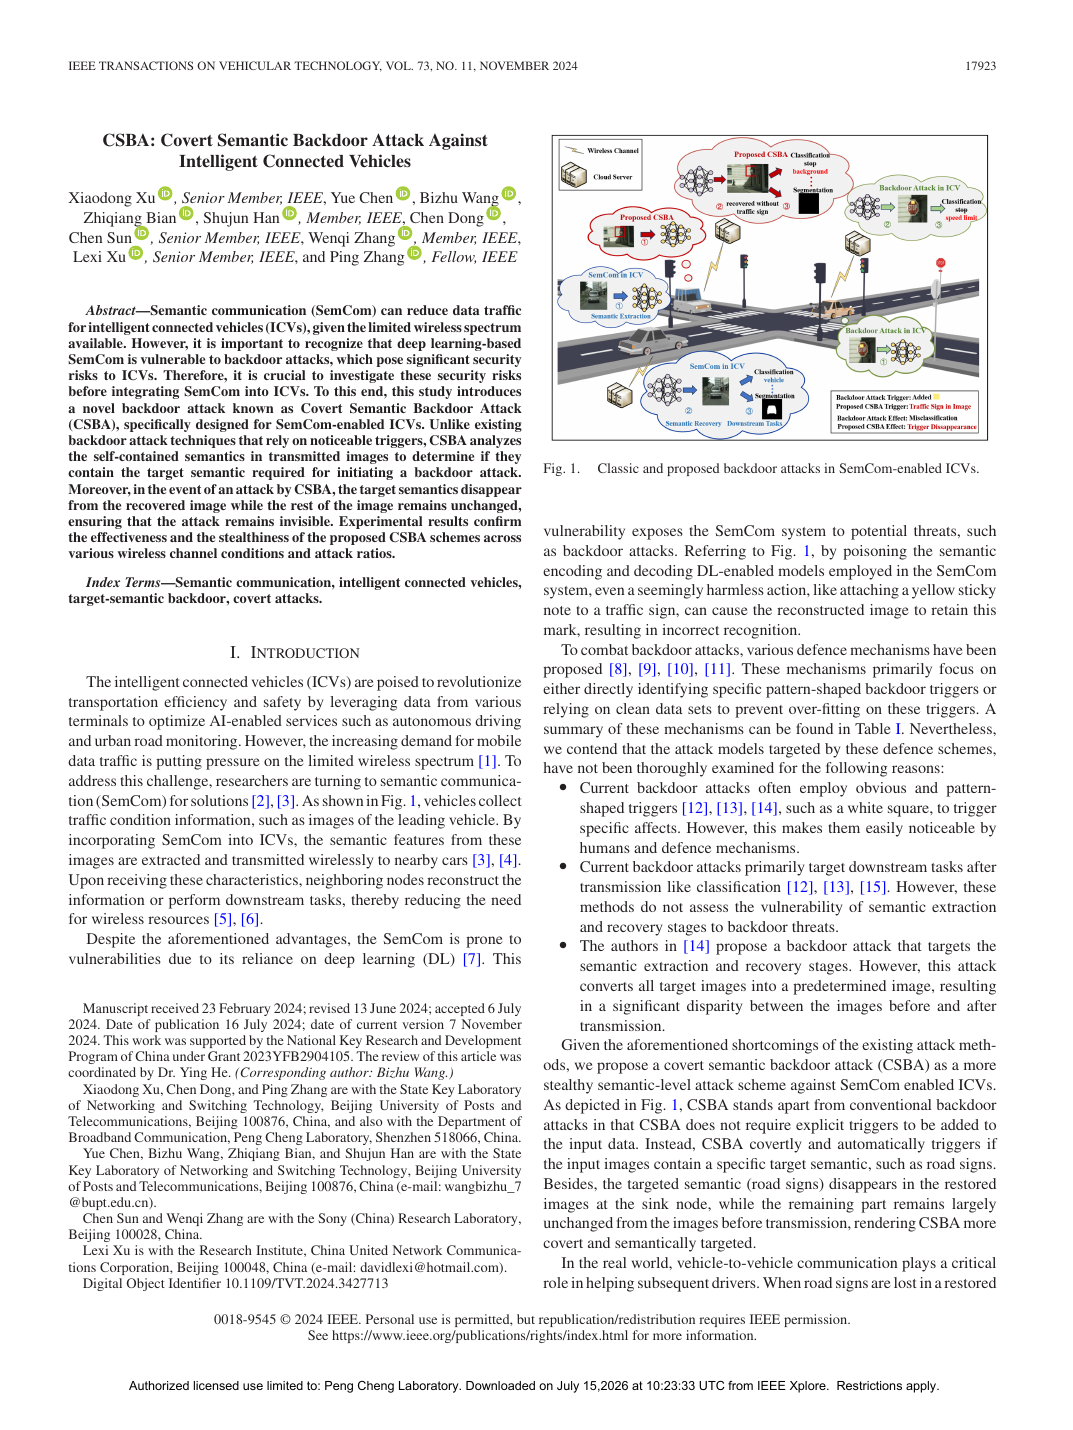
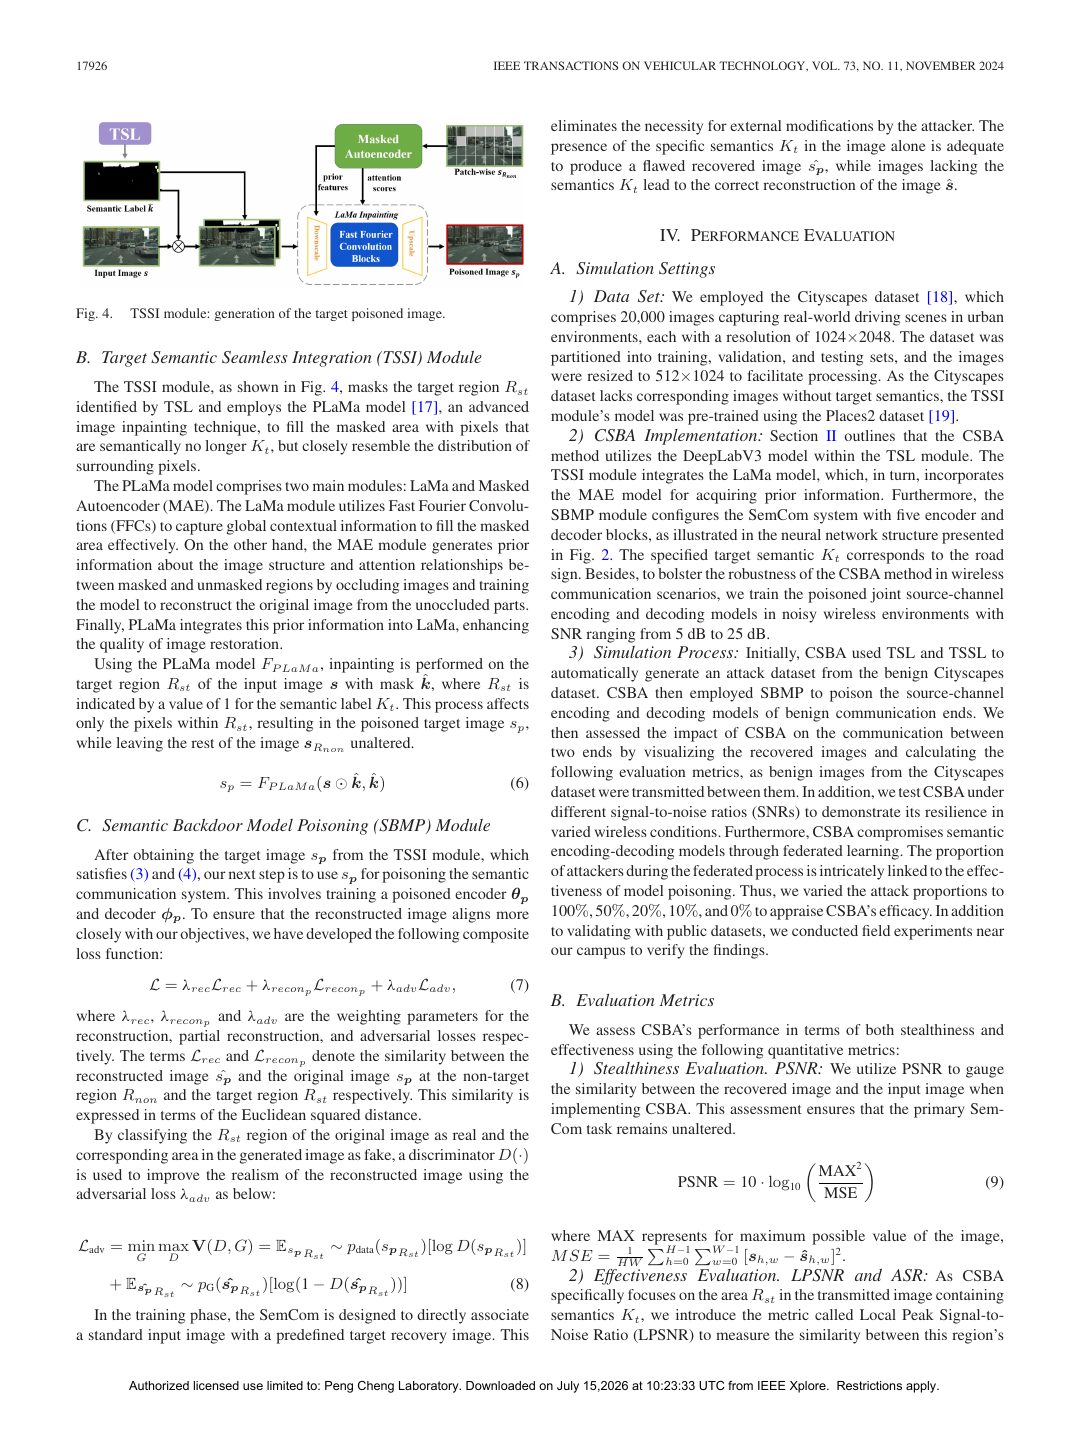
CSBA: Covert Semantic Backdoor Attack Against Intelligent Connected Vehicles
现有进展:在图像语义通信中,通信系统的效能受到多种因素的复杂影响,包括图像压缩率、语义噪声、信道噪声等。 PDF p.1
仍然存在的问题:然而,他们往往忽略了在整个传输过程中所传递的信息的潜在意义和目的。 PDF p.1
为什么已有方法解决不了:分离压缩与信道编码优化的是中间 bit 可靠性,未必等价于本文关心的语义/任务质量;反过来,只做端到端网络而不交代带宽、功率和信道作用点也无法形成公平通信比较。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
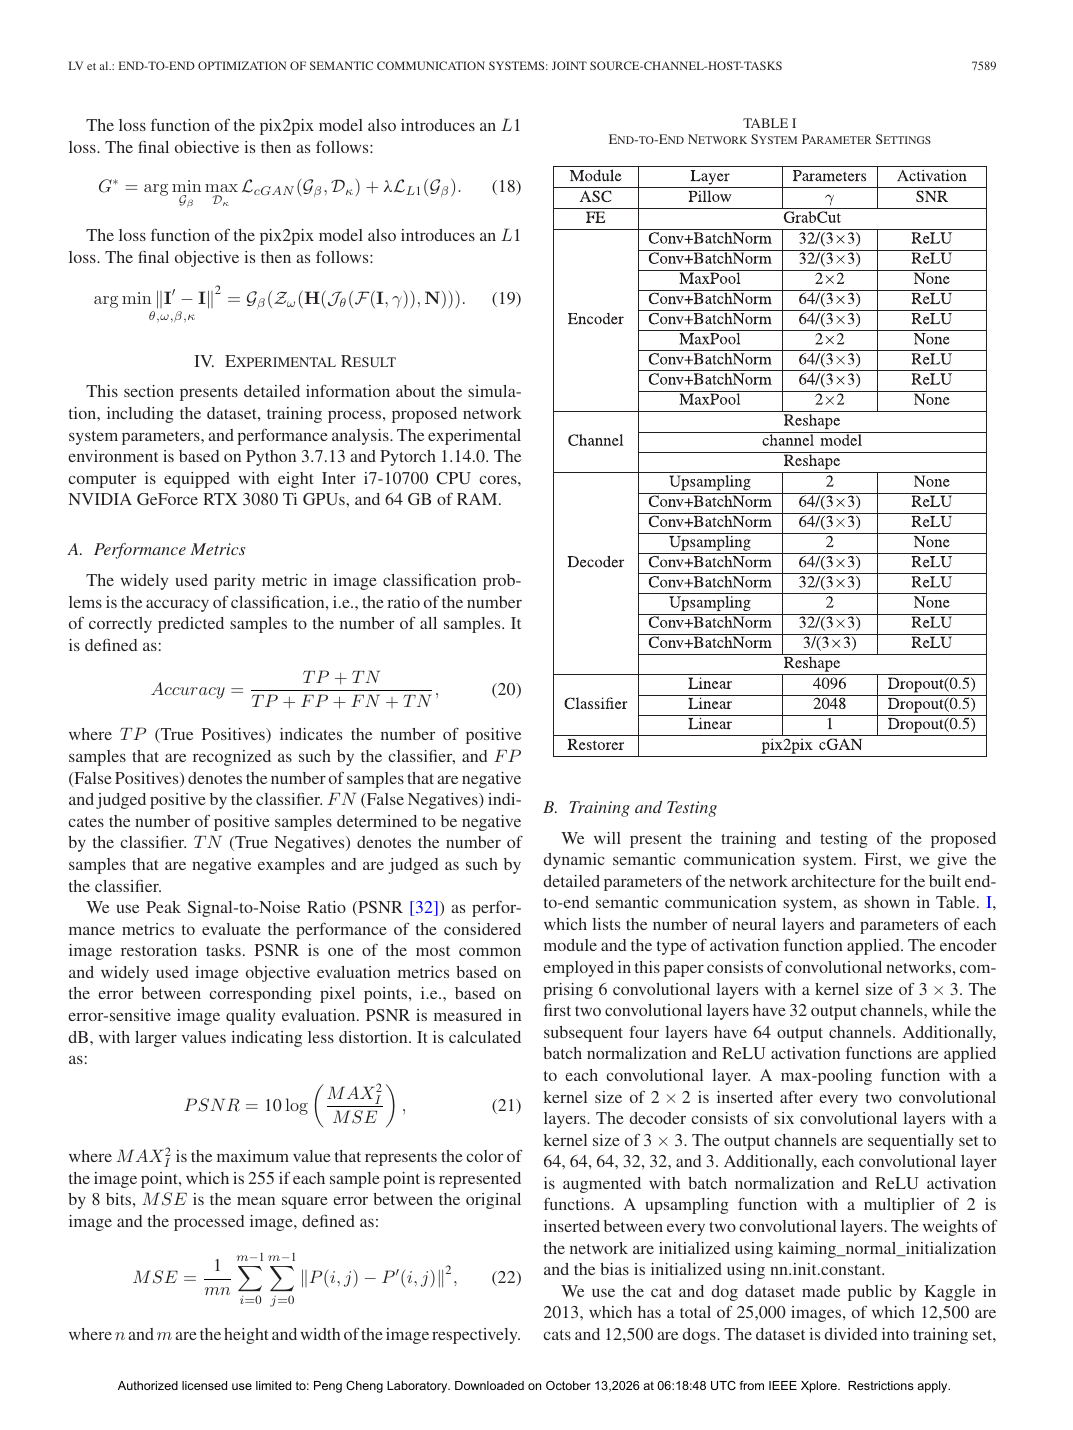
本文提出什么:本文提出了一种通过加入源-信道-主机-任务(JSCHT)方面来优化图像语义通信系统的方法。 PDF p.1
方案为何可能有效:与现有的方法采用固定的信道模型,我们提出了一种新的端到端的语义通信架构,利用JSCHT优化。 PDF p.3
作者希望证明什么:与之前的方法相比,它在20 dB处优于提议的方法。 PDF p.13
方法与端到端信息流
提出了一种基于信源-信道-主机-任务(Source-Channel-Host-Task,JSCHT)的图像语义通信系统优化方法。与现有的基于固定信道模型的图像语义通信系统不同,本文提出了一种基于JSCHT优化的端到端图像语义通信系统结构。当信道的信噪比低于该阈值时,从而导致接收质量的急剧下降。采用源-信道-主机-任务(Source-Channel-Host-Task,JSCHT)优化方法,训练过程在开发复杂的鲁棒性和灵活性的语义通信框架时达到高潮。 PDF p.1PDF p.3
架构/方法图|来源:《End-to-End Optimization of Semantic Communication Systems: Joint Source-Channel-Host-Tasks》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《End-to-End Optimization of Semantic Communication Systems: Joint Source-Channel-Host-Tasks》,原 PDF p.10,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2024语义感知资源分配与网络优化
Game-Guided Matching Theory-Based Resource Allocation for Secure Semantic Communications
仍然存在的问题:然而,随着对高传输数据速率的更高要求,传统的以数据为中心的通信系统面临着性能限制。 PDF p.1
为什么已有方法解决不了:只按 bit rate、吞吐量或平均失真分配资源,无法区分不同样本和任务的语义价值;外层优化必须得到可用的语义效用—资源曲线。 PDF p.1
为什么这个问题重要:功率、带宽、算力和时延是共享资源;若调度器不知道语义效用,它可能增加吞吐量却没有改善任何用户真正关心的任务。 PDF p.1
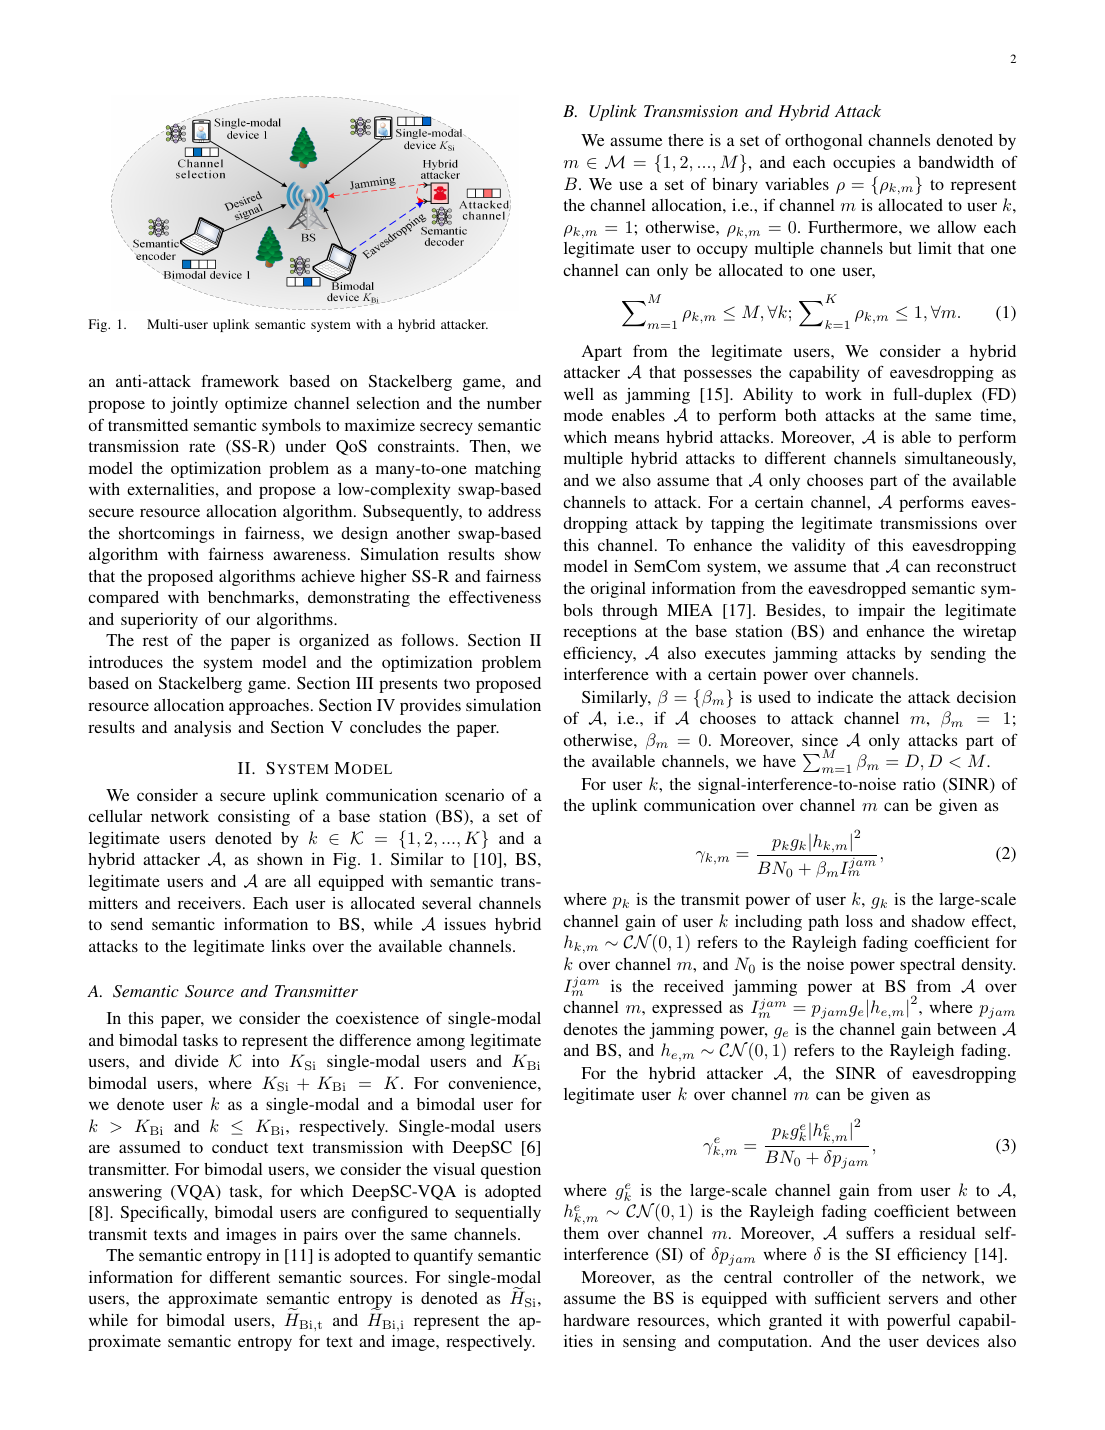
本文提出什么:为此,本文设计了一种基于资源分配的安全可靠的SemCom方法,以联合优化信道选择和发送语义符号的数量为目标,在不同的服务质量要求下,最大化安全语义传输速率(SS-R)。 PDF p.1
方案为何可能有效:然后,将优化问题建模为一个具有外部性的多对一匹配问题,提出了一种低复杂度的基于交换的安全资源分配算法。 PDF p.2
作者希望证明什么:仿真实验结果表明,该算法在不同场景下的性能均优于基线和基准算法。 PDF p.1
方法与端到端信息流
为此,本文设计了一种基于资源分配的安全可靠的SemCom方法,以在不同的服务质量要求下,信道选择和发送语义符号的数量联合优化,使安全语义传输速率(SS-R)最大化为目标,将优化问题建模为一个具有外部性的多对一匹配问题,然后,将优化问题建模为一个具有外部性的多对一匹配问题,提出了一种低复杂度的基于交换的安全资源分配算法。 PDF p.1PDF p.2
输入输入是语义感知资源分配与网络优化所需的用户、任务、信道和资源状态。
发送端发送端采用 Game-Guided Matching Theory-Based Resource Allocation for Secure Semantic Communications:为此,本文设计了一种基于资源分配的安全可靠的SemCom方法,以在不同的服务质量要求下,信道选择和发送语义符号的数量联合优化,使安全语义传输速率(SS-R)最大化为目标,将优化问题建模为一个具有外部性的多对一匹配问题,然后,将优化问题建模为一个具有外部性的多对一匹配问题,提出了一种低复杂度的基于交换的安全资源分配算法。
实际发送实际发送对象是系统模型定义的语义速率、任务效用或信道资源变量。
信道信道作用方式按“类别 5:沿用底层链路或抽象速率—效用模型”解释。
接收端接收端从系统公式假设的接收端输出或语义质量曲线开始,再执行语义解码、任务推理或生成。
输出最终输出为资源/部署策略及其语义效用。
它在通信系统中的位置:把语义/任务质量映射为网络效用,再分配功率、带宽、算力或时延。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:上层理论/资源变量;论文不单独定义可发送语义格式
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“上层理论/资源变量;论文不单独定义可发送语义格式”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:Game-Guided Matching Theory-Based Resource Allocation for Secure Semantic Communications 的主传输单位属于“上层理论/资源变量;论文不单独定义可发送语义格式”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
论文优化的是功率、带宽、时隙、用户调度或语义效用等上层资源变量,并未定义一条可逐 bit 复现的语义 codec。因而这里只报告系统约束和效用曲线,不能从优化变量反推 token/index 总 bit 数。 PDF p.2PDF p.4
架构/方法图|来源:《Joint Active and Passive Beamforming for RIS-Aided Semantic Communication》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Joint Active and Passive Beamforming for RIS-Aided Semantic Communication》,原 PDF p.5,Fig. 3 Inference accuracy vs 核对论文
核心纳入2024图像传输、压缩或生成
Joint Source-Channel Coding for Image Super-Resolution Tasks in Semantic Communications
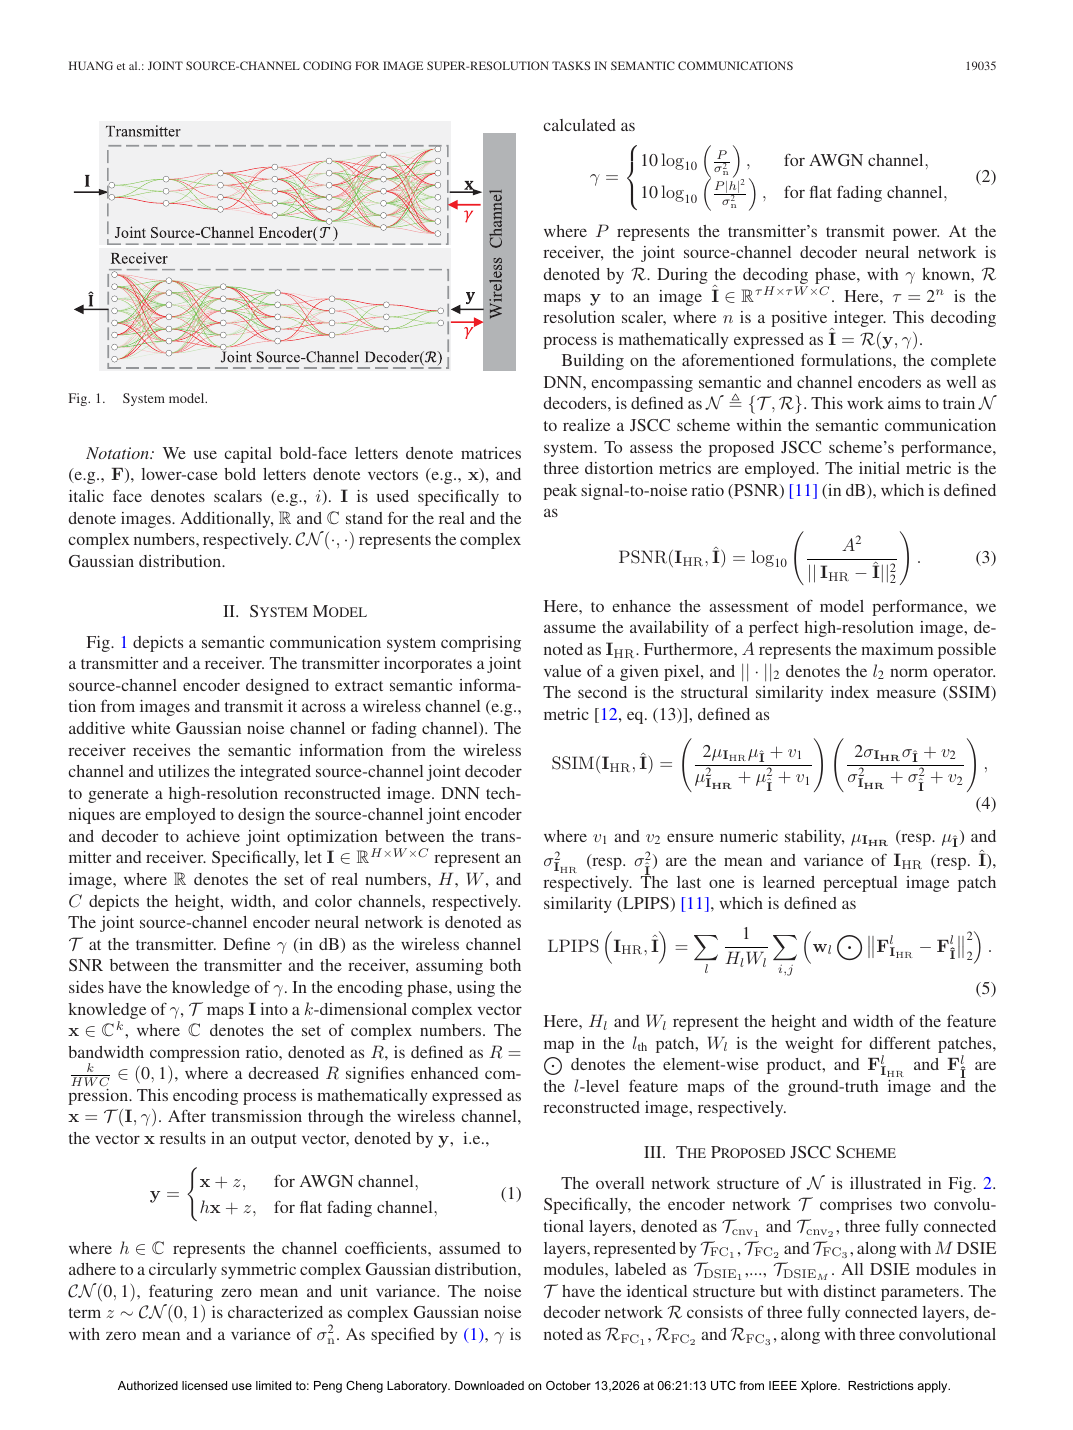
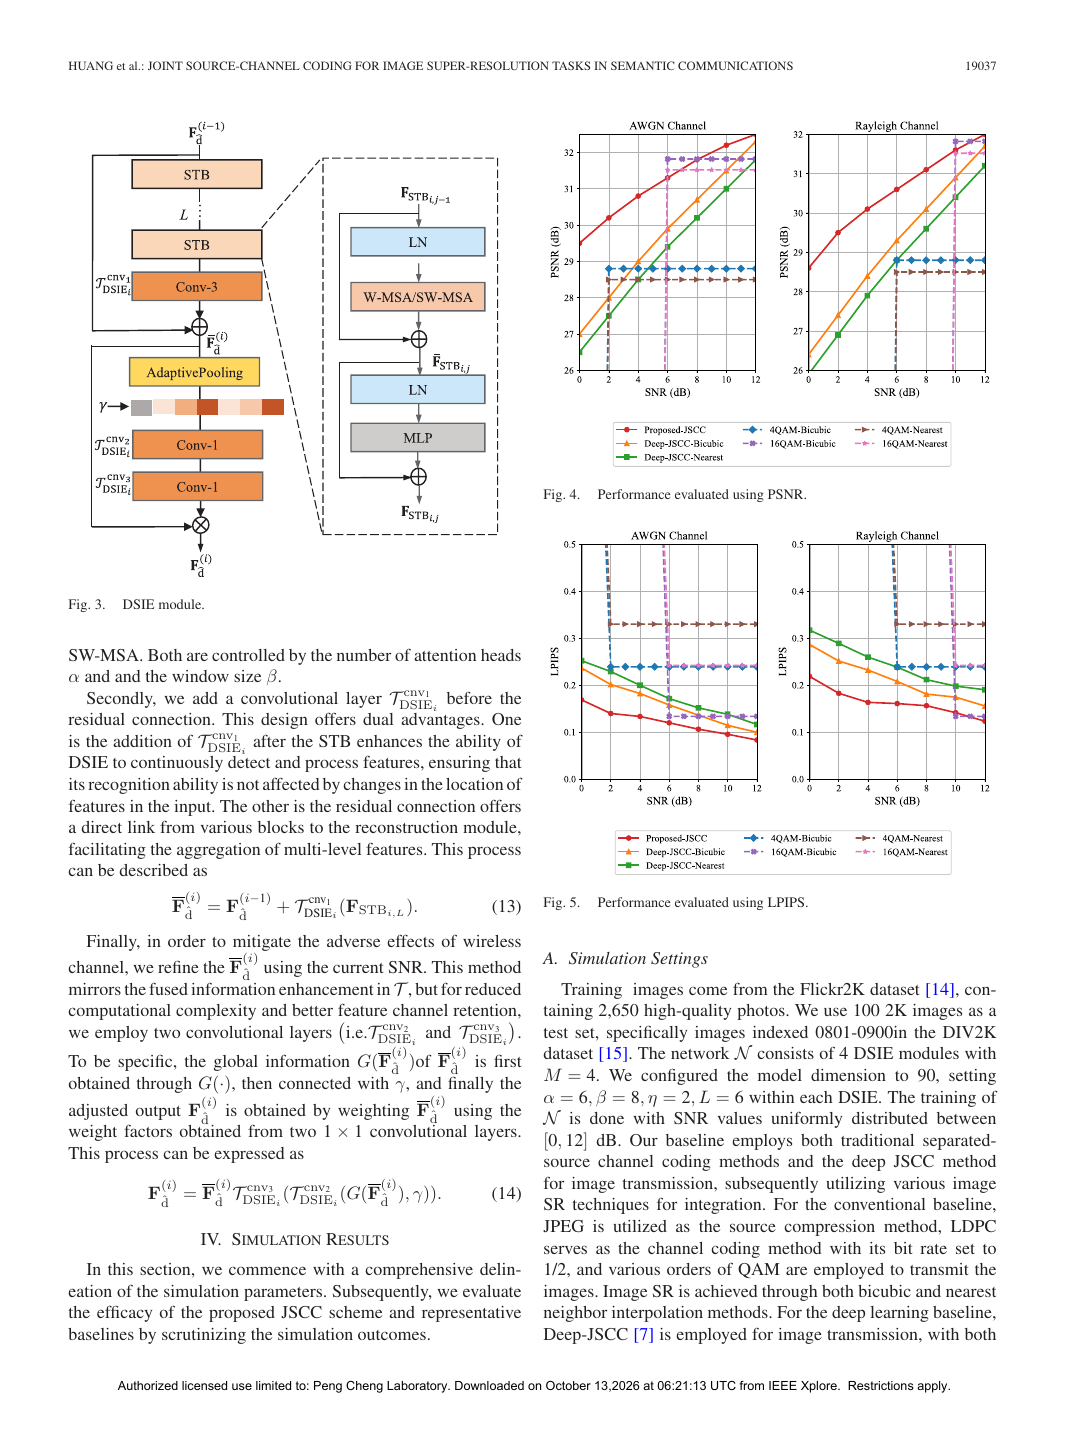
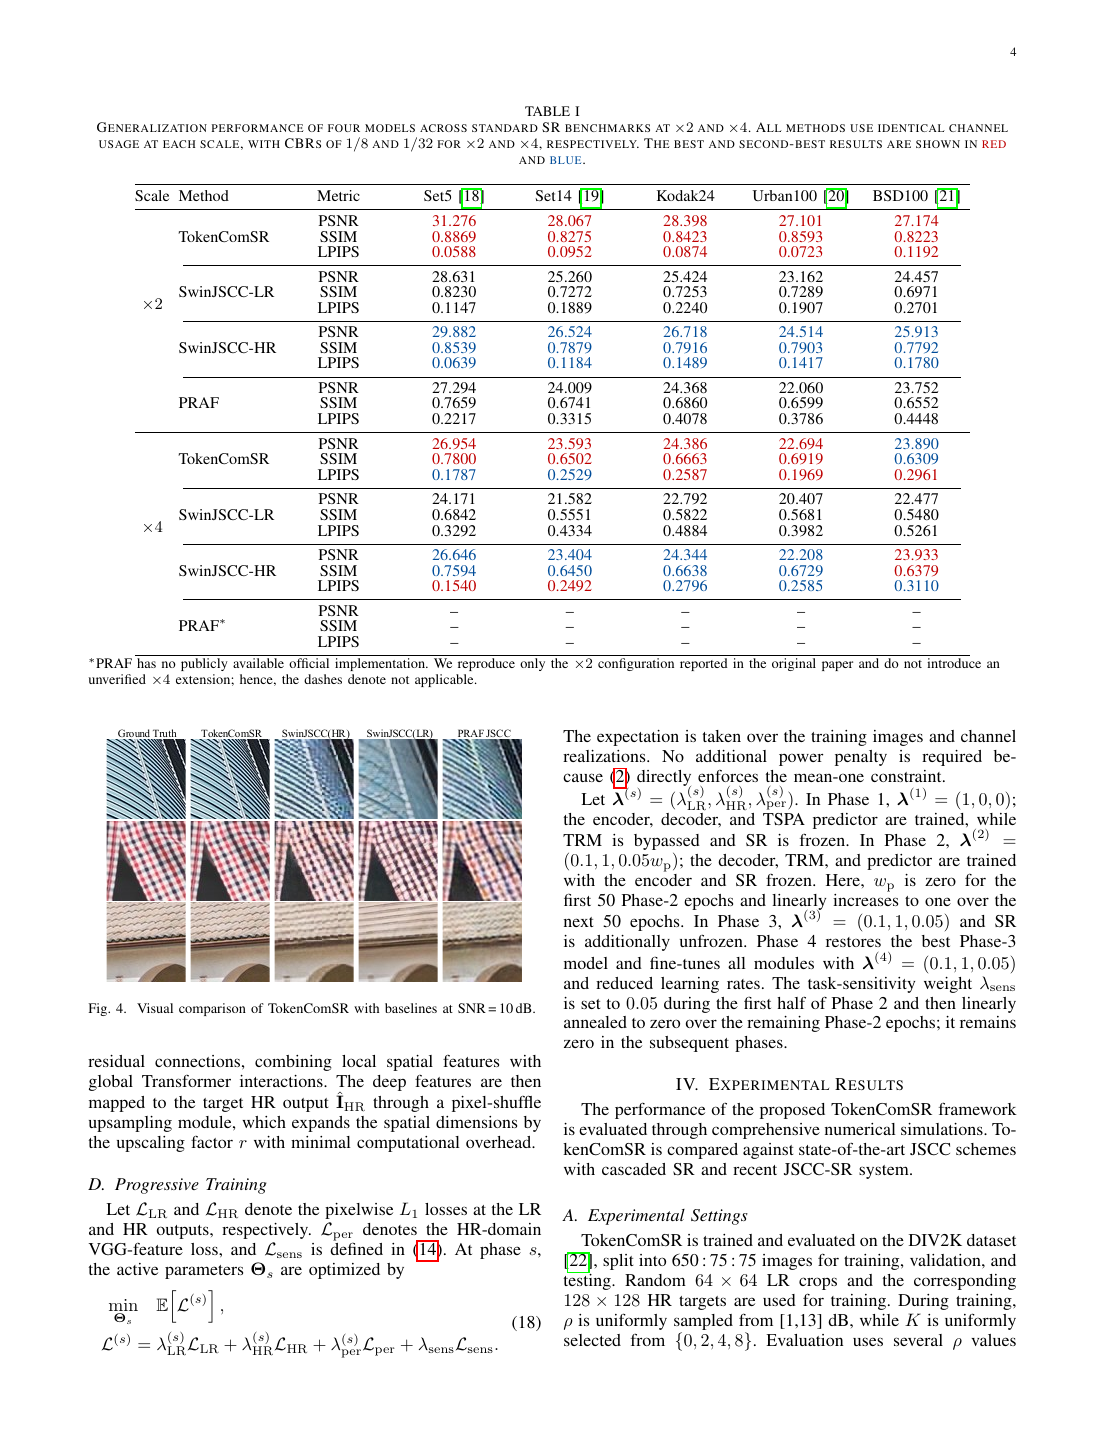
架构/方法图|来源:《Joint Source-Channel Coding for Image Super-Resolution Tasks in Semantic Communications》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Joint Source-Channel Coding for Image Super-Resolution Tasks in Semantic Communications》,原 PDF p.4,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2024任务导向推理
Knowledge Discrepancy Oriented Privacy Preserving for Semantic Communication
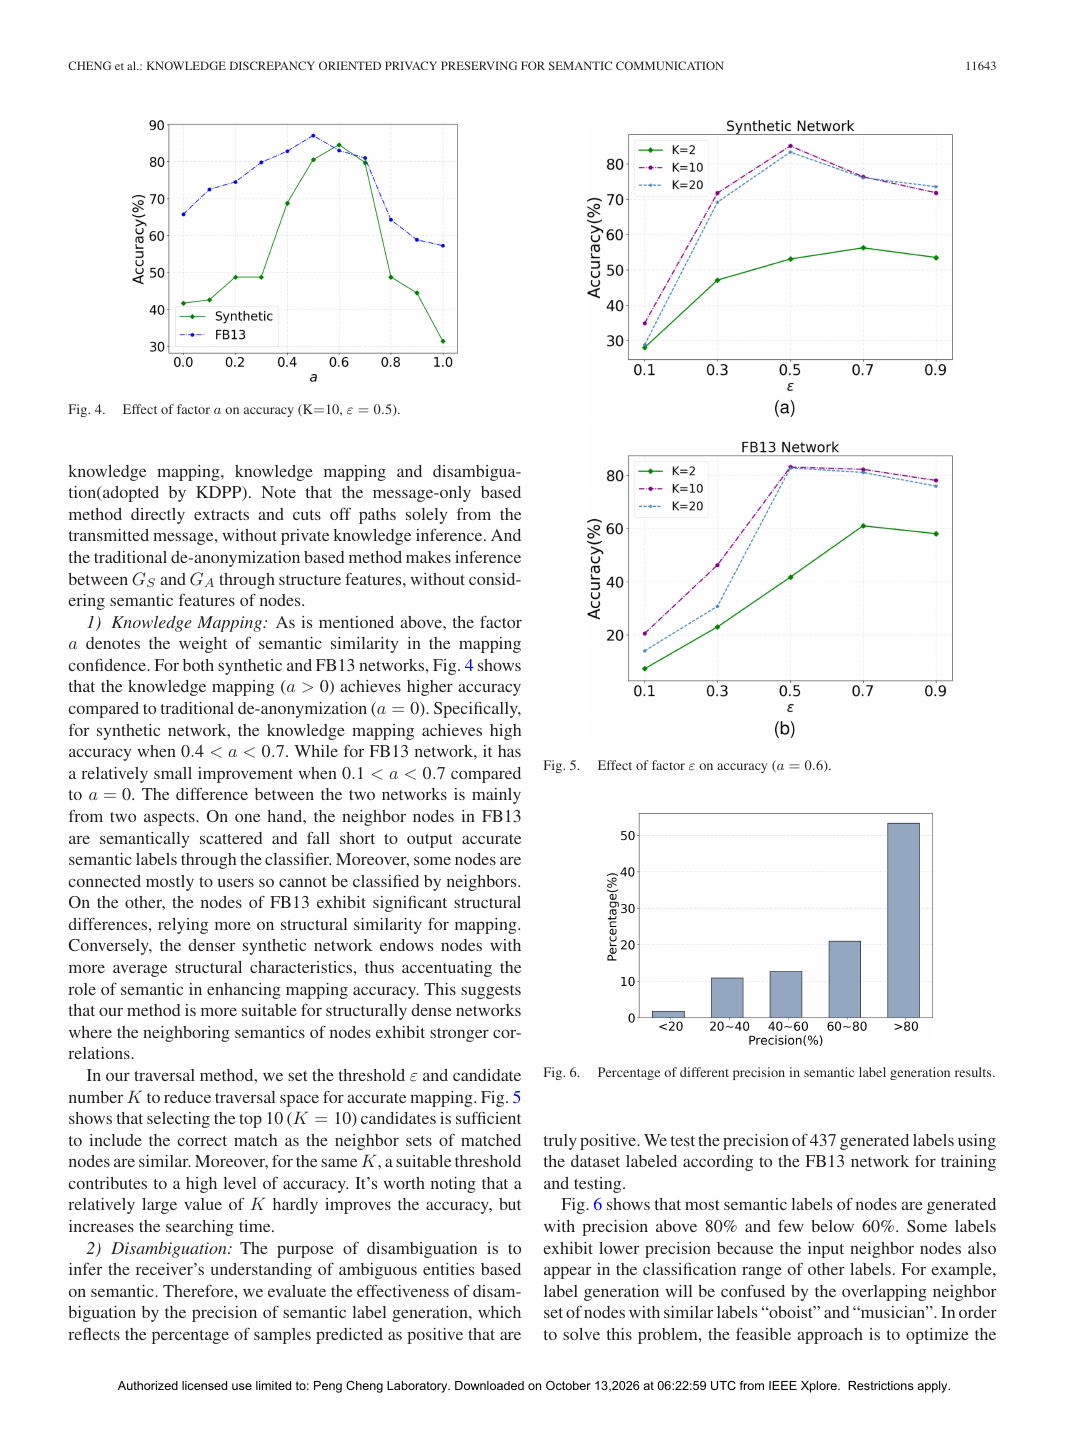
架构/方法图|来源:《Knowledge Discrepancy Oriented Privacy Preserving for Semantic Communication》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Knowledge Discrepancy Oriented Privacy Preserving for Semantic Communication》,原 PDF p.7,Fig. 5 Effect of factor ε on accuracy (a = 0.6) 核对论文
核心纳入2024任务导向推理
Maximal Coding Rate Reduction: A Unified Approach for Task-Oriented RIS and Communication
架构/方法图|来源:《Maximal Coding Rate Reduction: A Unified Approach for Task-Oriented RIS and Communication》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Maximal Coding Rate Reduction: A Unified Approach for Task-Oriented RIS and Communication》,原 PDF p.4,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2024通用语义通信系统
Novel Double Protograph LDPC Codes for Joint Source-Channel Coding Systems
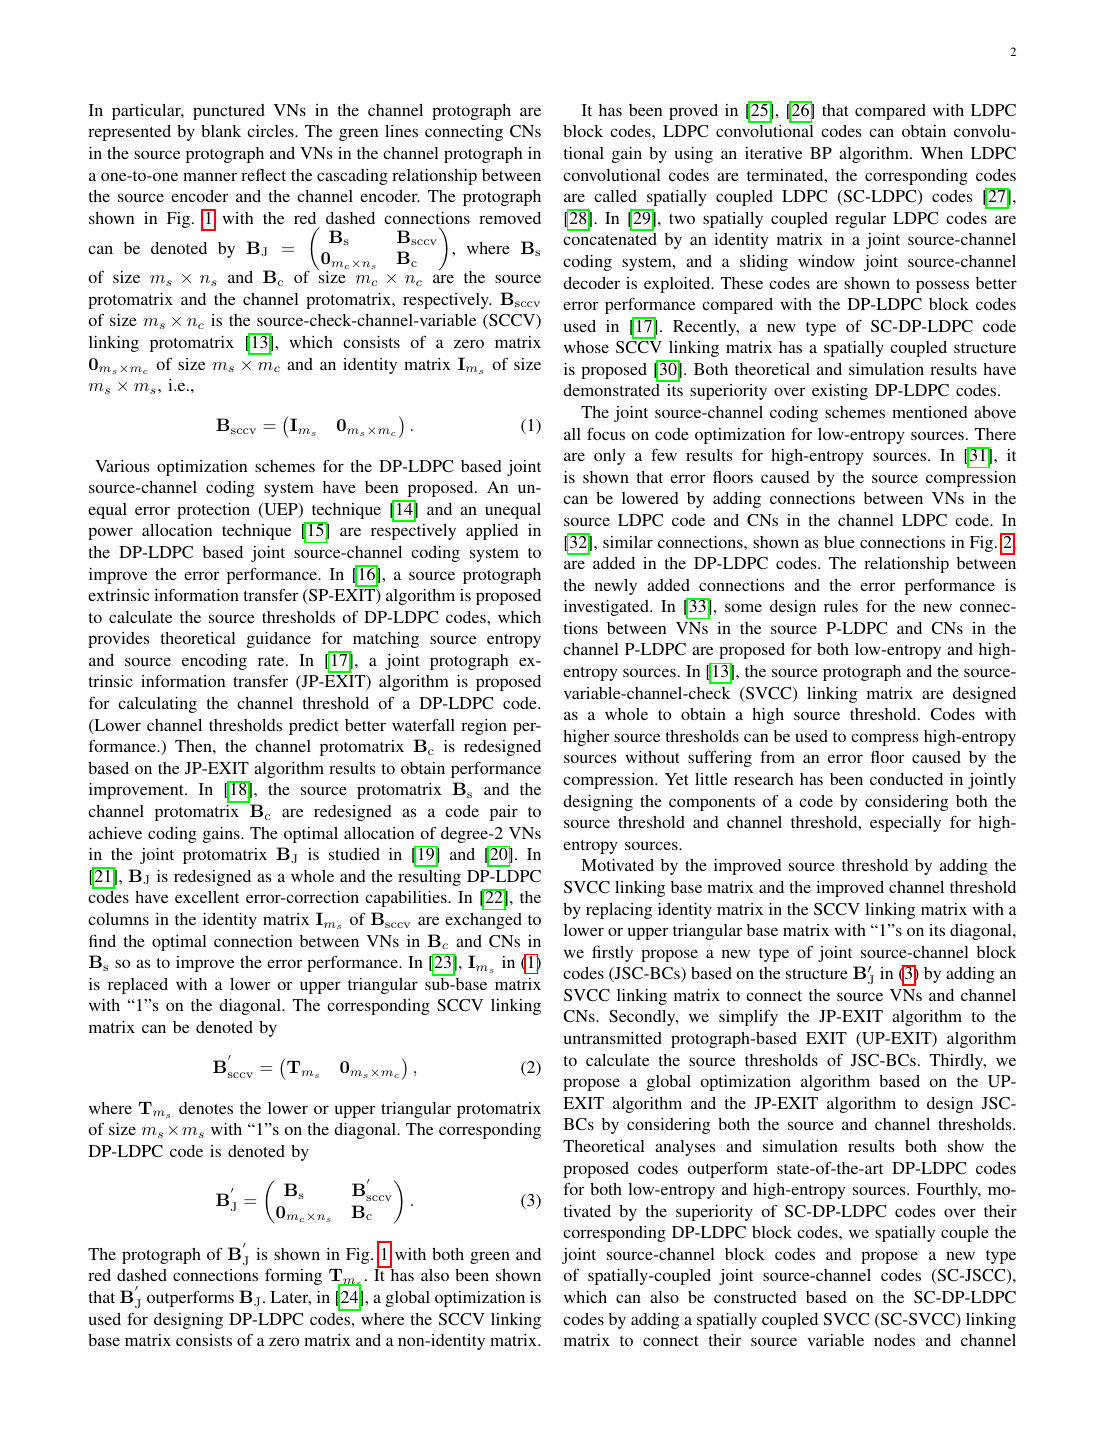
现有进展:本文首先提出了一种新的联合信源信道分组码(JSC-BC),其中两个基于协议图的低密度奇偶校验(P-LDPC)分组码不仅通过信源可变信道校验(SVCC)连接矩阵连接,而且还通过信源可变信道校验(SCCV)连接矩阵连接,SCCV连接矩阵由一个零矩阵和一个对角为“1“的下三角(基)矩阵或上三角(基)矩阵组成。 PDF p.1
仍然存在的问题:但是,若要将本材料用于任何其他目的,必须通过向pubs-permission@ieee.org发送请求,从IEEE获得许可。 PDF p.1
为什么已有方法解决不了:连续 latent 或独立设计的传统链路没有回答语义特征怎样量化、映射为有限符号,以及 bit/index 出错后为何不会跳到完全不同的语义。仅改进信源网络无法补上这一接口。 PDF p.1
为什么这个问题重要:语义质量必须在真实的带宽、功率和时延预算下成立,否则模型收益不能转化为通信系统收益。 PDF p.1
本文提出什么:同时,对传统的联合协议图外部信息传递(JP-EXIT)算法进行了简化,提出了一种“基于未传输协议图的EXIT(UP-EXIT)算法,”用于计算JSC-BC的源阈值。 PDF p.1
方案为何可能有效:本文首先提出了一种新的联合信源信道分组码(JSC-BC),其中两个基于协议图的低密度奇偶校验(P-LDPC)分组码不仅通过信源可变信道校验(SVCC)连接矩阵连接,而且还通过信源可变信道校验(SCCV)连接矩阵连接,SCCV连接矩阵由一个零矩阵和一个对角为“1“的下三角(基)矩阵或上三角(基)矩阵组成。 PDF p.1
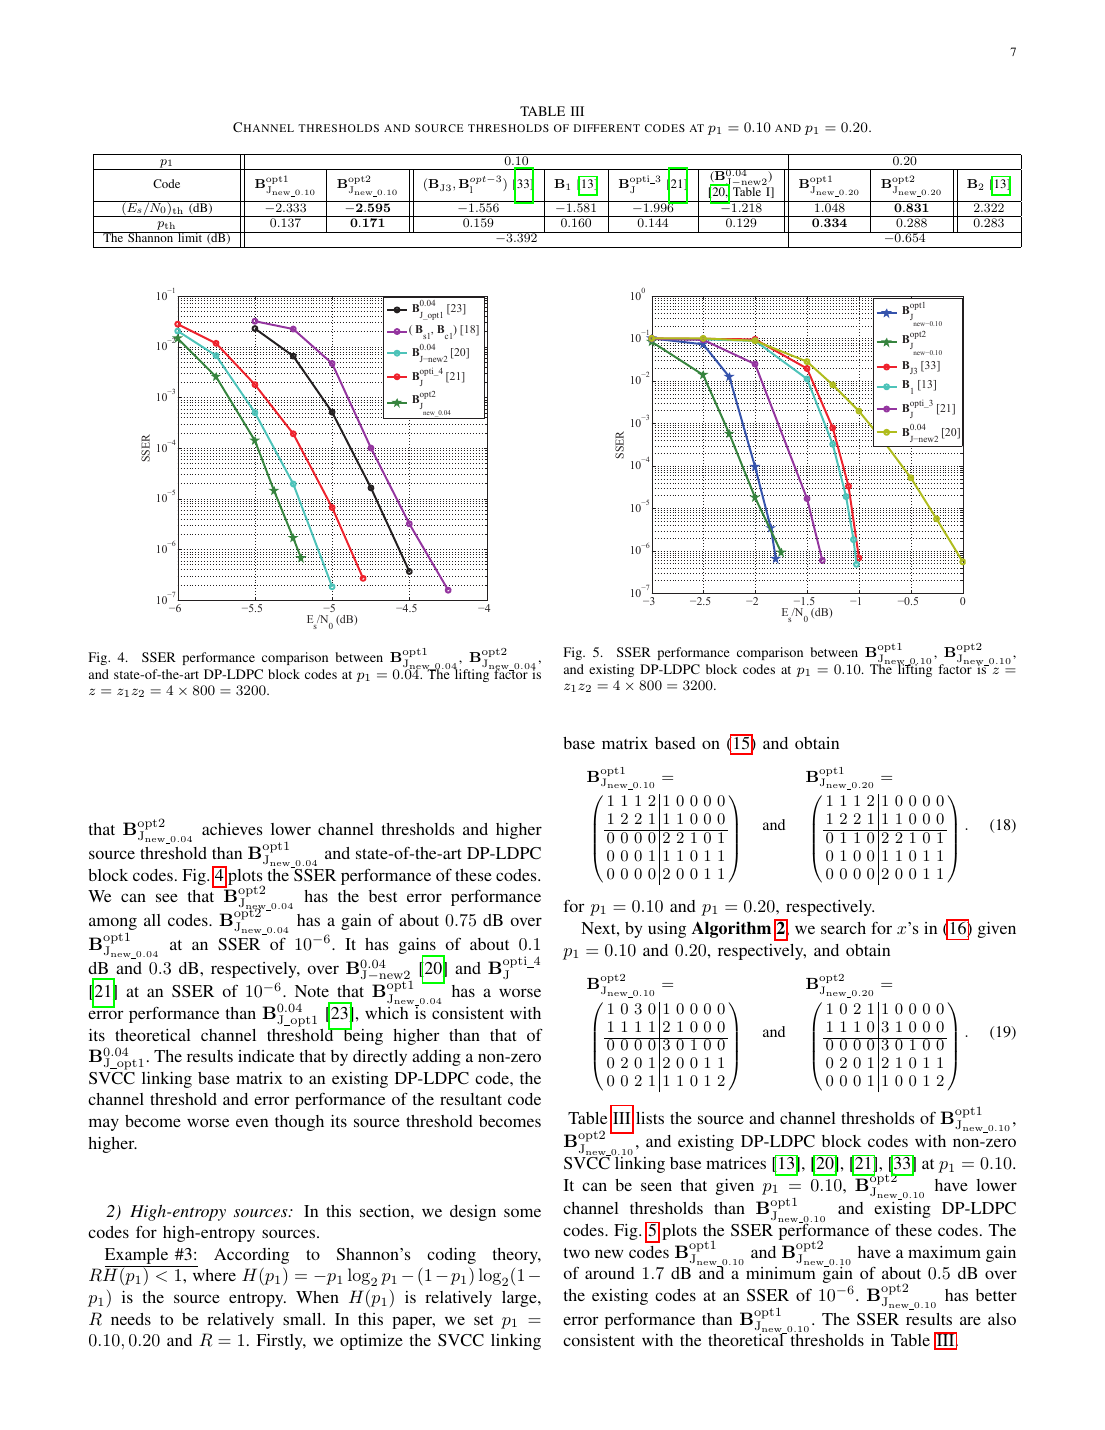
作者希望证明什么:理论分析和仿真结果表明,在较小的窗口尺寸和较低的译码复杂度下,SC-JSCC的各子块空间耦合结构(信源原矩阵、信道原矩阵、SCCV连接矩阵和SVCC连接矩阵)比现有的空间耦合DP-LDPC码具有更好的误码性能。 PDF p.1
方法与端到端信息流
此外,我们还对传统的联合协议图外部信息传递(JP-EXIT)算法进行了简化,提出了一种用于计算JSC-BC的源阈值的“基于未传输协议图的EXIT(UP-EXIT)算法,"我们首先提出了一种新的联合信源信道分组码(JSC-BC),该码中两个基于协议图的低密度奇偶校验(P-LDPC)分组码不仅通过一个信源可变信道连接,而且还通过一个信源信道可变信道连接。然后,本文在UPEXIT算法和JP-EXIT算法的基础上,提出了一种综合考虑信源门限和信道门限的全局优化算法,并在此算法的基础上,提出了一种基于UPEXIT算法和JP-EXIT算法的JSCBC的全局优化算法。 PDF p.1PDF p.2
理论分析和计算机仿真结果表明,即使在较小的窗口尺寸和较低的译码复杂度下,各子块采用空间耦合结构的SC-JSCC也能有效地提高译码的性能(源原矩阵、信道原矩阵、SCCV链接矩阵、和SVCC链接矩阵)可以获得比现有空间耦合DP-LDPC码更好的差错性能,注意,将SC-与本节中给出的仿真结果相比,JSCC和SC-DP-LDPC码可导致改进的错误性能。 PDF p.1PDF p.10
架构/方法图|来源:《Semantics Alignment via Split Learning for Resilient Multi-User Semantic Communication》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Semantics Alignment via Split Learning for Resilient Multi-User Semantic Communication》,原 PDF p.3,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2024任务导向推理
SNN-SC: A Spiking Semantic Communication Framework for Collaborative Intelligence
架构/方法图|来源:《SNN-SC: A Spiking Semantic Communication Framework for Collaborative Intelligence》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《SNN-SC: A Spiking Semantic Communication Framework for Collaborative Intelligence》,原 PDF p.9,Fig. 4 Performance of SNN-SC and baselines when transmitting ResNet50 features over digital channels 核对论文
相关但非核心2024通用语义通信系统
STAR-RIS-Assisted Privacy Protection in Semantic Communication System
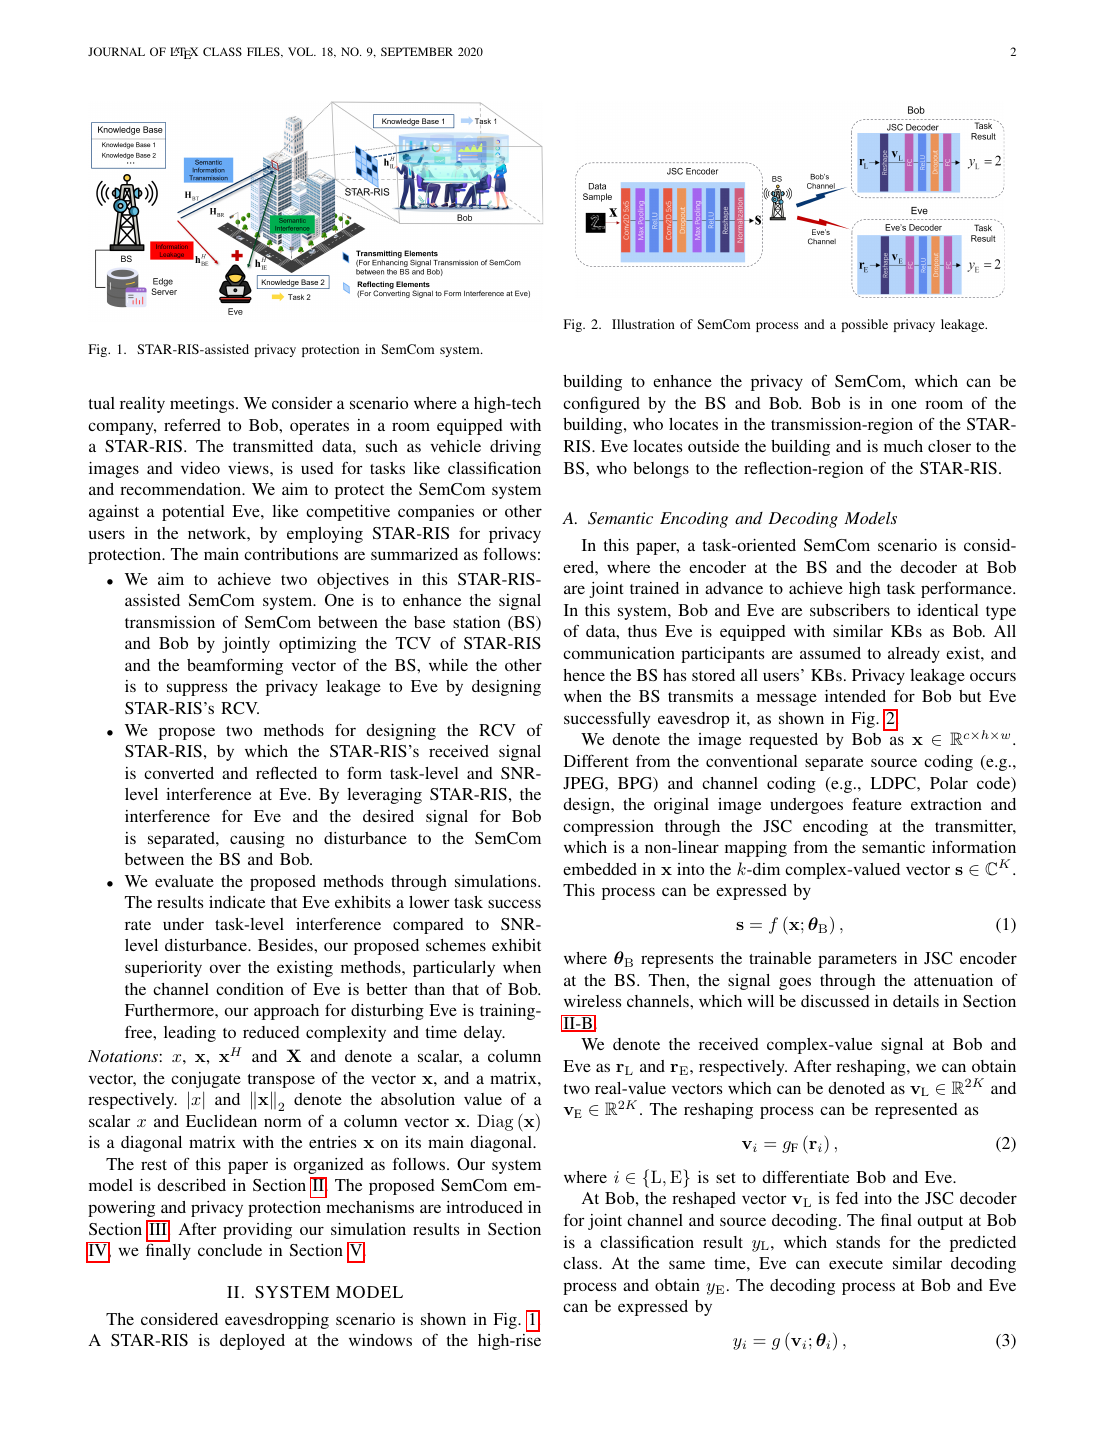
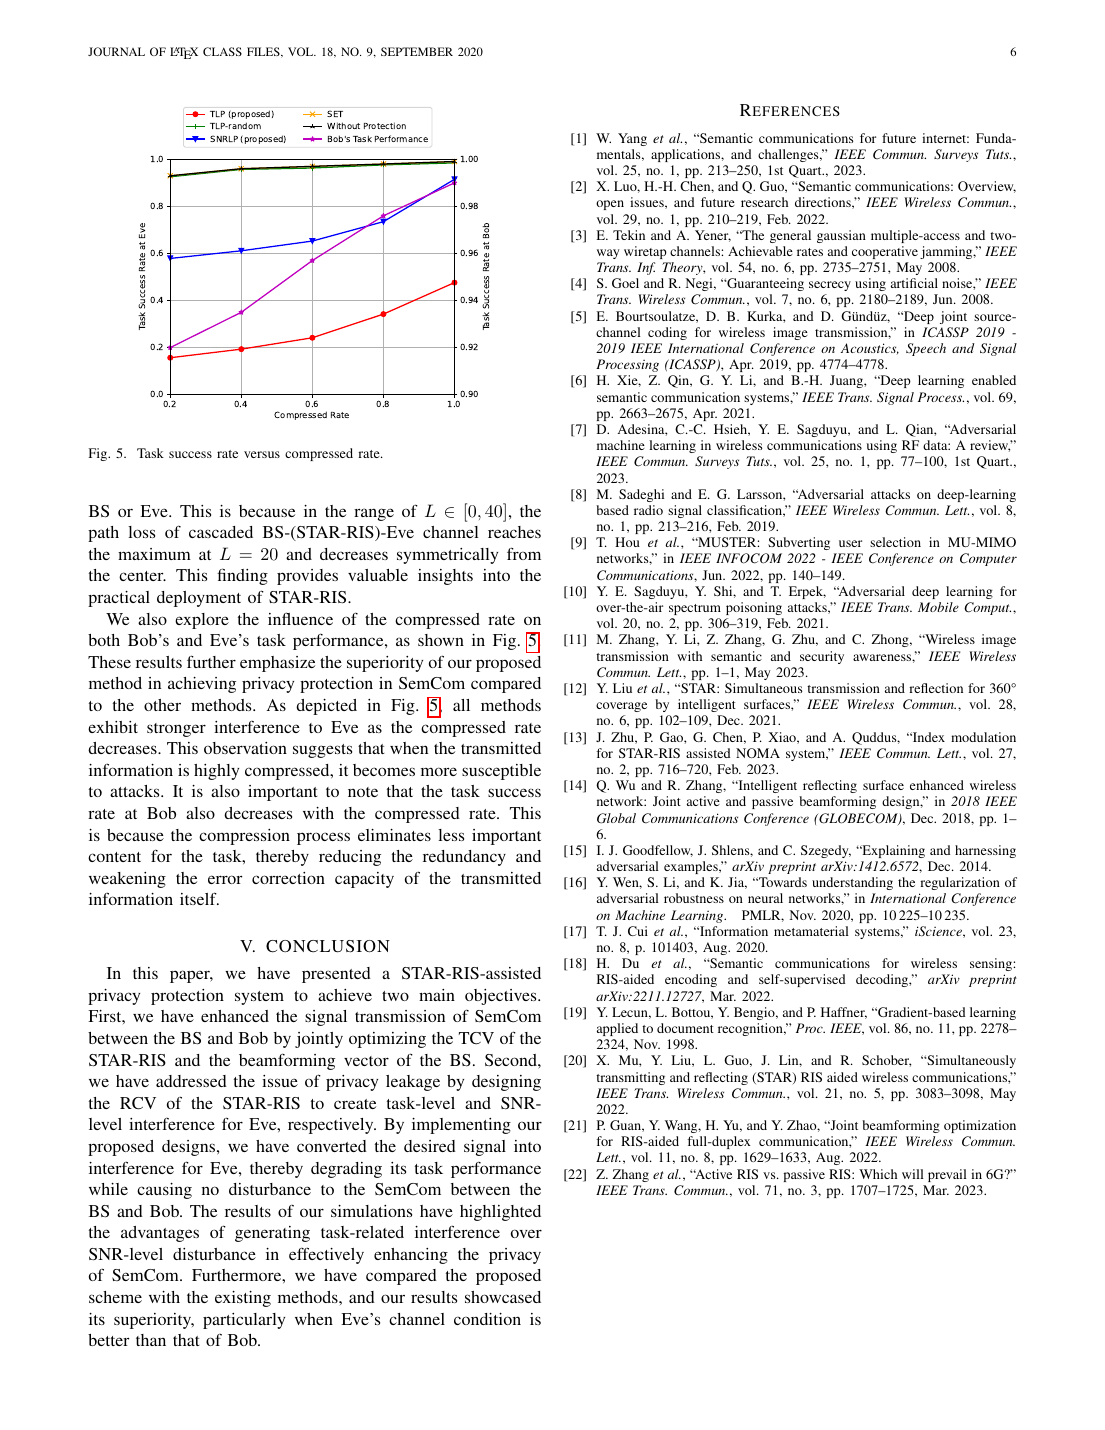
架构/方法图|来源:《STAR-RIS-Assisted Privacy Protection in Semantic Communication System》,原 PDF p.2,Fig. 2 Illustration of SemCom process and a possible privacy leakage 核对论文关键实验结果图/表|来源:《STAR-RIS-Assisted Privacy Protection in Semantic Communication System》,原 PDF p.6,Fig. 5 These RESULTS further emphasize the superiority of our proposed METHOD in achieving privacy protection in SemCom compared to the other methods 核对论文
核心纳入2024图像传输、压缩或生成
Swin Transformer-Based Dynamic Semantic Communication for Multi-User With Different Computing Capacity
仍然存在的问题:然而,很少有文献研究该方法在多用户场景下的有效性,特别是当用户使用的模型结构和计算能力存在变化时。 PDF p.1
为什么已有方法解决不了:把单用户语义编解码器逐个复制给多个用户,会忽略共享内容、异构信道、干扰和公平性,因而不能直接得到频谱有效的网络方案。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
本文提出什么:此外,我们提出一种混合损失函数来训练,以增强重建影像的感知细节。 PDF p.1
方案为何可能有效:为了解决这个问题,我们探索了一种语义通信系统,该系统通过在基站(BS)处使用多用途发射机来迎合具有不同模型架构的多个用户。 PDF p.1
作者希望证明什么:语义通信作为下一代通信系统中替代传统通信的一种有前途的技术,主要由于其降低通信成本的能力而受到研究人员的极大关注。 PDF p.1
方法与端到端信息流
此外,我们提出了一种混合损失函数用于训练,以增强重建图像的感知细节。为了解决这个问题,我们探索了一种语义通信系统,该系统通过在基站(BS)使用多用途发射机来迎合具有不同模型架构的多个用户。另一方面,如果我们将上述系统评估为一级通信,由于两句话的措辞不同,这个制度便会被视为失败。 PDF p.1PDF p.2
输入输入是图像传输、压缩或生成所需的图像及其视觉/任务语义。
发送端发送端采用 Swin Transformer-Based Dynamic Semantic Communication for Multi-User With Different Computing Capacity:此外,我们提出了一种混合损失函数用于训练,以增强重建图像的感知细节。为了解决这个问题,我们探索了一种语义通信系统,该系统通过在基站(BS)使用多用途发射机来迎合具有不同模型架构的多个用户。另一方面,如果我们将上述系统评估为一级通信,由于两句话的措辞不同,这个制度便会被视为失败。
实际发送实际发送对象是功率归一化的实数或复数神经信道符号。
信道信道作用方式按“类别 3:连续语义变量直接经过有噪声信道并端到端恢复”解释。
接收端接收端从AWGN/衰落作用后的带噪连续符号开始,再执行语义解码、任务推理或生成。
输出最终输出为重建/生成图像或视觉任务输出。
它在通信系统中的位置:研究多个用户共享频谱、干扰或中继时的语义相关性与异构信道。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:连续神经 JSCC latent / 实复信道符号
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“连续神经 JSCC latent / 实复信道符号”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:Swin Transformer-Based Dynamic Semantic Communication for Multi-User With Different Computing Capacity 的主传输单位属于“连续神经 JSCC latent / 实复信道符号”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
论文未同时报告输入尺寸、encoder 输出尺寸、量化精度/码本大小和帧级开销,因此不能从全文唯一重建总 bit 数。页面保留论文实际使用的 CBR、bpp、token 数或信道使用次数;缺失项不作臆测。 PDF p.2PDF p.9
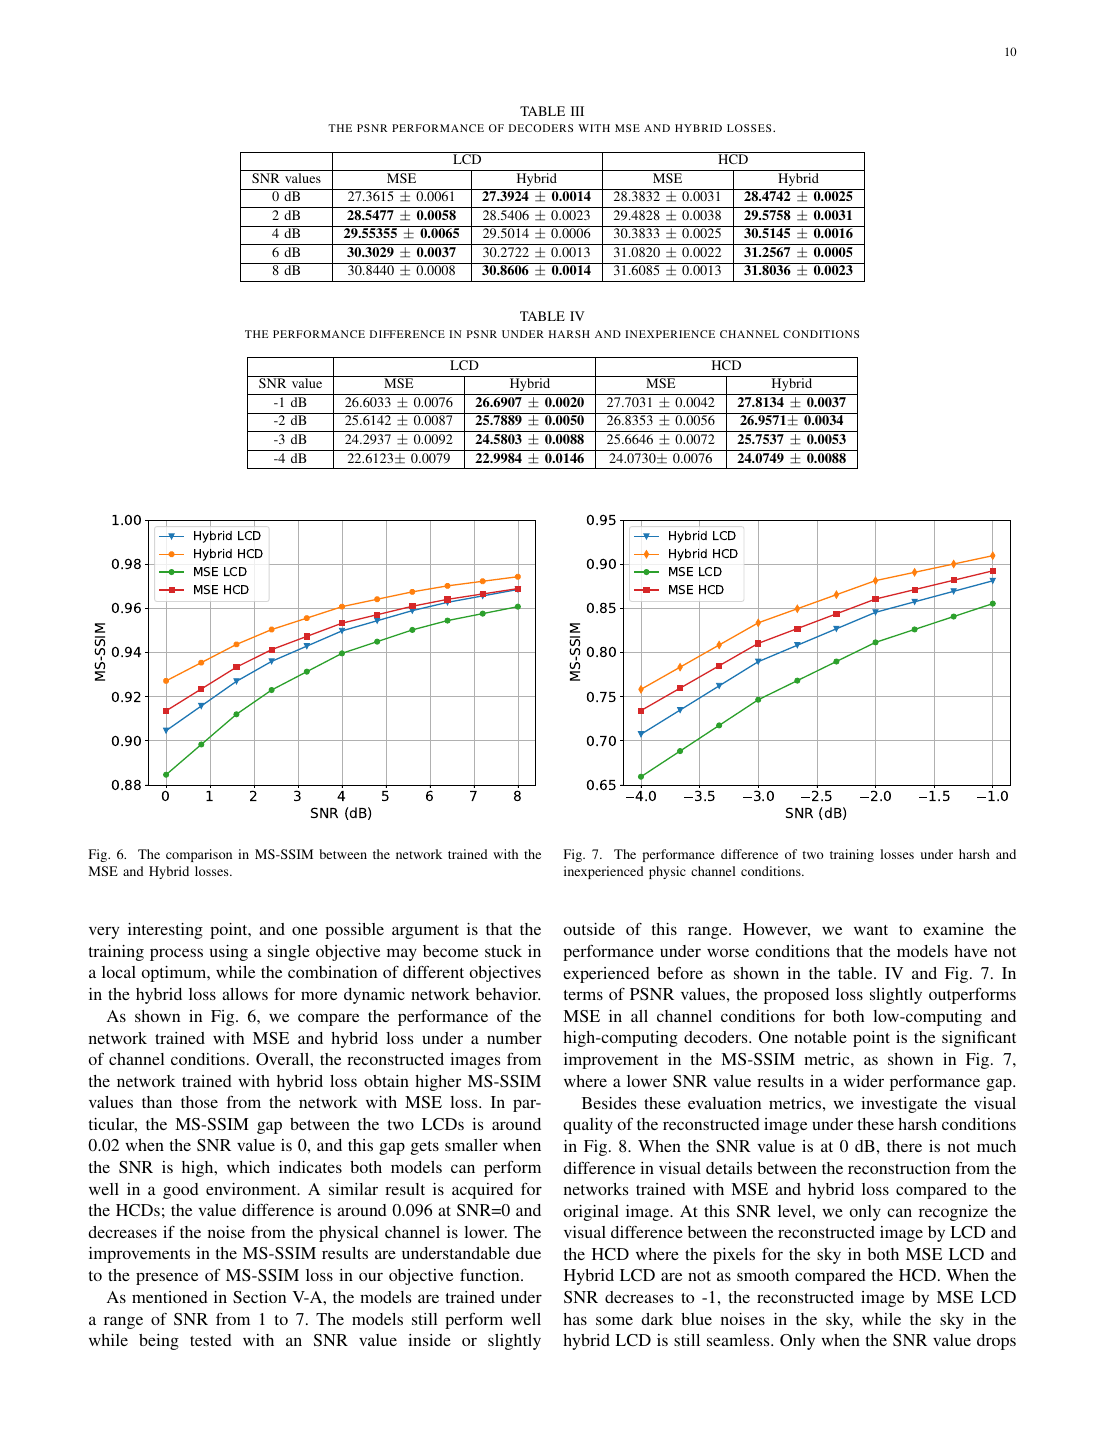
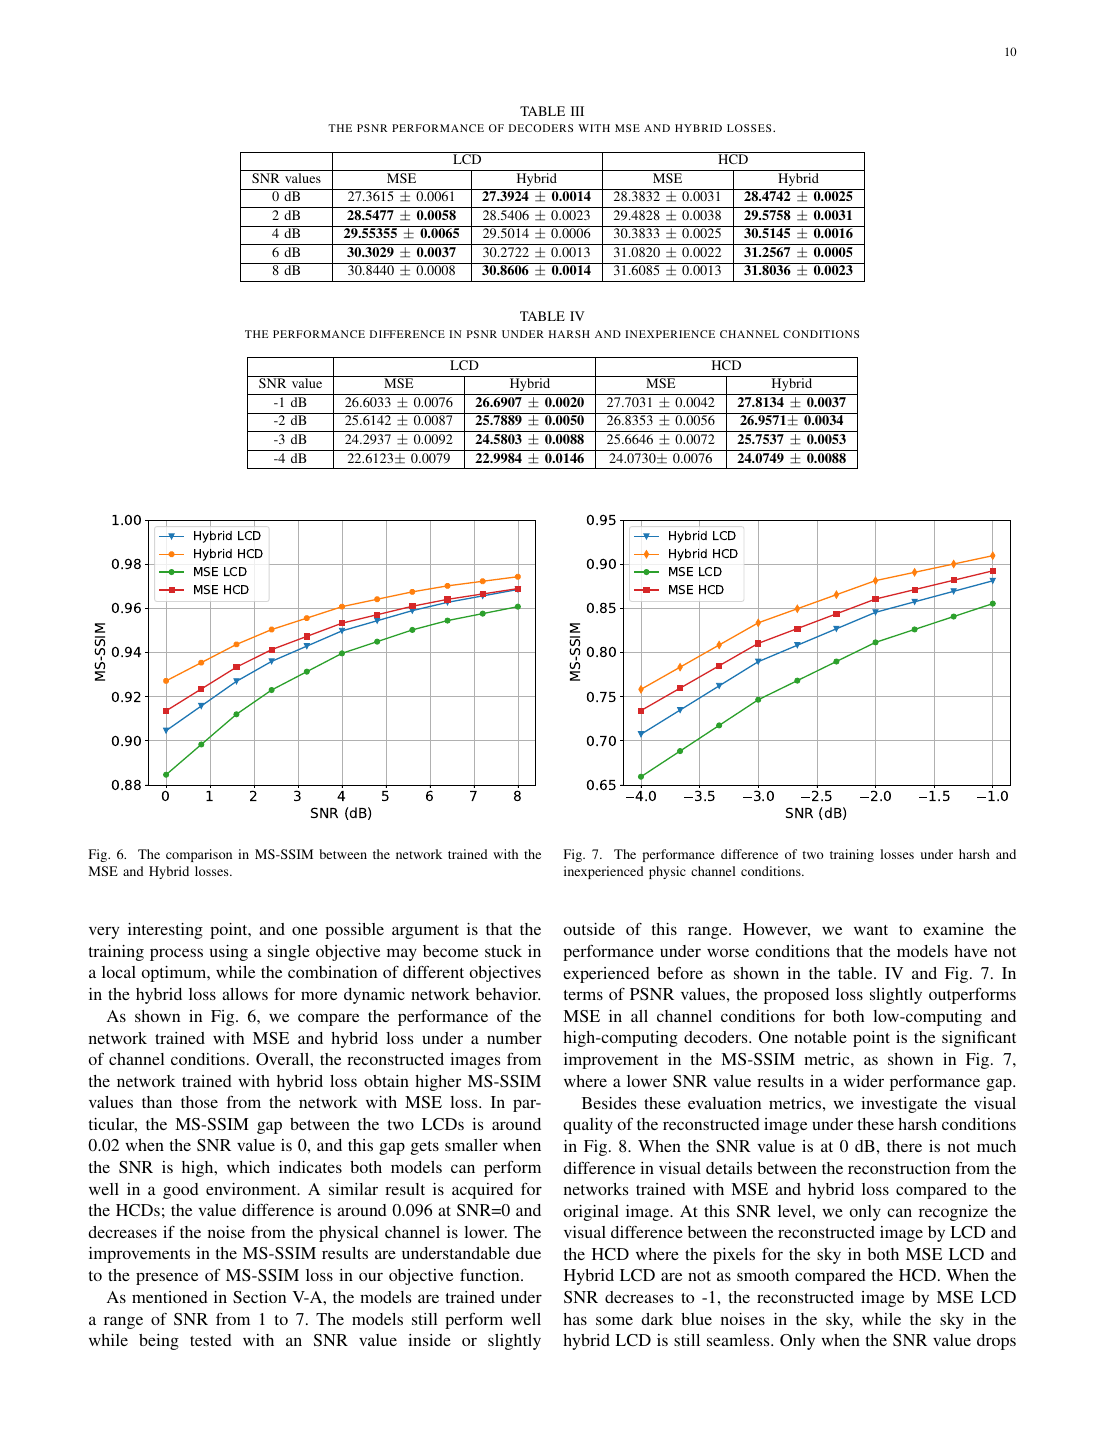
数据集为Kodak、DIV2K;实验小节中明确出现的比较对象包括ADJSCC、JSCC;指标包括PSNR、SSIM、MS-SSIM、MSE;信道/链路条件包括AWGN、Rayleigh、fading channel;正文可定位的代表性工作点有SNR:-4dB、SNR:-3dB、SNR:-2dB、SNR:-1dB、SNR:0dB。 PDF p.9
语义通信作为下一代通信系统中替代传统通信的一种有前途的技术,已经引起了研究人员的极大关注,主要是因为它能够降低通信成本。 PDF p.1PDF p.9
架构/方法图|来源:《Swin Transformer-Based Dynamic Semantic Communication for Multi-User With Different Computing Capacity》,原 PDF p.10,Fig. 6 The comparison in MS-SSIM between the network trained with the MSE and Hybrid losses 核对论文关键实验结果图/表|来源:《Swin Transformer-Based Dynamic Semantic Communication for Multi-User With Different Computing Capacity》,原 PDF p.10,Fig. 6 The comparison in MS-SSIM between the network trained with the MSE and Hybrid losses 核对论文
相关但非核心2024语义感知资源分配与网络优化
Tasks-Oriented Channel Optimization and Resource Allocation in Vehicular Networks: A Hierarchical Reinforcement Learning Based Approach
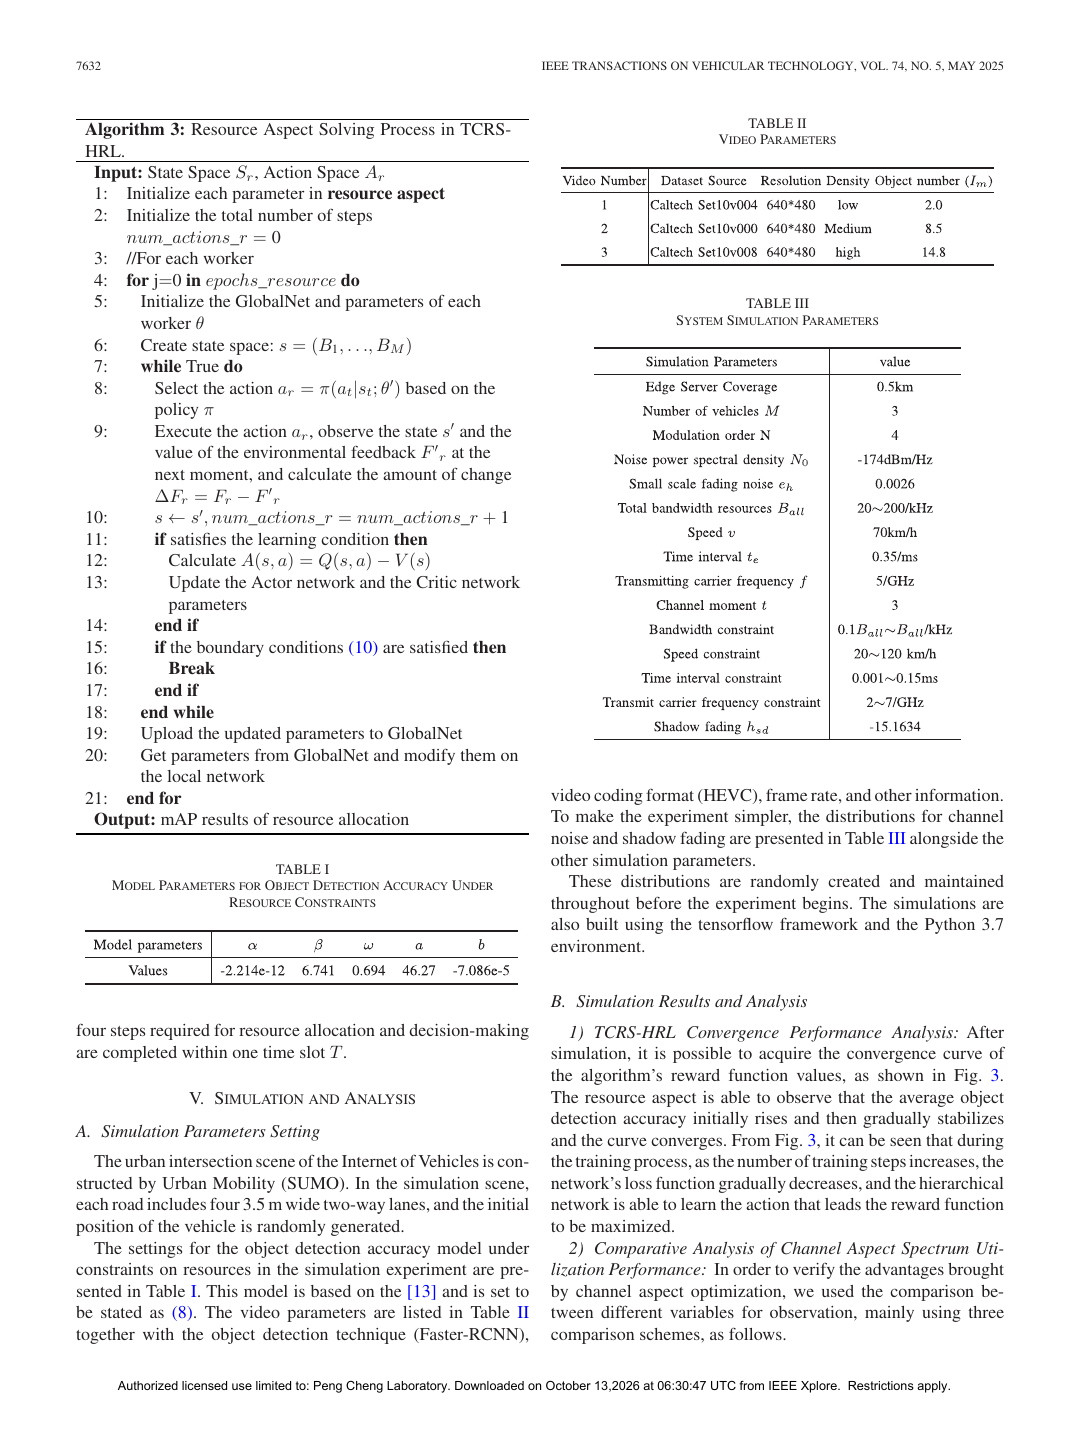
架构/方法图|来源:《Tasks-Oriented Channel Optimization and Resource Allocation in Vehicular Networks: A Hierarchical Reinforcement Learning Based Approach》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Tasks-Oriented Channel Optimization and Resource Allocation in Vehicular Networks: A Hierarchical Reinforcement Learning Based Approach》,原 PDF p.9,Fig. 3 The resource aspect is able to observe that the average object detection accuracy initially rises and then gradually stabilizes and the curve converges 核对论文
仍然存在的问题:然而,双向语义通信仍然是一个未被探索的话题,这是许多机器通信场景中的关键问题。 PDF p.1
为什么已有方法解决不了:为固定 SNR 或带宽训练的模型具有固定瓶颈和保护方式;条件变化时重复运行同一网络,不能把码率或冗余重新分给变得脆弱的信息。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
本文提出什么:然而,双向语义通信仍然是一个未被探索的话题,这是许多机器通信场景中的关键问题。 PDF p.1
方案为何可能有效:简单地将现有的语义通信系统扩展到双向情形需要在训练过程期间进行双向信息反馈,从而导致显著的通信开销。 PDF p.1
作者希望证明什么:仿真结果表明,所提出的TW-SC系统在训练过程中不需要收发机之间的反馈,性能接近于现有的单向语义通信系统。 PDF p.1
方法与端到端信息流
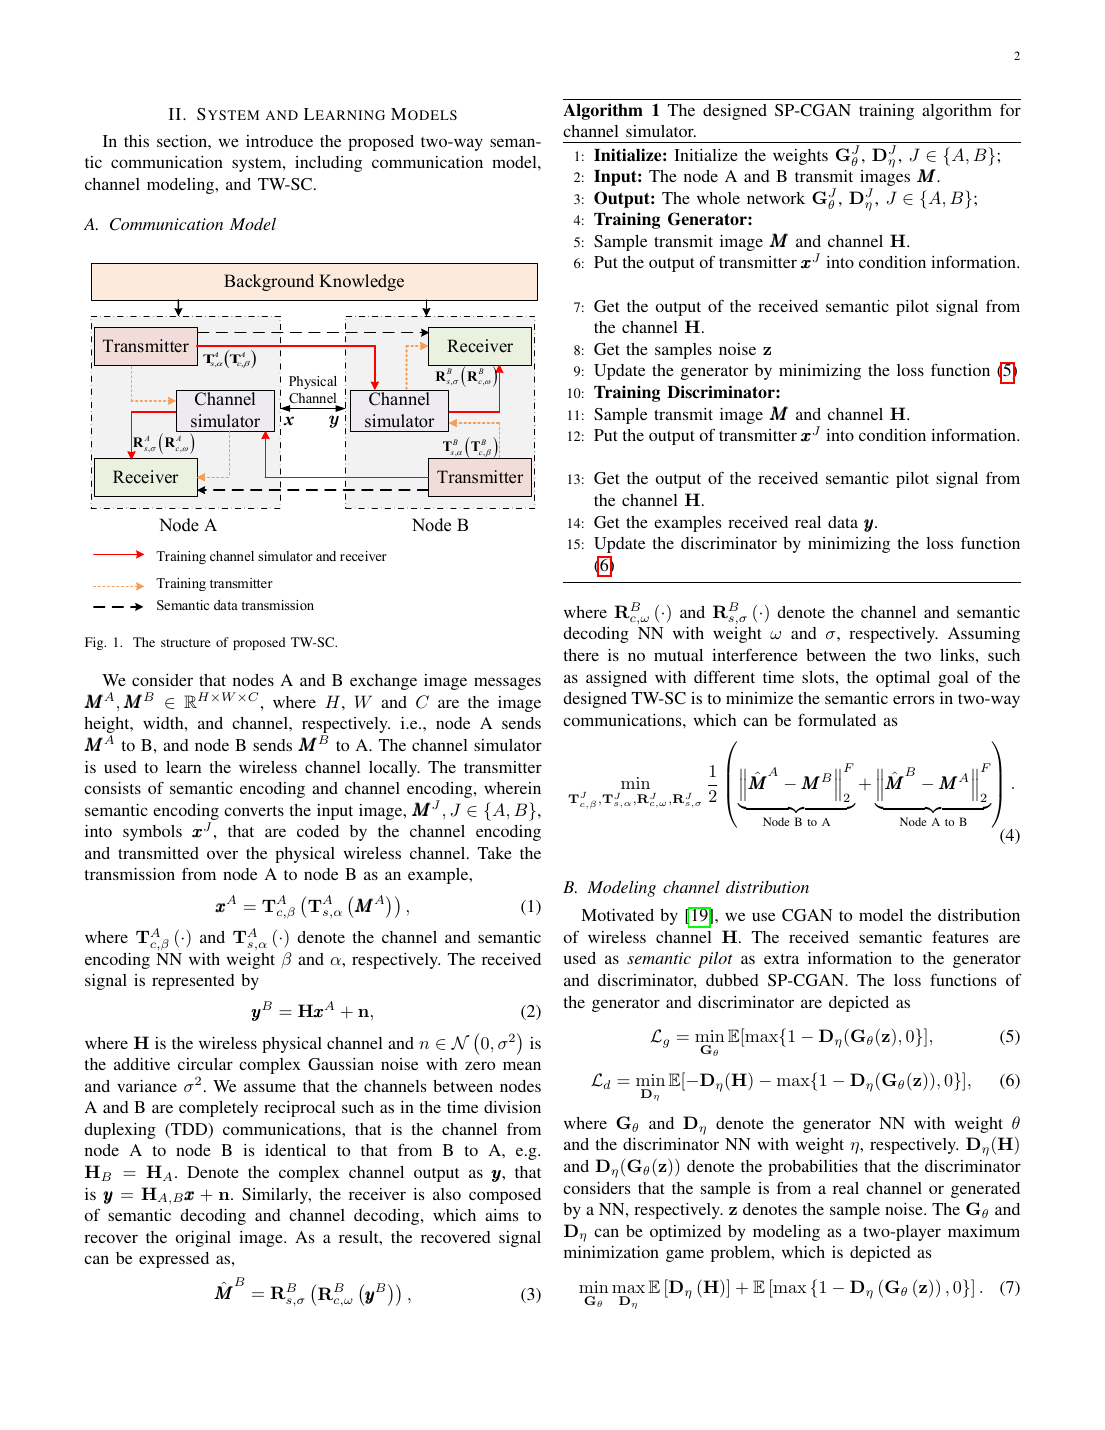
然而,双向语义通信仍然是一个未被探索的主题,这在许多机器通信场景中是一个关键问题。简单地将现有语义通信系统扩展到双向情况需要在训练过程期间进行双向信息反馈,这导致了显著的通信开销。本文介绍了双向semanRx译码AA-Rs,系统,包括Rc,通信模型、M tic信道模型和TW-SC。 PDF p.1PDF p.2
输入输入是图像传输、压缩或生成所需的图像及其视觉/任务语义。
发送端发送端采用 Two-Way Semantic Communications Without Feedback:然而,双向语义通信仍然是一个未被探索的主题,这在许多机器通信场景中是一个关键问题。简单地将现有语义通信系统扩展到双向情况需要在训练过程期间进行双向信息反馈,这导致了显著的通信开销。本文介绍了双向semanRx译码AA-Rs,系统,包括Rc,通信模型、M tic信道模型和TW-SC。
实际发送实际发送对象是语义 feature 或未完整规定 bit 映射的 latent。
信道信道作用方式按“类别 0:信道作用点不足,或由外部传统链路抽象承担”解释。
接收端接收端从论文假设已经恢复的语义特征开始,再执行语义解码、任务推理或生成。
输出最终输出为重建/生成图像或视觉任务输出。
它在通信系统中的位置:让表示维度、保护强度或接收策略随带宽和信道条件变化。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:语义 feature/latent;量化到 bitstream 的接口未完整报告
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“语义 feature/latent;量化到 bitstream 的接口未完整报告”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:Two-Way Semantic Communications Without Feedback 的主传输单位属于“语义 feature/latent;量化到 bitstream 的接口未完整报告”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
论文未同时报告输入尺寸、encoder 输出尺寸、量化精度/码本大小和帧级开销,因此不能从全文唯一重建总 bit 数。页面保留论文实际使用的 CBR、bpp、token 数或信道使用次数;缺失项不作臆测。 PDF p.2PDF p.3
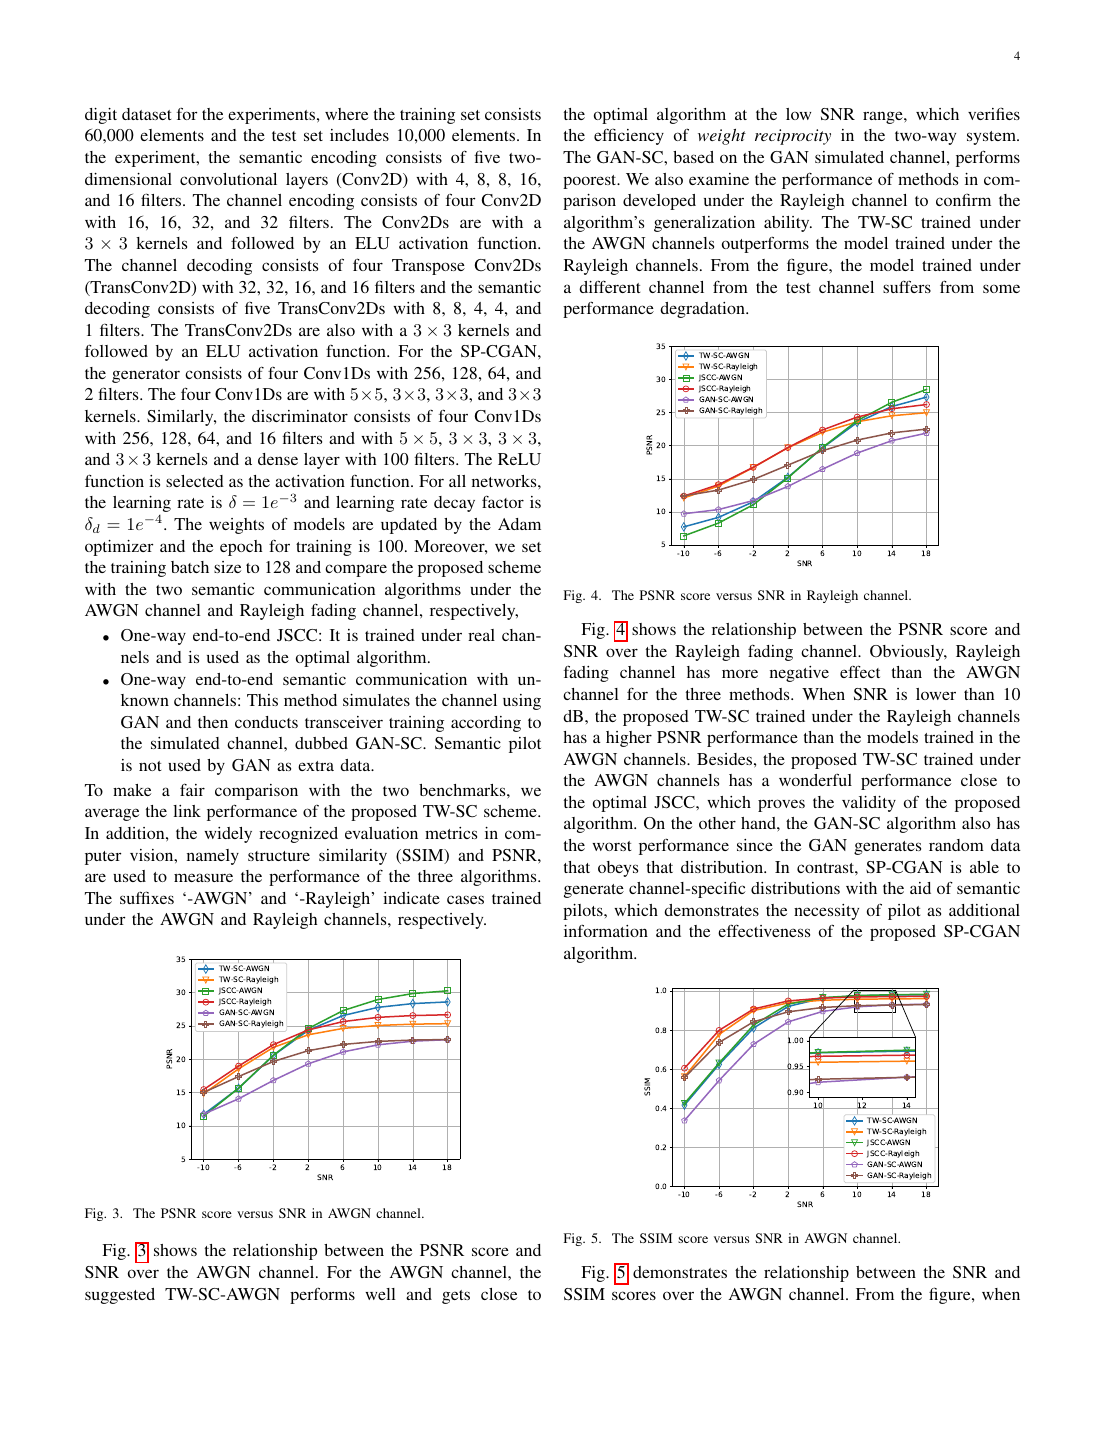
架构/方法图|来源:《Two-Way Semantic Communications Without Feedback》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Two-Way Semantic Communications Without Feedback》,原 PDF p.4,Fig. 3 The PSNR score versus SNR in AWGN channel 核对论文
核心纳入2025通用语义通信系统
Attention-Driven Interference Alignment for Multi-User Semantic Communications
架构/方法图|来源:《Attention-Driven Interference Alignment for Multi-User Semantic Communications》,原 PDF p.2,Fig. 2 Block-level architecture of the attention-based multiplexing scheme 核对论文关键实验结果图/表|来源:《Attention-Driven Interference Alignment for Multi-User Semantic Communications》,原 PDF p.4,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2025语义感知资源分配与网络优化
Bandwidth Management in Semantic Communications: A Tradeoff Between Data Sensing and Transmission
现有进展:语义通信(SemCom)是一种新的范例,其利用复杂的深度学习工具在发送器处从源数据中提取语义特征,并在接收端处基于这些语义特征恢复源数据的含义。 PDF p.1
仍然存在的问题:然而,如果为了获得高性能的SemCom编码模型而执行无休止的感测,则应当占用大量的带宽资源,这可能降低语义频谱效率(SSE)。 PDF p.1
为什么已有方法解决不了:不同论文各自报告准确率或重建指标,不能替代统一、可计算且与通信资源相联系的定义或可达界;缺失的是比较坐标而不是更深的网络。 PDF p.1
为什么这个问题重要:功率、带宽、算力和时延是共享资源;若调度器不知道语义效用,它可能增加吞吐量却没有改善任何用户真正关心的任务。 PDF p.1
本文提出什么:为了训练具有最小语义歧义的熟练语义编码模型,感测用于模型训练和背景知识构建的丰富数据是至关重要的。 PDF p.1
方案为何可能有效:具体来说,我们首先制定了一个优化问题,以最大限度地提高SSE的目标,同时受资源预算和服务质量的要求,联合分配带宽的传感和数据传输。 PDF p.1
作者希望证明什么:此外,数值模拟验证了我们提出的算法的有效性和更优的性能的SSE上,与几个基线相比。 PDF p.1
方法与端到端信息流
为了训练具有最小语义歧义的熟练语义编码模型,感知大量数据对于模型训练和背景知识构建至关重要。具体而言,我们首先制定了一个优化问题,以最大化SSE为目标,同时满足资源预算和服务质量要求,联合分配感知和数据传输的带宽。高数据量可能会占用大量频谱资源,对语义频谱效率(SSE)产生不利影响--本文中感知数据是指数据采集的过程,重点关注数据量的获取,而不是具体的技术实现或感知手段,是衡量系统性能的关键指标。 PDF p.1PDF p.2
架构/方法图|来源:《Bandwidth Management in Semantic Communications: A Tradeoff Between Data Sensing and Transmission》,原 PDF p.4,Fig. 1 The system model is described in detail as follows 核对论文关键实验结果图/表|来源:《Bandwidth Management in Semantic Communications: A Tradeoff Between Data Sensing and Transmission》,原 PDF p.11,Fig. 4 Transmission accuracy of semantic information vs 核对论文
核心纳入2025文本传输或语言任务
Coarse-to-Fine Semantic Communication Systems for Text Transmission
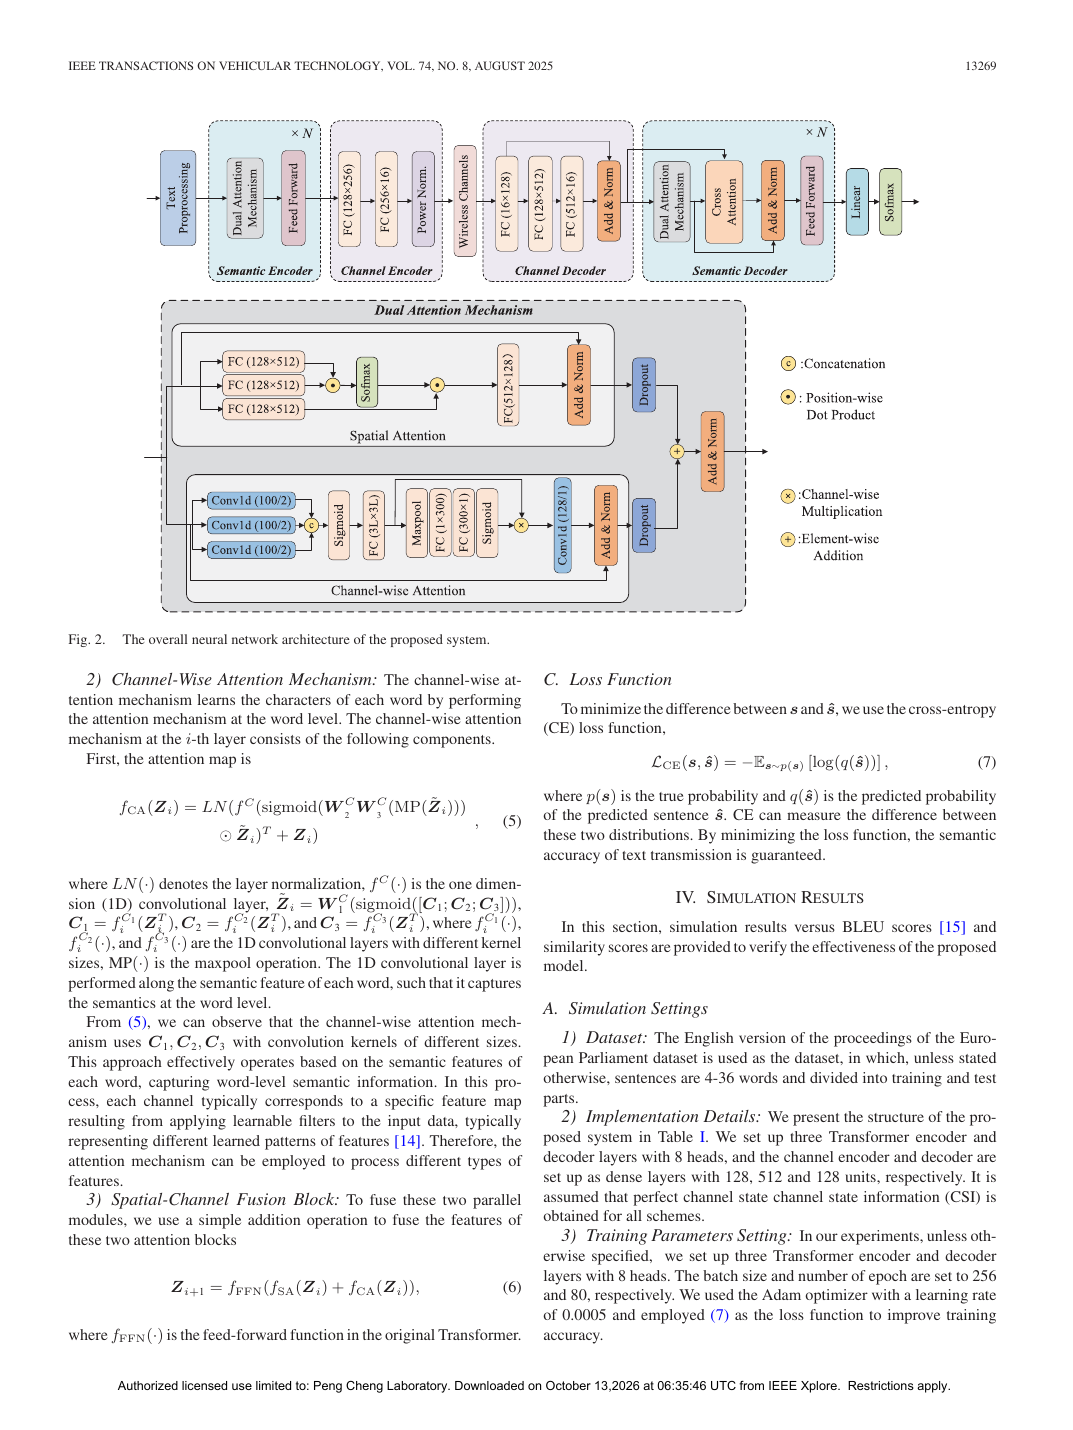
架构/方法图|来源:《Coarse-to-Fine Semantic Communication Systems for Text Transmission》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Coarse-to-Fine Semantic Communication Systems for Text Transmission》,原 PDF p.3,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2025语义感知资源分配与网络优化
Cross-Layer Security for Semantic Communications: Metrics and Optimization
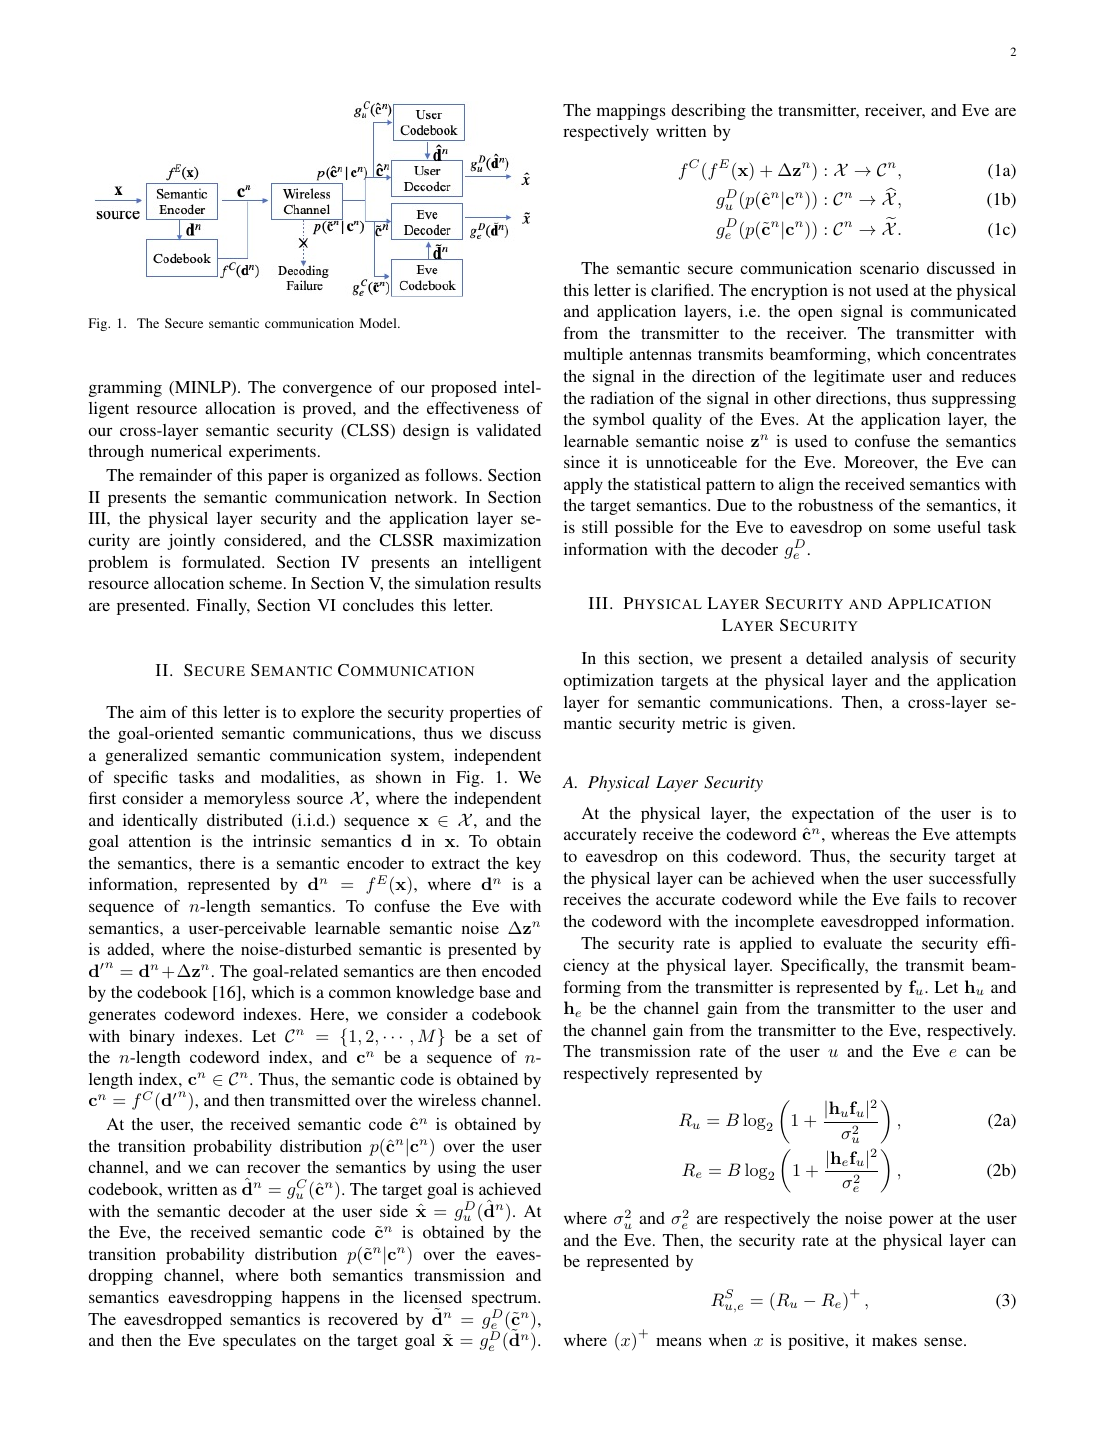
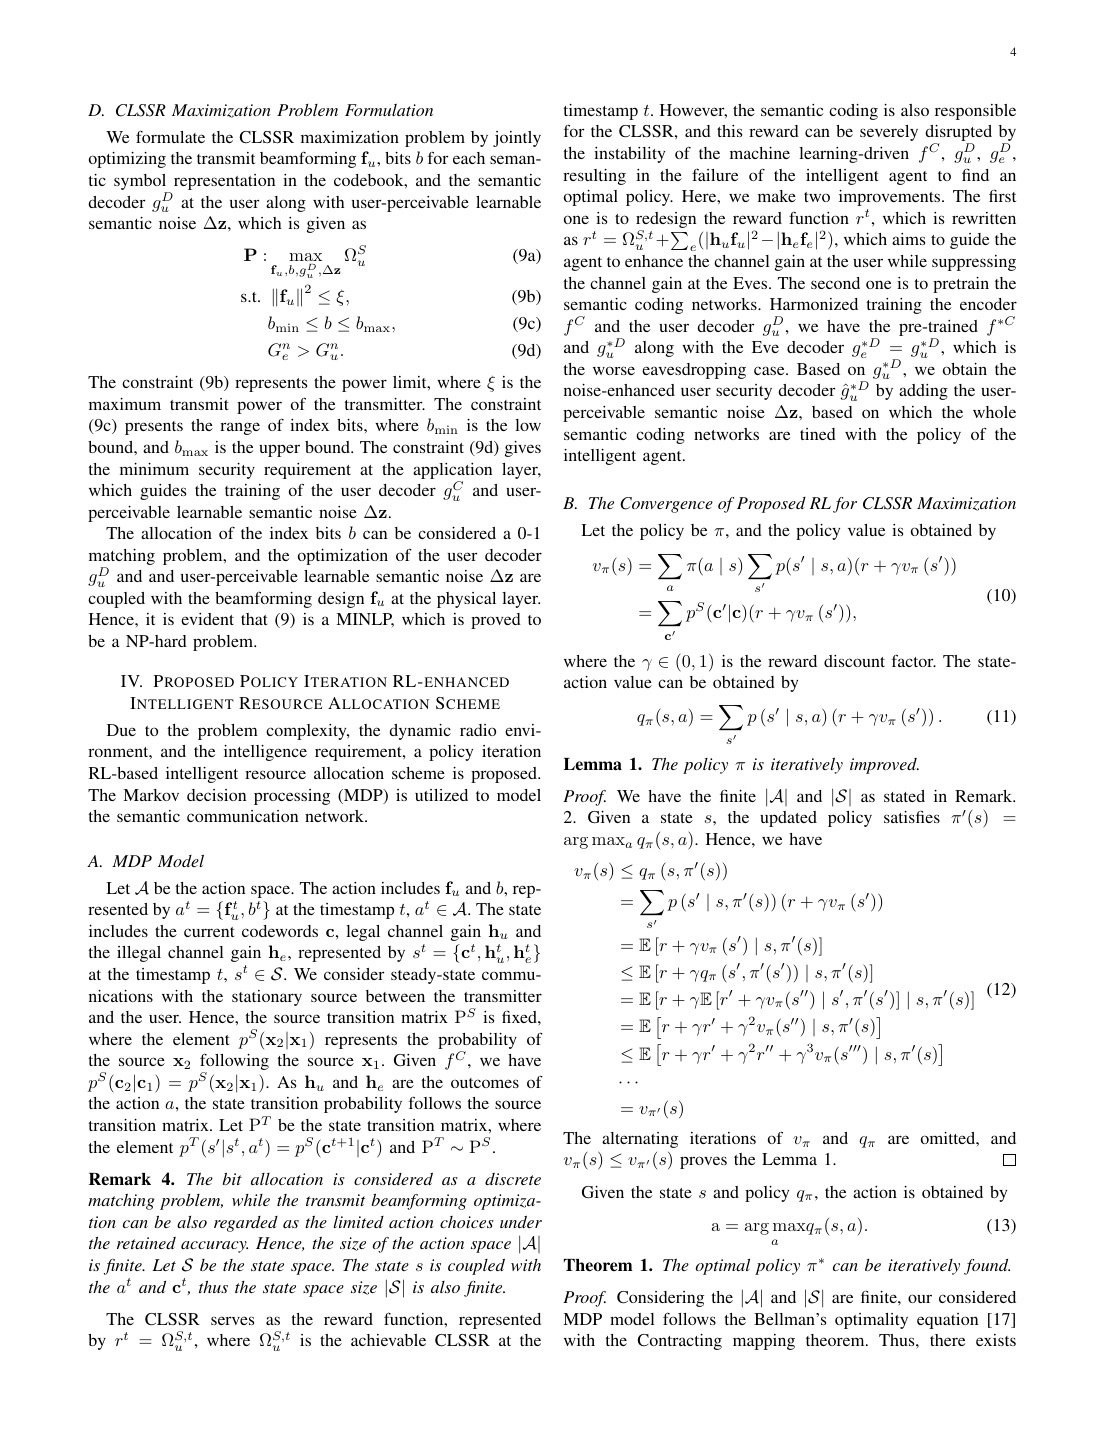
架构/方法图|来源:《Cross-Layer Security for Semantic Communications: Metrics and Optimization》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Cross-Layer Security for Semantic Communications: Metrics and Optimization》,原 PDF p.4,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2025多模态检索与任务通信
Cross-Modal Domain-Adaptive Semantic Communication
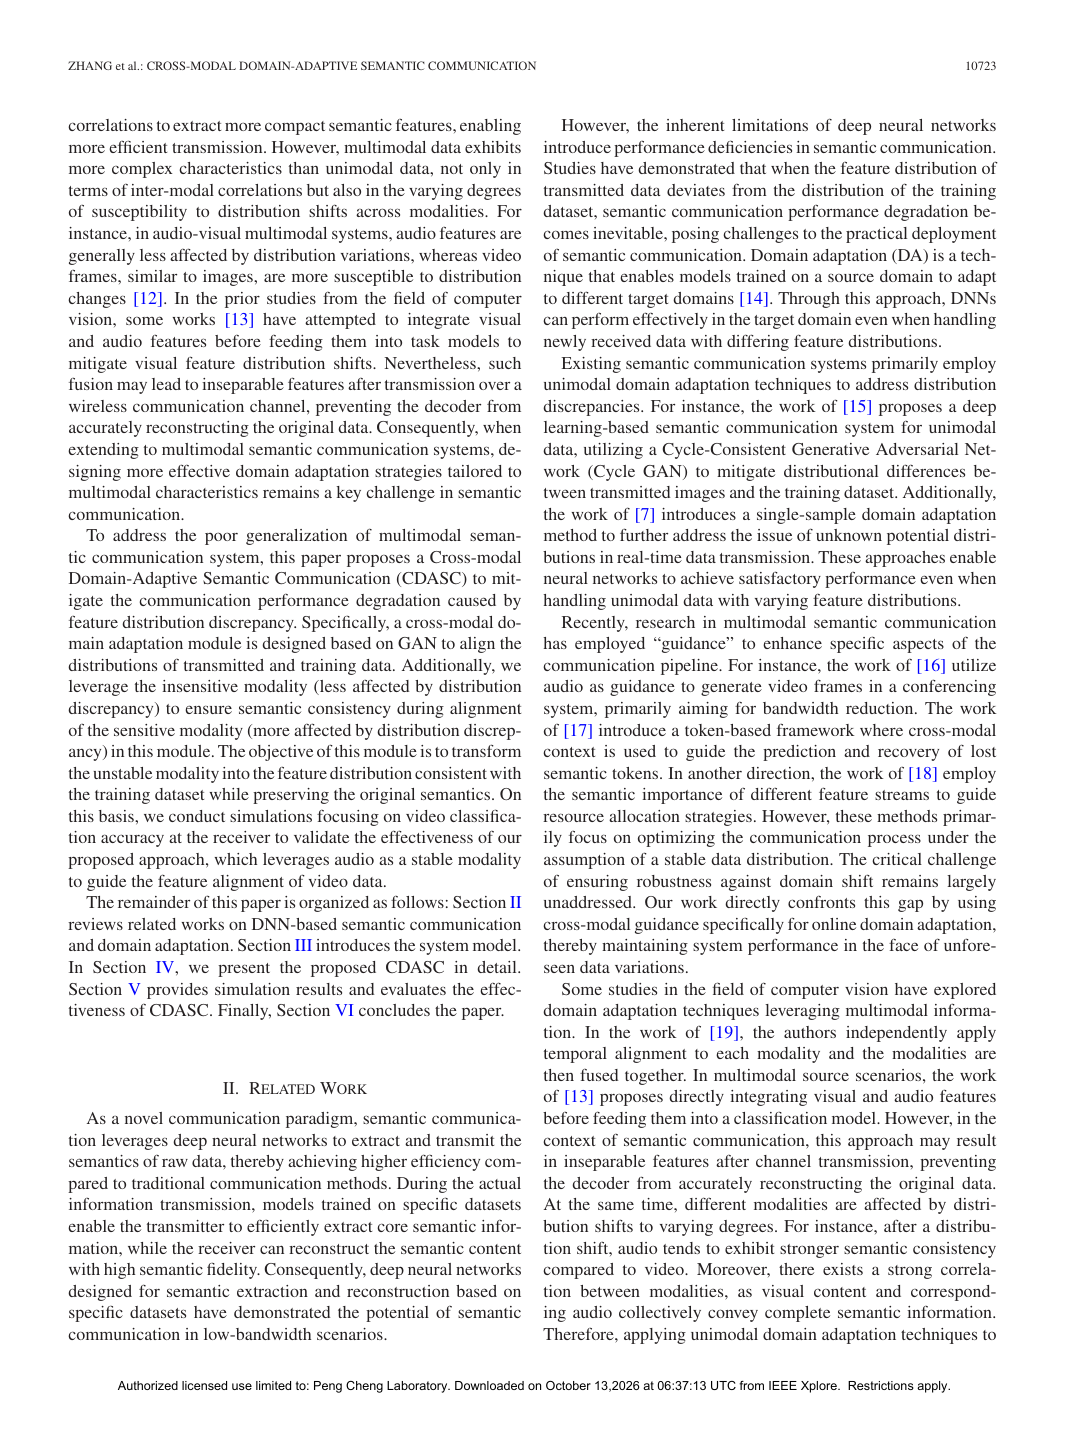
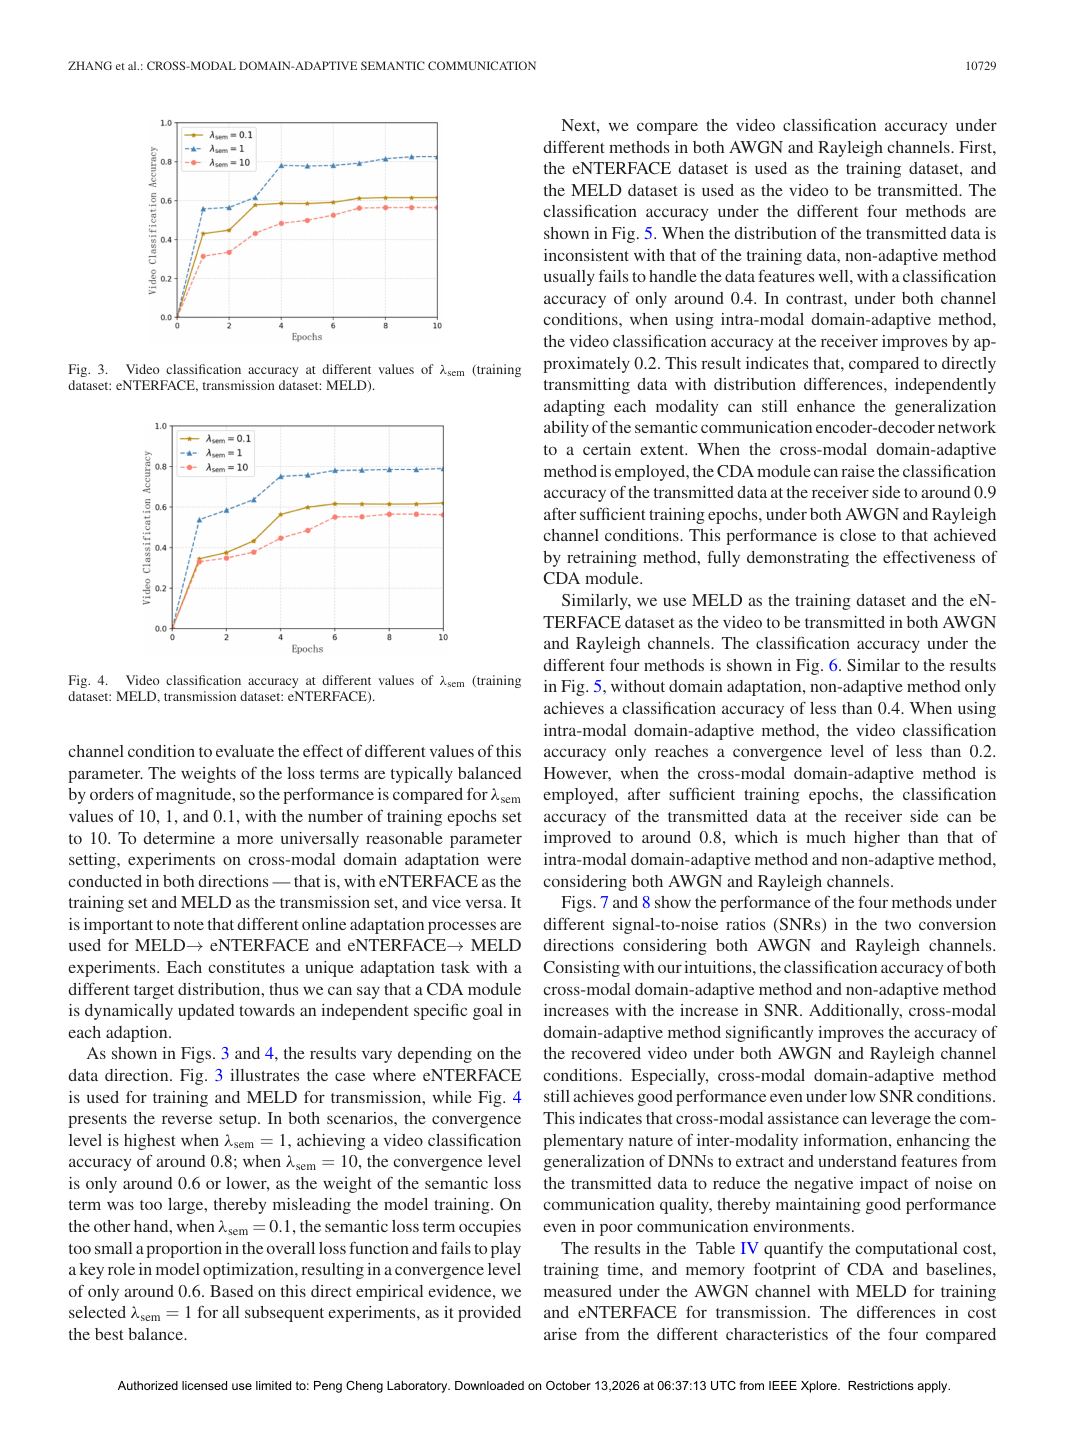
架构/方法图|来源:《Cross-Modal Domain-Adaptive Semantic Communication》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Cross-Modal Domain-Adaptive Semantic Communication》,原 PDF p.8,Fig. 3 Video classification accuracy at different values of λsem (training dataset: eNTERFACE, transmission dataset: MELD) 核对论文
核心纳入2025语义感知资源分配与网络优化
Decentralized Semantic Communication and Cooperative Tracking Control for a UAV Swarm Over Wireless MIMO Fading Channels
现有进展:传统的无人机机群通信策略由于控制信号的频繁交换而导致了过多的带宽消耗和能量开销。 PDF p.1
仍然存在的问题:但是,这些方法都是启发式的,缺乏最优性。 PDF p.1
为什么已有方法解决不了:只按 bit rate、吞吐量或平均失真分配资源,无法区分不同样本和任务的语义价值;外层优化必须得到可用的语义效用—资源曲线。 PDF p.1
为什么这个问题重要:功率、带宽、算力和时延是共享资源;若调度器不知道语义效用,它可能增加吞吐量却没有改善任何用户真正关心的任务。 PDF p.1
本文提出什么:受语义通信范式的启发--强调只传输与任务相关的信息--我们提出了一个协作的语义通信控制框架,该框架选择性地传输信息量最大的控制数据。 PDF p.1
方案为何可能有效:具体地说,我们考虑了一个由一个领导者和多个跟随者组成的无人机群,它们通过不可靠的MIMO无线信道相互连接。 PDF p.1
作者希望证明什么:数值仿真试验进一步验证了所提方法在跟踪精度和通信效率上的优越性。 PDF p.1
方法与端到端信息流
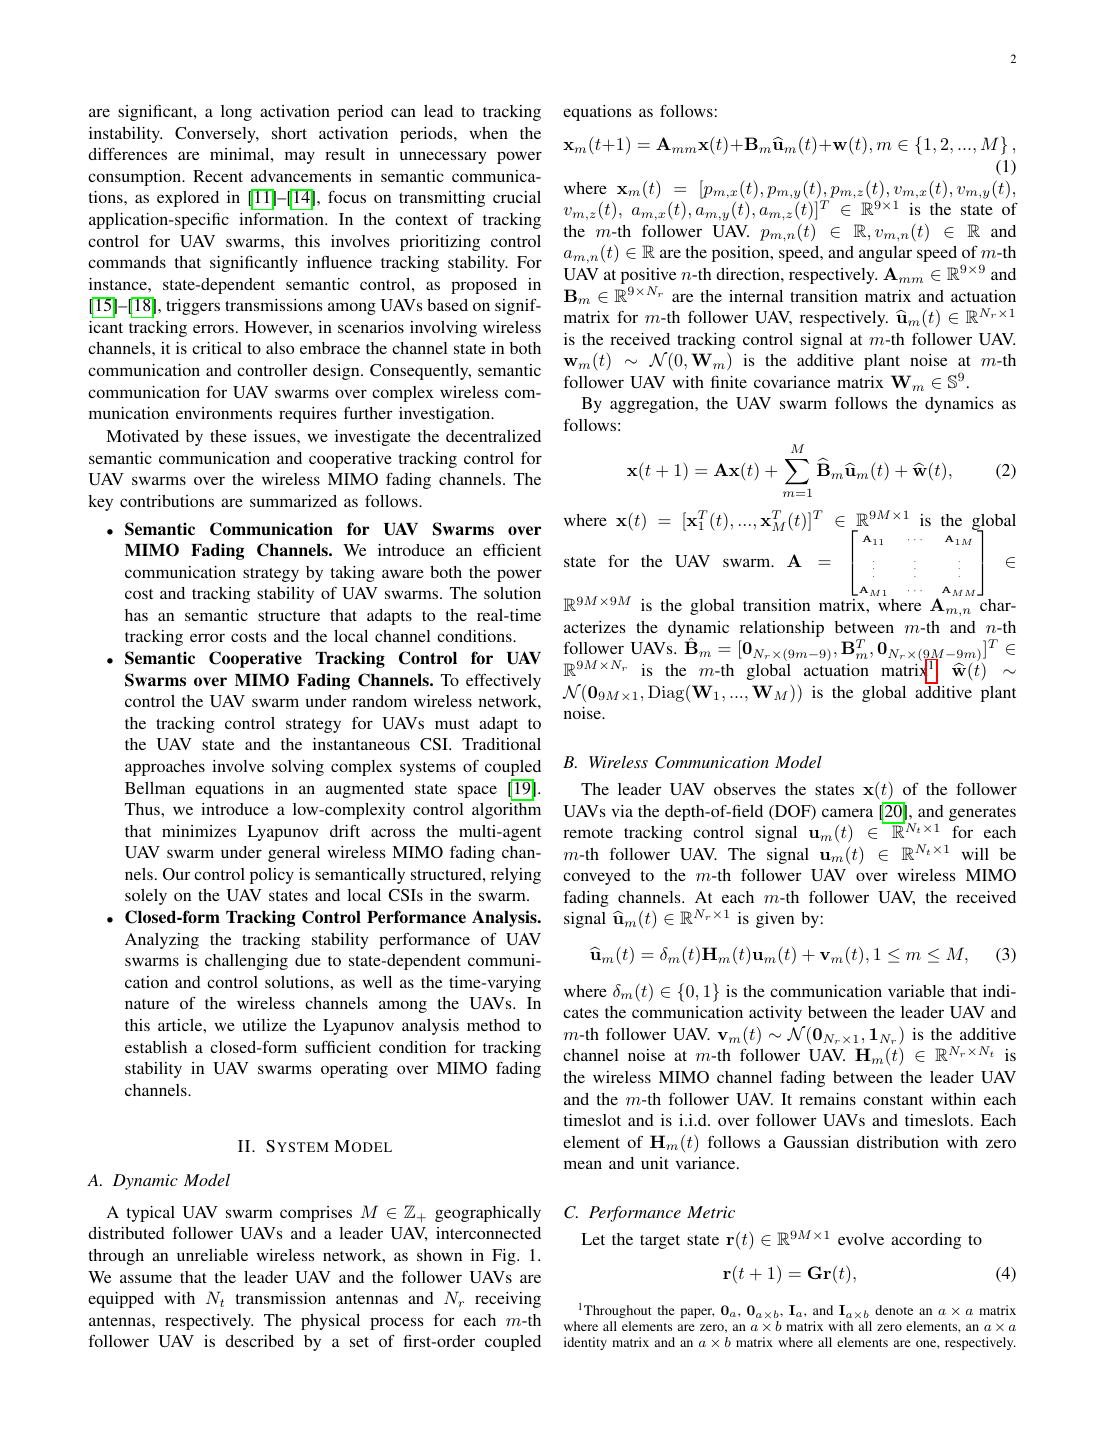
受语义通信范式的启发--强调只传输与任务相关的信息--我们提出了一种协作语义通信-控制框架,该框架选择性地传输信息量最大的控制数据。特别地,我们考虑了一个由一个领导者和多个跟随者组成的无人机群,通过不可靠的MIMO无线信道互连。在本文中,我们利用李亚普诺夫分析方法建立了在MIMO衰落信道上工作的无人机机群中跟踪稳定性的闭合形式的充分条件。 PDF p.1PDF p.2
输入输入是语义感知资源分配与网络优化所需的用户、任务、信道和资源状态。
发送端发送端采用 Decentralized Semantic Communication and Cooperative Tracking Control for a UAV Swarm Over Wireless MIMO Fading Channels:受语义通信范式的启发--强调只传输与任务相关的信息--我们提出了一种协作语义通信-控制框架,该框架选择性地传输信息量最大的控制数据。特别地,我们考虑了一个由一个领导者和多个跟随者组成的无人机群,通过不可靠的MIMO无线信道互连。在本文中,我们利用李亚普诺夫分析方法建立了在MIMO衰落信道上工作的无人机机群中跟踪稳定性的闭合形式的充分条件。
实际发送实际发送对象是系统模型定义的语义速率、任务效用或信道资源变量。
信道信道作用方式按“类别 5:沿用底层链路或抽象速率—效用模型”解释。
接收端接收端从系统公式假设的接收端输出或语义质量曲线开始,再执行语义解码、任务推理或生成。
输出最终输出为资源/部署策略及其语义效用。
它在通信系统中的位置:把语义/任务质量映射为网络效用,再分配功率、带宽、算力或时延。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:上层理论/资源变量;论文不单独定义可发送语义格式
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“上层理论/资源变量;论文不单独定义可发送语义格式”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:Decentralized Semantic Communication and Cooperative Tracking Control for a UAV Swarm Over Wireless MIMO Fading Channels 的主传输单位属于“上层理论/资源变量;论文不单独定义可发送语义格式”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
论文优化的是功率、带宽、时隙、用户调度或语义效用等上层资源变量,并未定义一条可逐 bit 复现的语义 codec。因而这里只报告系统约束和效用曲线,不能从优化变量反推 token/index 总 bit 数。 PDF p.2PDF p.5
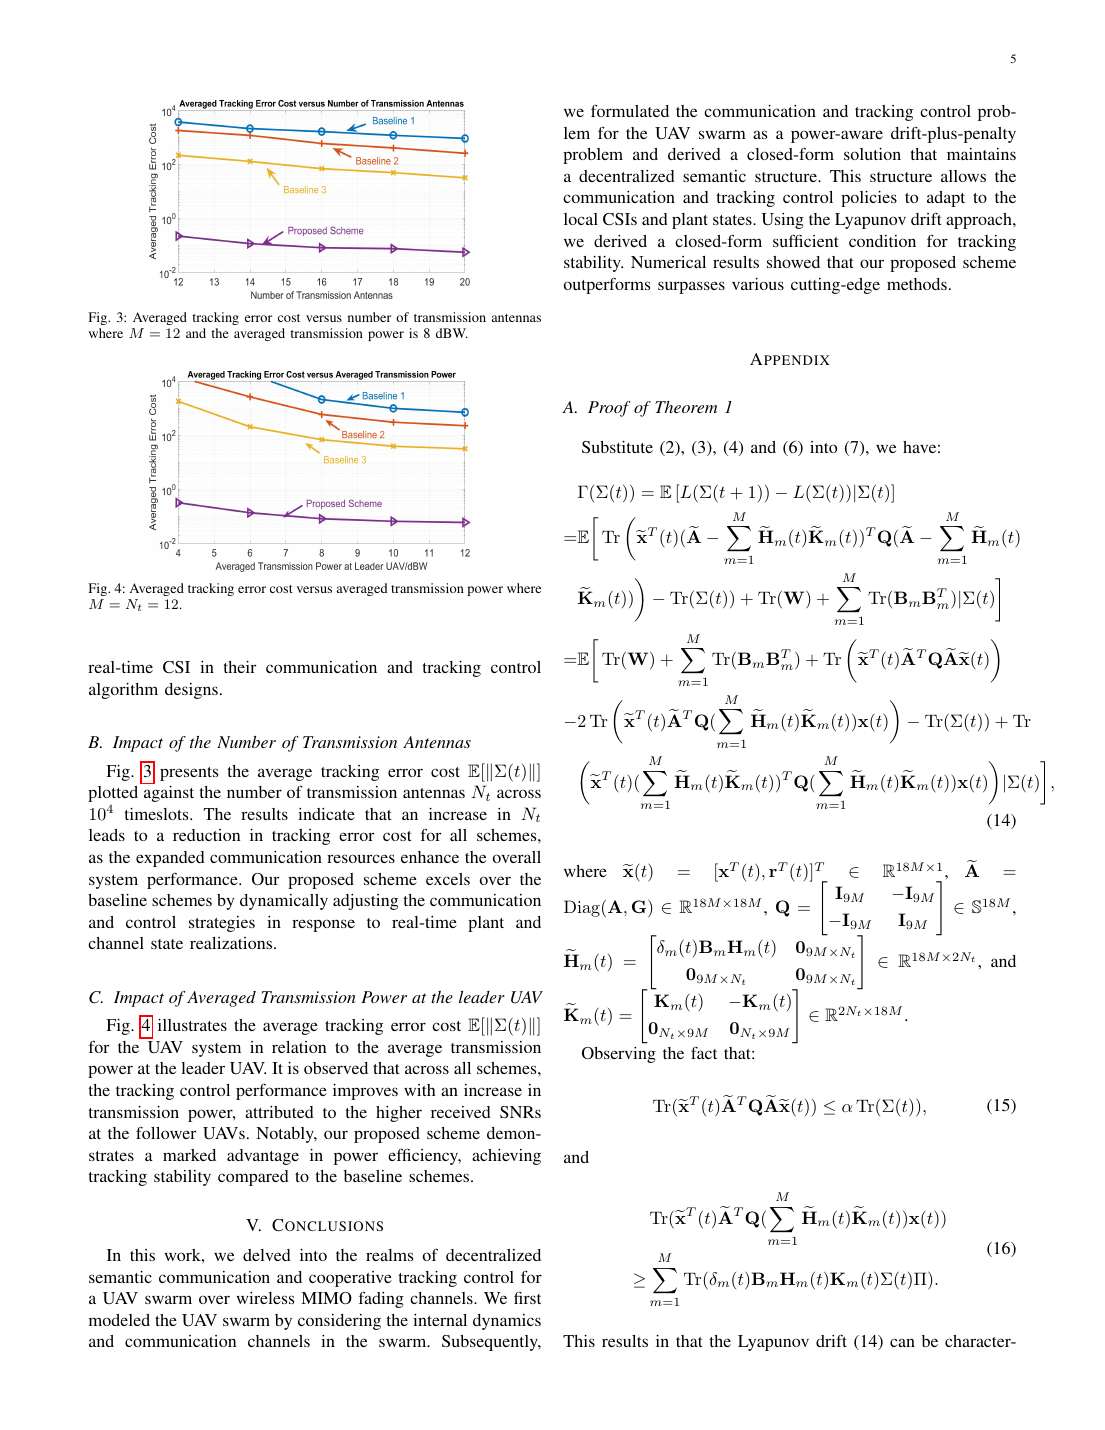
架构/方法图|来源:《Decentralized Semantic Communication and Cooperative Tracking Control for a UAV Swarm Over Wireless MIMO Fading Channels》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Decentralized Semantic Communication and Cooperative Tracking Control for a UAV Swarm Over Wireless MIMO Fading Channels》,原 PDF p.5,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2025语义感知资源分配与网络优化
Delay-Aware Digital Twin Synchronization in Mobile Edge Networks With Semantic Communications
为什么已有方法解决不了:连续 latent 或独立设计的传统链路没有回答语义特征怎样量化、映射为有限符号,以及 bit/index 出错后为何不会跳到完全不同的语义。仅改进信源网络无法补上这一接口。 PDF p.1
为什么这个问题重要:功率、带宽、算力和时延是共享资源;若调度器不知道语义效用,它可能增加吞吐量却没有改善任何用户真正关心的任务。 PDF p.1
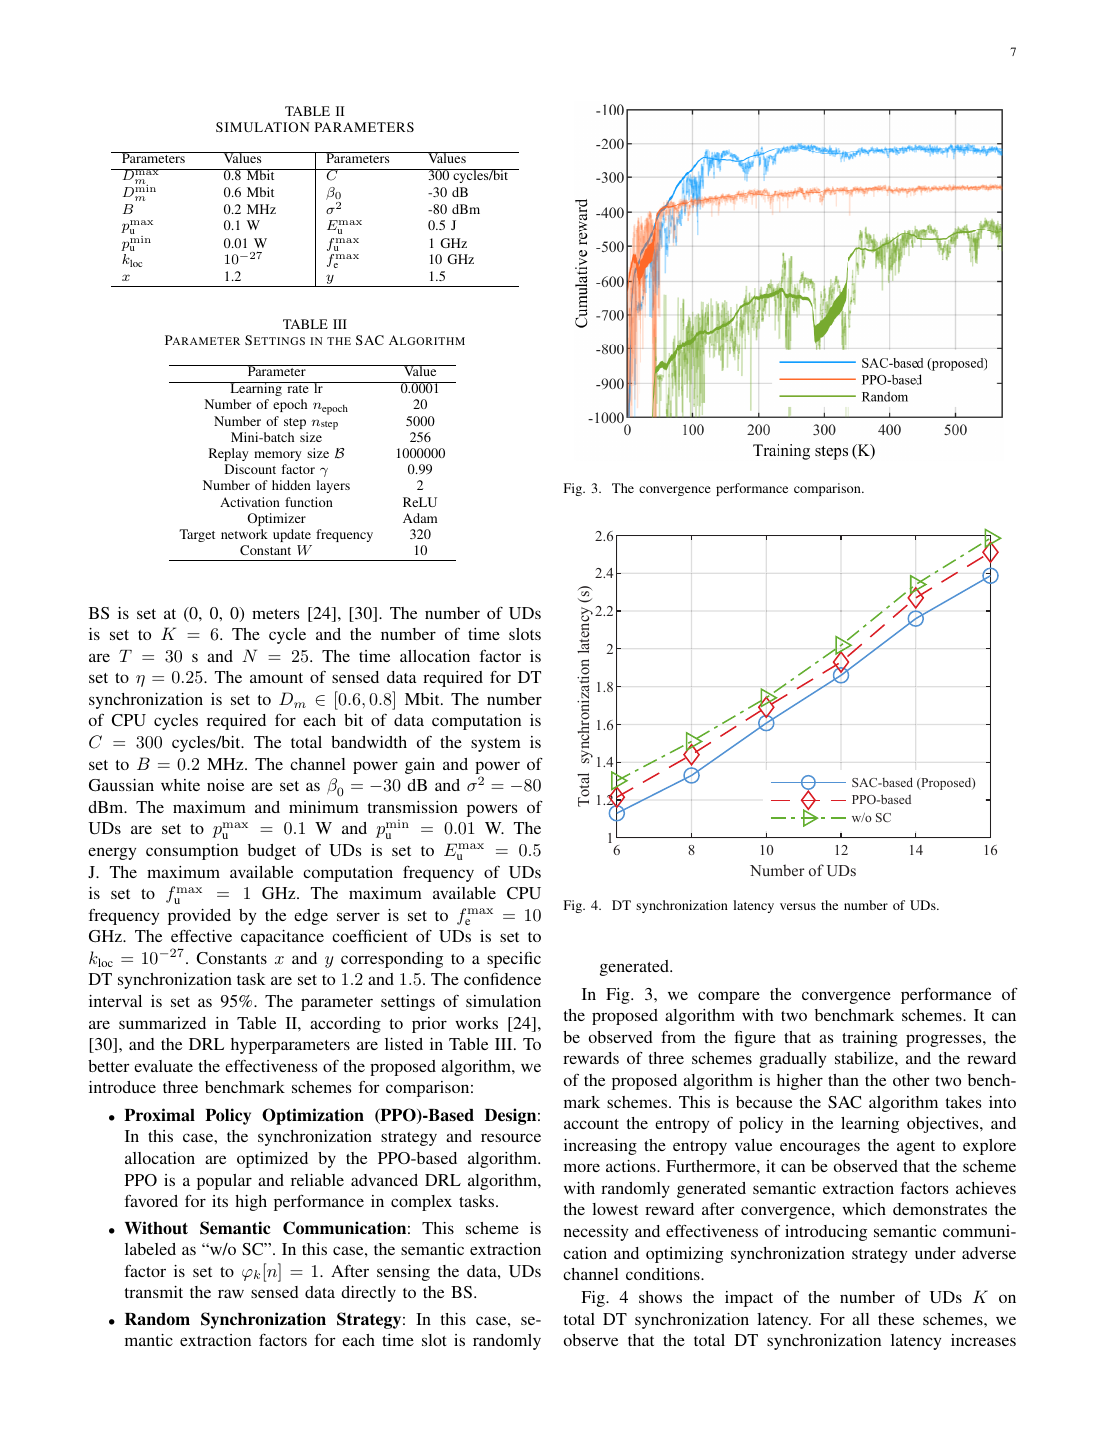
本文提出什么:为了有效解决这一具有挑战性的优化问题,提出了一种基于软行为者-批评者的深度强化学习算法来优化同步策略和资源分配。 PDF p.1
方案为何可能有效:我们的目标是通过联合优化同步策略、UD的发射功率以及UD和基站的计算资源分配来最小化所有UD的平均DT同步延迟。 PDF p.1
作者希望证明什么:数值结果表明,本算法与其他基准方案相比,同步延迟减少了13.2%,同步效率得到了显著提高。 PDF p.1
方法与端到端信息流
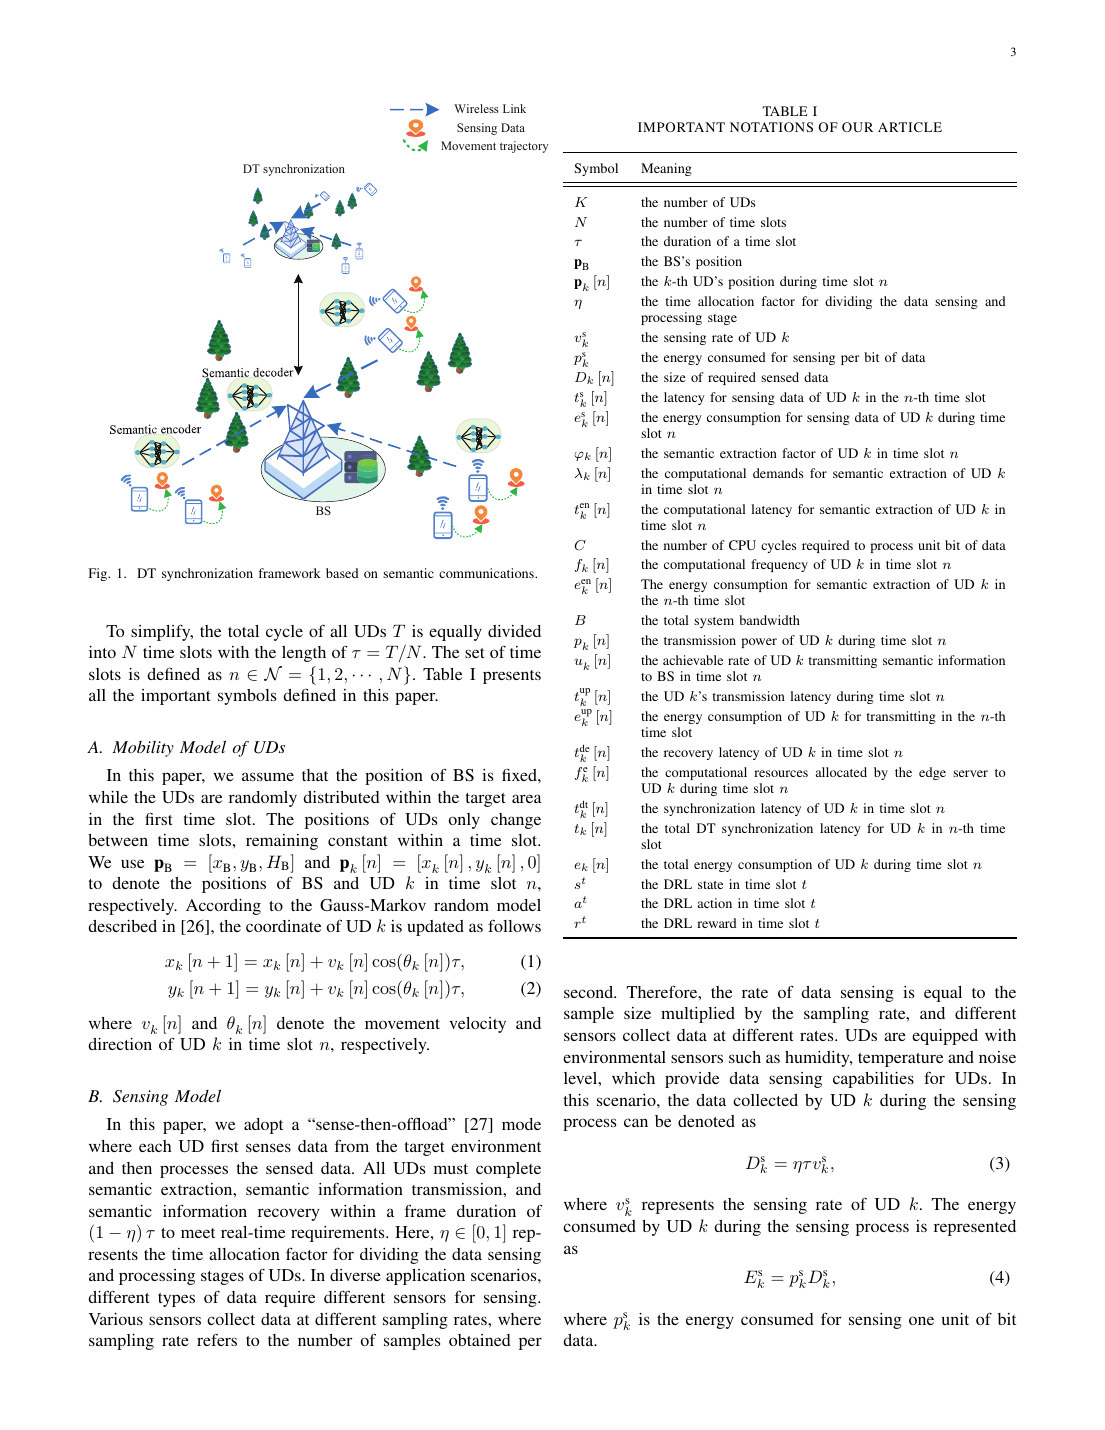
为了有效地解决这一具有挑战性的优化问题,本文提出了一种基于软行动者-批评的深度强化学习算法来优化同步策略和资源分配。我们的目标是通过联合优化同步策略、用户设备的发射功率以及用户设备和基站的计算资源分配来最小化所有用户设备的平均DT同步延迟。与传统的同步方法相比,我们提出的框架要求在传输之前对UD收集的原始感测数据进行语义提取,然后在边缘服务器上恢复语义信息。 PDF p.1PDF p.2
架构/方法图|来源:《Delay-Aware Digital Twin Synchronization in Mobile Edge Networks With Semantic Communications》,原 PDF p.3,Fig. 1 DT synchronization framework based on semantic communications 核对论文关键实验结果图/表|来源:《Delay-Aware Digital Twin Synchronization in Mobile Edge Networks With Semantic Communications》,原 PDF p.7,Fig. 4 DT synchronization latency versus the number of UDs 核对论文
相关但非核心2025语义感知资源分配与网络优化
Distributed Hierarchical Deep Reinforcement Learning for Semantic-Aware Resource Allocation
现有进展:超越传统的注重比特传输的体验质量(QoE)优化,考虑语义QoE可以更好地优化网络,提升用户体验。 PDF p.1
仍然存在的问题:然而,跨网络和链路级别的目标的联合优化呈现出显著的复杂性。 PDF p.1
为什么已有方法解决不了:只按 bit rate、吞吐量或平均失真分配资源,无法区分不同样本和任务的语义价值;外层优化必须得到可用的语义效用—资源曲线。 PDF p.1
为什么这个问题重要:功率、带宽、算力和时延是共享资源;若调度器不知道语义效用,它可能增加吞吐量却没有改善任何用户真正关心的任务。 PDF p.1
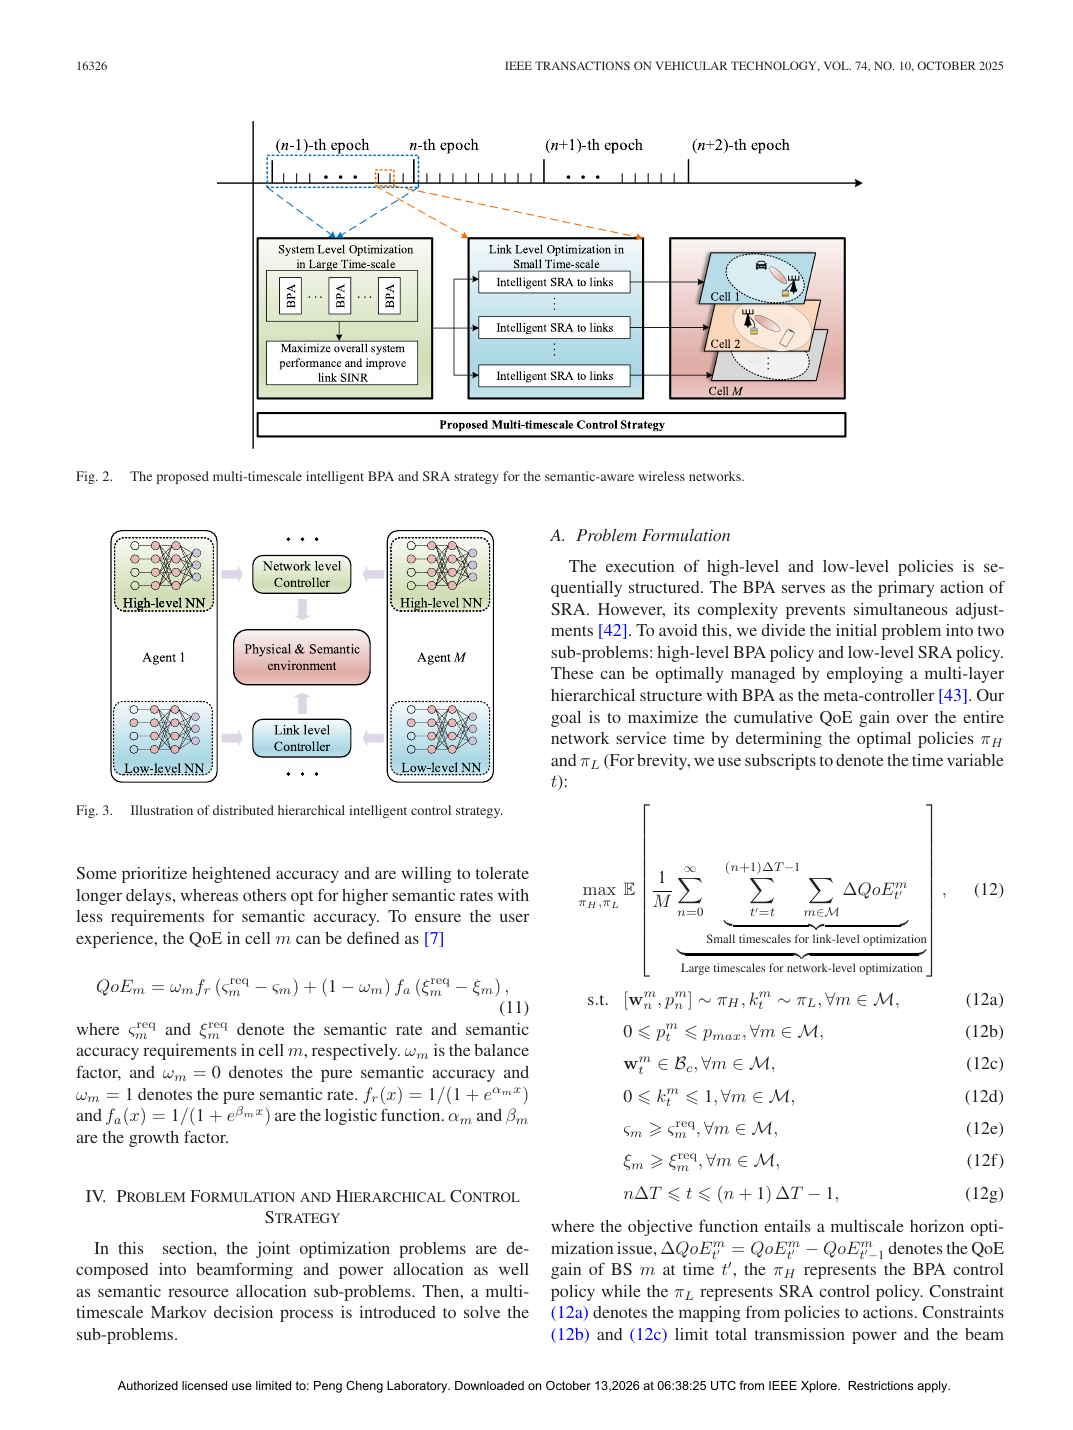
本文提出什么:本文提出了一种新的分布式分层深度强化学习(DHDRL)框架,该框架在不同的时间尺度上采用两层控制策略,以优化下行多小区网络中的QoE,包括语义速率和准确性。 PDF p.1
方案为何可能有效:具体来说,我们分解的优化问题分为两个子问题,波束形成和功率分配以及语义资源分配,从而在一个无限时域离散和有限时域连续时间马尔可夫决策过程。 PDF p.1
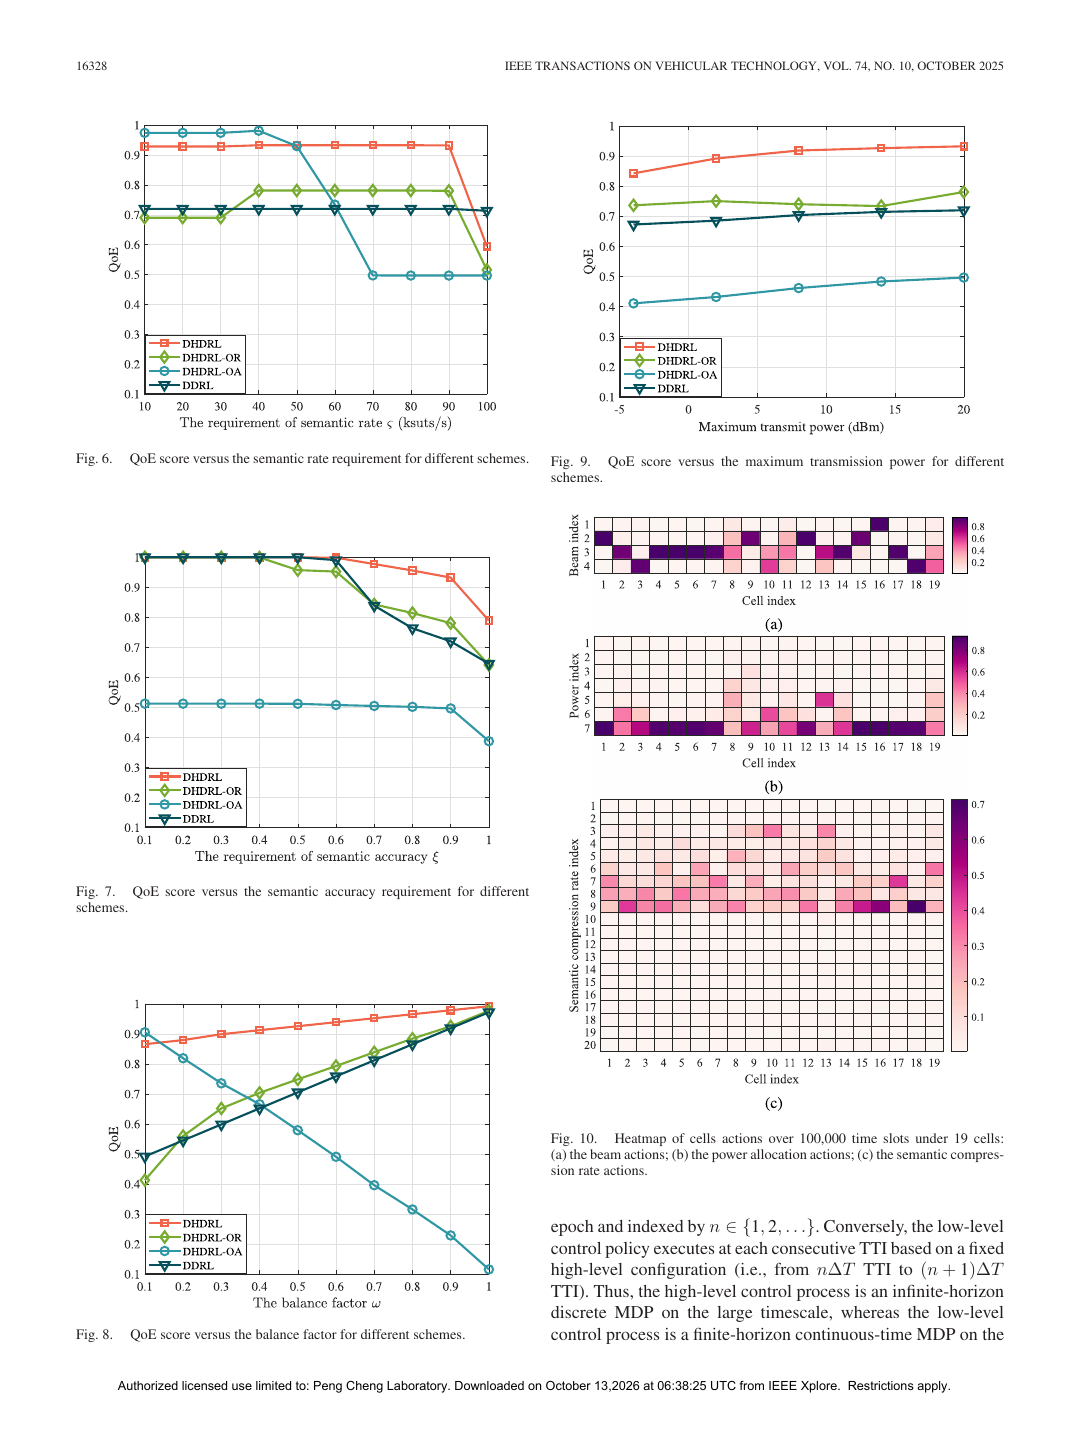
作者希望证明什么:数值结果表明,DHDRL实现了至少19.07%的性能增益比单层方法,保持在高维场景的有效性,并表现出很强的泛化能力,在各种多目标优化问题。 PDF p.1
方法与端到端信息流
本文提出了一种新的分布式分层深度强化学习(DHDRL)框架,在不同的时间尺度上采用两层控制策略来优化下行多小区网络中的QoE,包括语义速率和准确率。具体来说,我们将优化问题分解为两个子问题:波束成形和功率分配以及语义资源分配,在本文中,我们提出了一种分布式分层深度强化学习(DHDRL)框架,以最大限度地提高整个无线网络在两个时间分辨率下的QoE性能,其中,所述小区间干扰在网络级以粗粒度维度进行优化,并且所述实时语义资源在链路级以更精细的时间尺度进行优化。 PDF p.1PDF p.2
输入输入是语义感知资源分配与网络优化所需的用户、任务、信道和资源状态。
发送端发送端采用 Distributed Hierarchical Deep Reinforcement Learning for Semantic-Aware Resource Allocation:本文提出了一种新的分布式分层深度强化学习(DHDRL)框架,在不同的时间尺度上采用两层控制策略来优化下行多小区网络中的QoE,包括语义速率和准确率。具体来说,我们将优化问题分解为两个子问题:波束成形和功率分配以及语义资源分配,在本文中,我们提出了一种分布式分层深度强化学习(DHDRL)框架,以最大限度地提高整个无线网络在两个时间分辨率下的QoE性能,其中,所述小区间干扰在网络级以粗粒度维度进行优化,并且所述实时语义资源在链路级以更精细的时间尺度进行优化。
实际发送实际发送对象是系统模型定义的语义速率、任务效用或信道资源变量。
信道信道作用方式按“类别 5:沿用底层链路或抽象速率—效用模型”解释。
接收端接收端从系统公式假设的接收端输出或语义质量曲线开始,再执行语义解码、任务推理或生成。
输出最终输出为资源/部署策略及其语义效用。
它在通信系统中的位置:把语义/任务质量映射为网络效用,再分配功率、带宽、算力或时延。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:上层理论/资源变量;论文不单独定义可发送语义格式
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“上层理论/资源变量;论文不单独定义可发送语义格式”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:Distributed Hierarchical Deep Reinforcement Learning for Semantic-Aware Resource Allocation 的主传输单位属于“上层理论/资源变量;论文不单独定义可发送语义格式”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
论文优化的是功率、带宽、时隙、用户调度或语义效用等上层资源变量,并未定义一条可逐 bit 复现的语义 codec。因而这里只报告系统约束和效用曲线,不能从优化变量反推 token/index 总 bit 数。 PDF p.2PDF p.10
架构/方法图|来源:《Distributed Hierarchical Deep Reinforcement Learning for Semantic-Aware Resource Allocation》,原 PDF p.5,Fig. 2 The proposed multi-timescale intelligent BPA and SRA strategy for the semantic-aware wireless networks 核对论文关键实验结果图/表|来源:《Distributed Hierarchical Deep Reinforcement Learning for Semantic-Aware Resource Allocation》,原 PDF p.7,Fig. 6 QoE score versus the semantic rate requirement for different schemes 核对论文
核心纳入2025多模态检索与任务通信
Generative Semantic Communication via Textual Prompts: Latency Performance Tradeoffs
架构/方法图|来源:《Generative Semantic Communication via Textual Prompts: Latency Performance Tradeoffs》,原 PDF p.4,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Generative Semantic Communication via Textual Prompts: Latency Performance Tradeoffs》,原 PDF p.5,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2025视频传输、生成或控制
Generative Video Semantic Communication via Multimodal Semantic Fusion With Large Model
现有进展:尽管基于香农理论的传统语法通信取得了显着进步,但这些方法仍难以满足6G沉浸式通信的要求,尤其是在具有挑战性的传输条件下。 PDF p.1
仍然存在的问题:然而,DJSCC框架依赖于率失真理论,并且无法优化对人类至关重要的感知质量。 PDF p.1
为什么已有方法解决不了:分离压缩与信道编码优化的是中间 bit 可靠性,未必等价于本文关心的语义/任务质量;反过来,只做端到端网络而不交代带宽、功率和信道作用点也无法形成公平通信比较。 PDF p.1
为什么这个问题重要:视频持续占用带宽且具有严格时延,单帧错误还会跨帧传播;通信系统必须同时处理时序一致性、资源占用和渐进退化。 PDF p.1
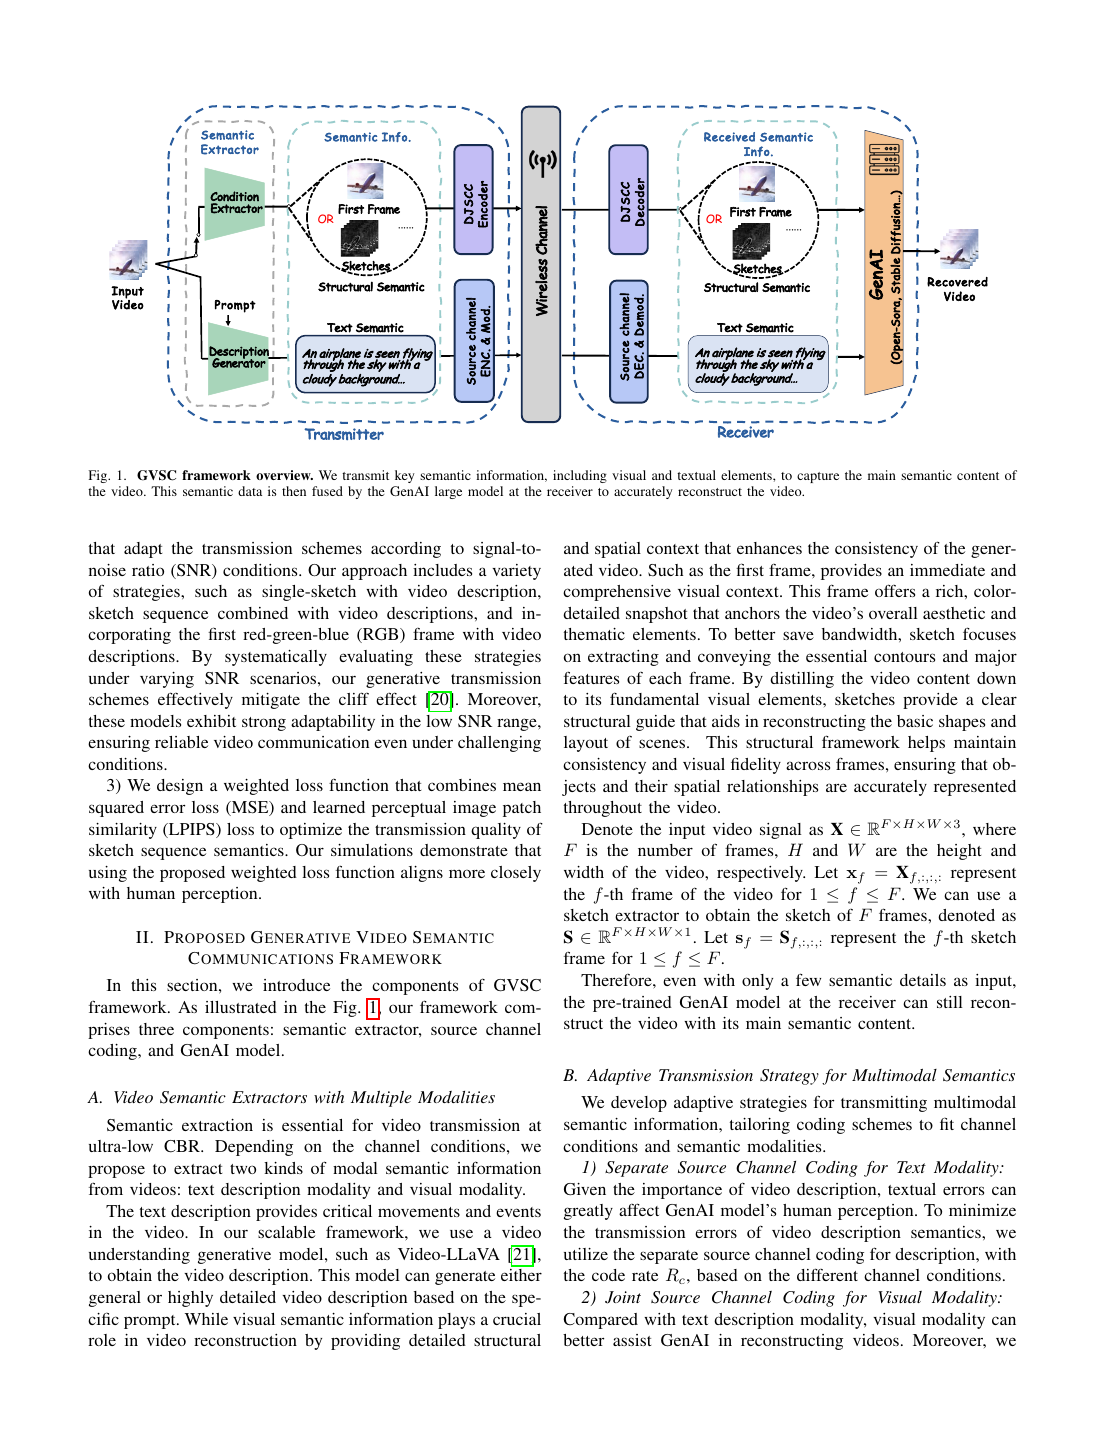
本文提出什么:在本文中,我们提出了一个可扩展的生成视频语义通信框架,提取和传输语义信息,以实现高质量的视频重建。 PDF p.1
方案为何可能有效:具体地,在发送器处,从源视频中提取描述和其他条件信号(例如,第一帧、草图等),分别用作文本和结构语义。 PDF p.1
作者希望证明什么:仿真结果表明,在超低的信道带宽比(CBR),我们的计划有效地捕捉语义信息,以重建符合人类的感知在不同的信噪比下的视频。 PDF p.1
方法与端到端信息流
本文提出了一种可伸缩的生成式视频语义通信框架,通过提取和传输语义信息实现高质量的视频重构。具体来说,在发送端,描述等条件信号(例如,第一帧、草图等)从源视频中提取,用作文本和结构语义,我们的模拟表明,使用所提出的加权损失函数更接近于人类感知。 PDF p.1PDF p.2
输入输入是视频传输、生成或控制所需的视频帧、运动信息或时序语义。
发送端发送端采用 Generative Video Semantic Communication via Multimodal Semantic Fusion With Large Model:本文提出了一种可伸缩的生成式视频语义通信框架,通过提取和传输语义信息实现高质量的视频重构。具体来说,在发送端,描述等条件信号(例如,第一帧、草图等)从源视频中提取,用作文本和结构语义,我们的模拟表明,使用所提出的加权损失函数更接近于人类感知。
实际发送实际发送对象是功率归一化的实数或复数神经信道符号。
信道信道作用方式按“类别 3:连续语义变量直接经过有噪声信道并端到端恢复”解释。
接收端接收端从AWGN/衰落作用后的带噪连续符号开始,再执行语义解码、任务推理或生成。
输出最终输出为重建/生成视频或视频任务结果。
它在通信系统中的位置:在同一系统中共同设计压缩、语义保真和抗信道噪声机制。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:连续神经 JSCC latent / 实复信道符号
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“连续神经 JSCC latent / 实复信道符号”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:Generative Video Semantic Communication via Multimodal Semantic Fusion With Large Model 的主传输单位属于“连续神经 JSCC latent / 实复信道符号”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
是否真正处理离散变量出错:不适用 VQ index 跳变。论文处理的是连续噪声/衰落;这不能自动证明量化和调制后的数字链路鲁棒性。
实验设置与主要结论
数据集/场景全文未稳定定位
BaselineH.264、H.265、JSCC、LDPC、QAM、BERT、CLIP
评价指标PSNR、SSIM
信道与工作点AWGN、SNR = 10 dB、SNR = 0 dB、CBR of 10、CBR of 0.0031、CBR = 0.005、CBR of 0.004
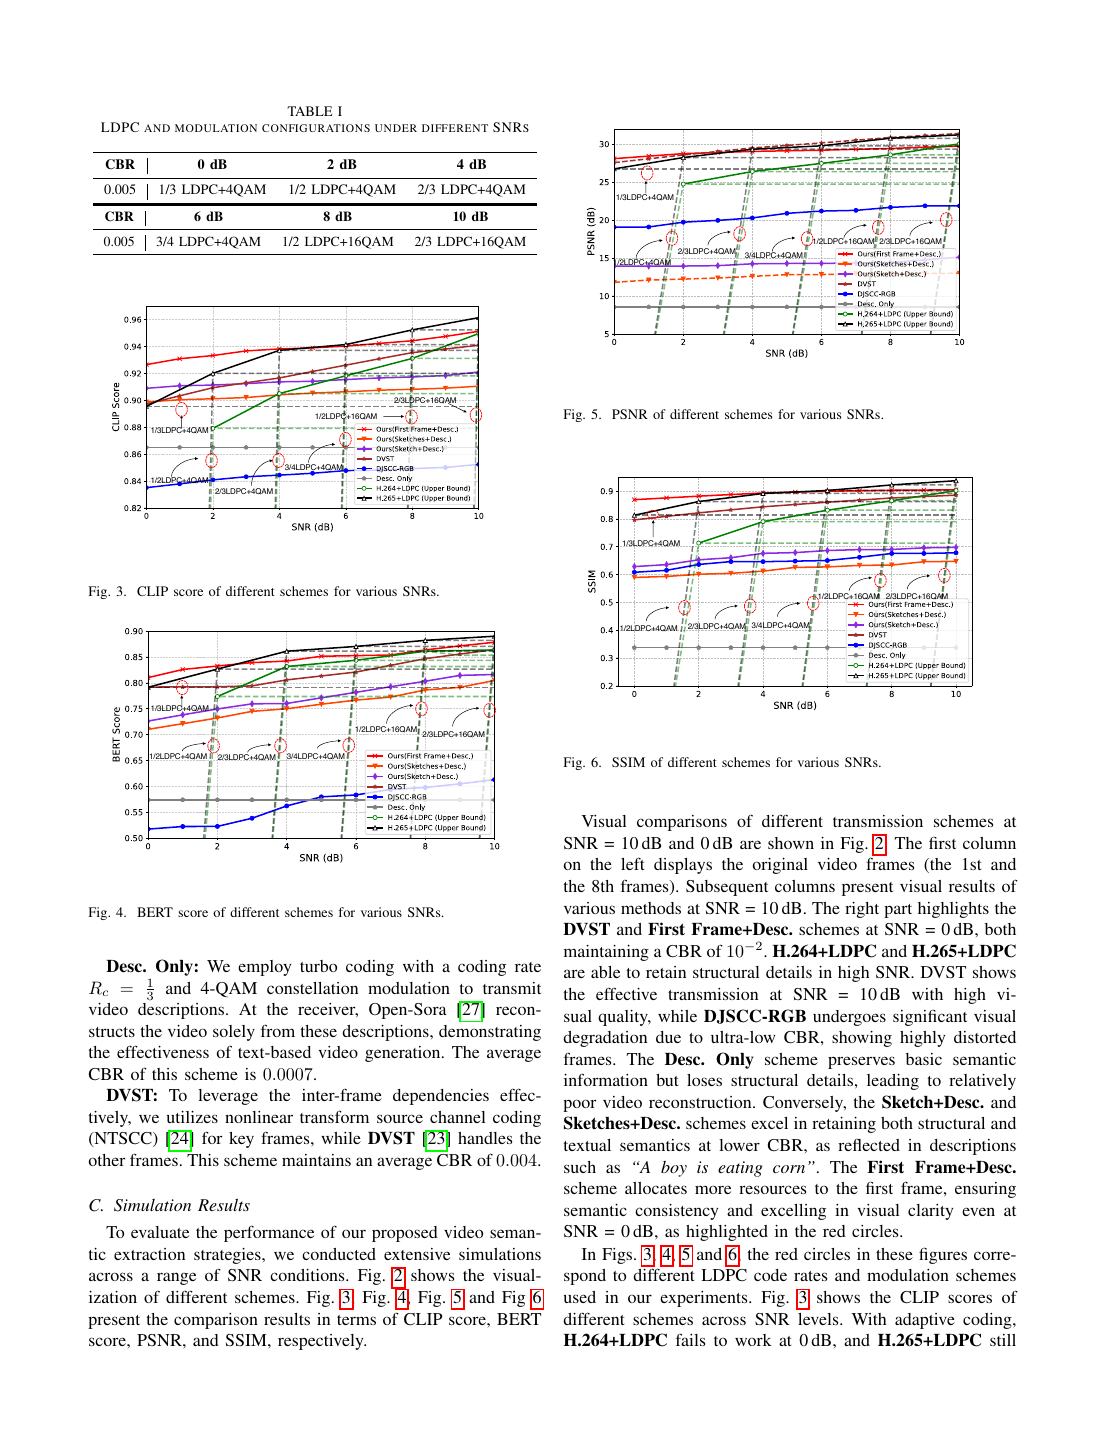
实验小节中明确出现的比较对象包括H.264、H.265、JSCC、LDPC、QAM、BERT、CLIP;指标包括PSNR、SSIM;信道/链路条件包括AWGN;正文可定位的代表性工作点有SNR = 10 dB、SNR = 0 dB、CBR of 10、CBR of 0.0031、CBR = 0.005、CBR of 0.004。 PDF p.5
仿真结果表明,在超低的信道带宽比(CBR)下,该方案能够有效地捕捉视频的语义信息,在不同的信噪比下重建出符合人类感知的视频,虽然DJSCCRGB可能会出现模糊,但它比Sketch+Desc.和Sketches+Desc.方案获得了更高的像素相似度。 PDF p.1PDF p.6
架构/方法图|来源:《Generative Video Semantic Communication via Multimodal Semantic Fusion With Large Model》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Generative Video Semantic Communication via Multimodal Semantic Fusion With Large Model》,原 PDF p.5,Fig. 5 PSNR of different schemes for various SNRs 核对论文
相关但非核心2025语义感知资源分配与网络优化
Heterogeneous Semantic and Bit Communications in UAV Network: A Semi-NOMA Design
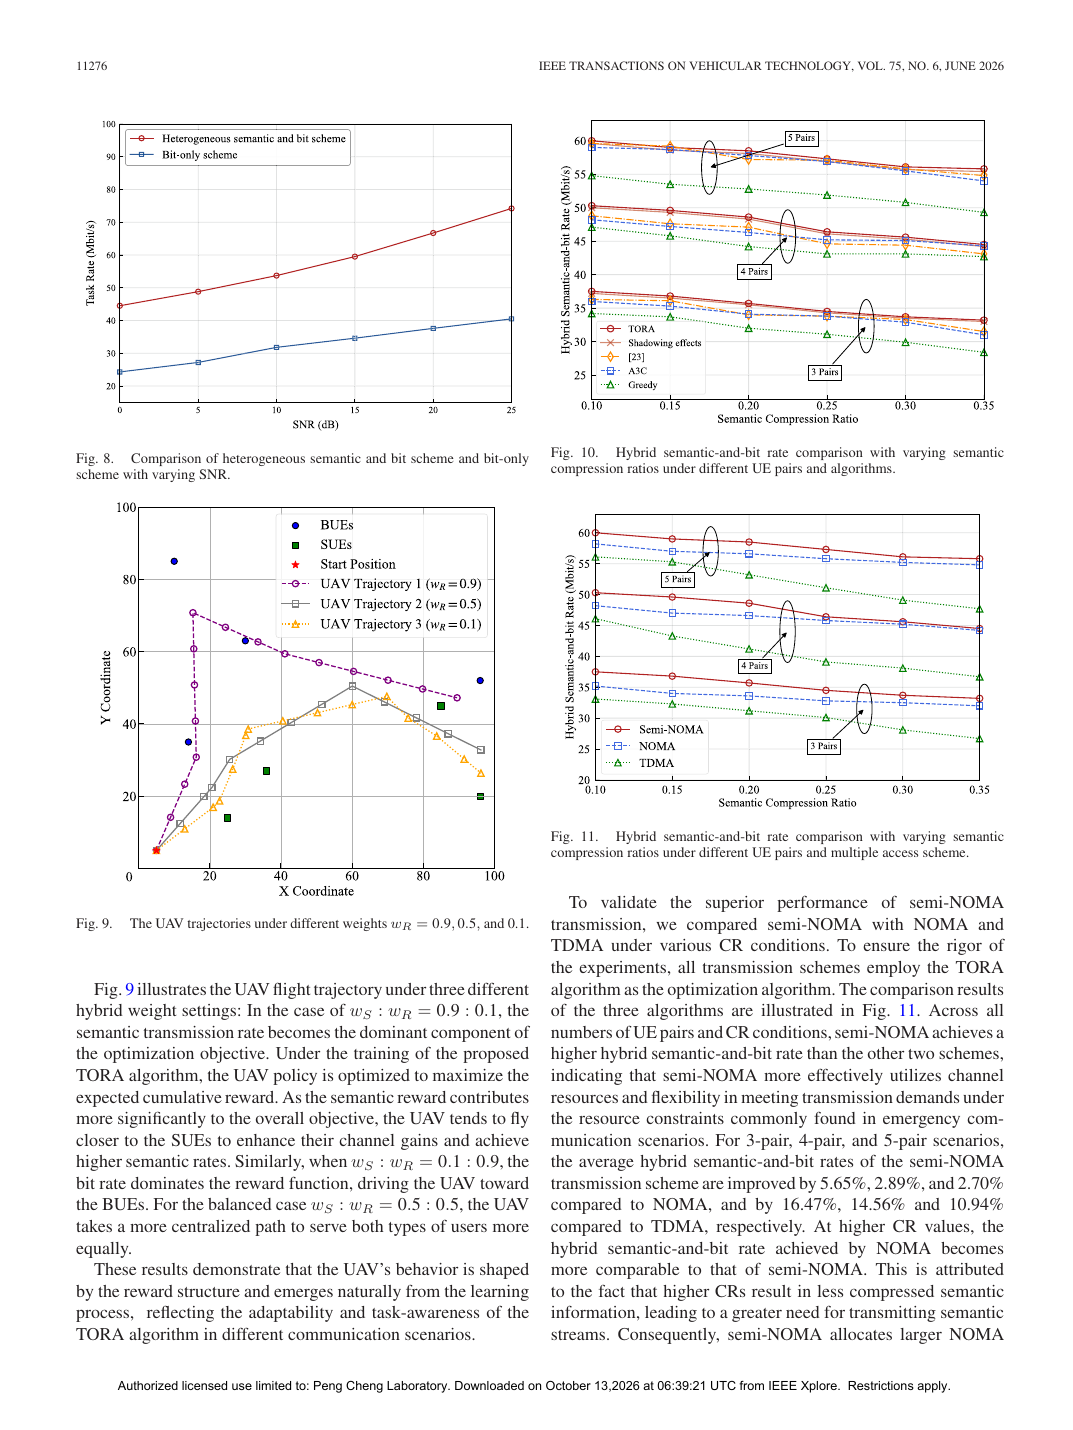
数据集为CIFAR-10;实验小节中明确出现的比较对象包括DeepJSCC、JSCC、CLIP、PPO;指标包括accuracy、latency、PER。 PDF p.9
仿真结果表明:1)与传统的TORA算法相比,该算法在不同压缩率下均能获得更高的混合语义比特率,且收敛速度快;以及2)在各种CR下,半NOMA传输方案实现了比NOMA和时分多址(TDMA)传输方案更优的性能,即使当BUE-SUE用户对的数目增加时,该算法也能获得较高的混合语义-比特率,这表明TORA算法在轨迹优化和资源分配上优势显著。 PDF p.1PDF p.11
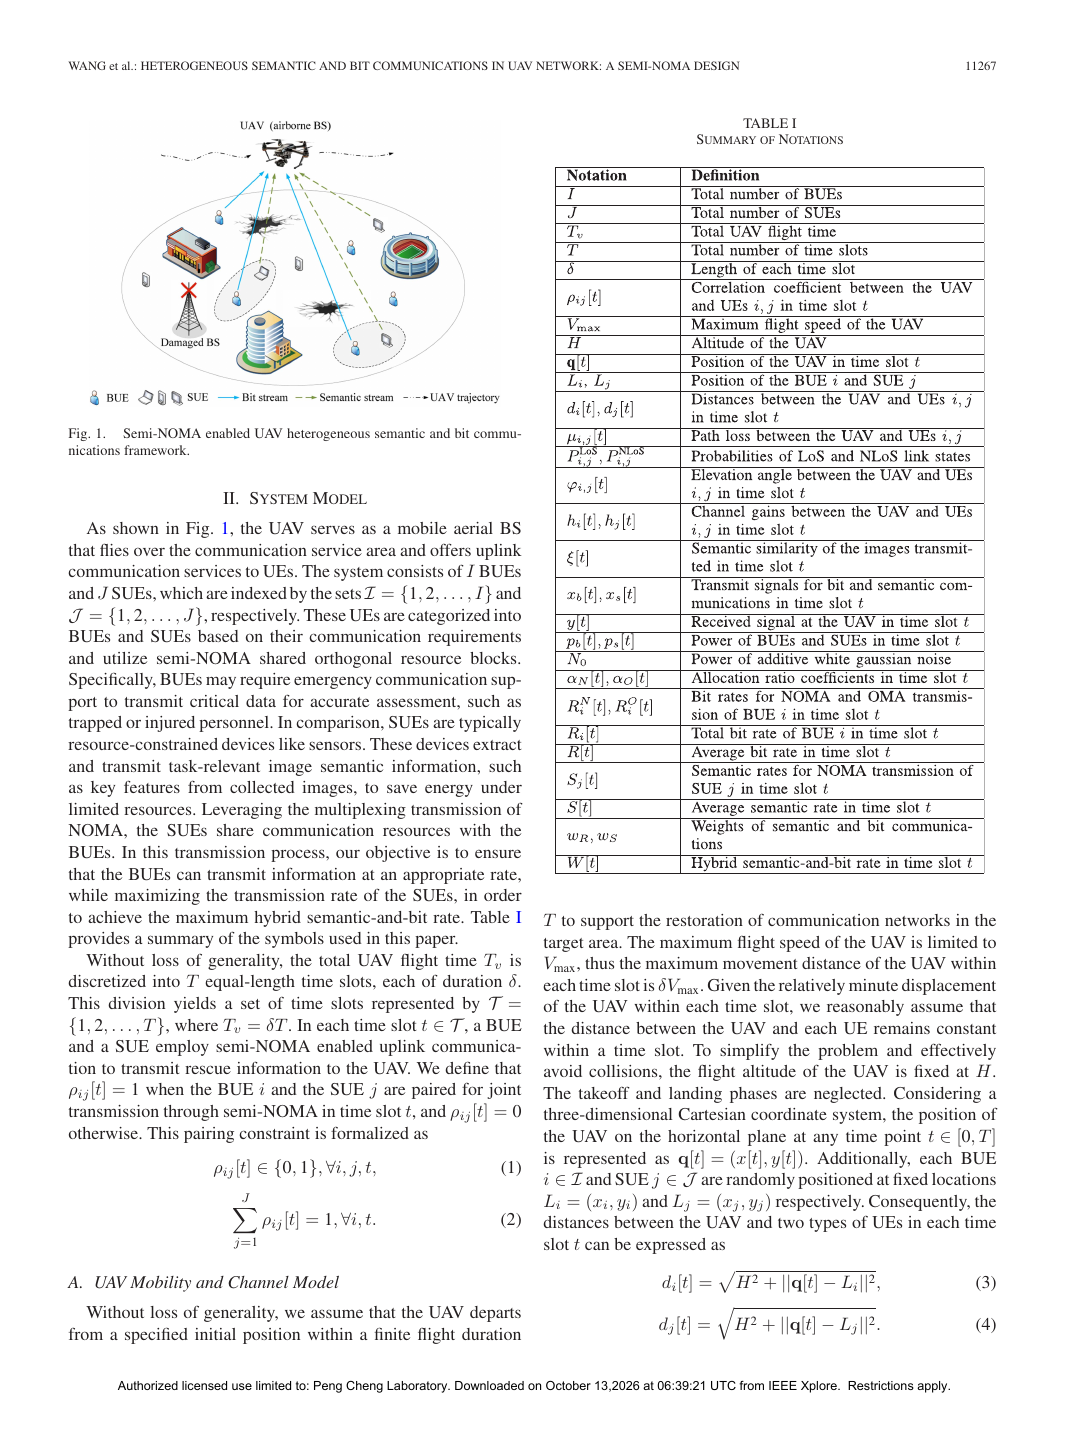
架构/方法图|来源:《Heterogeneous Semantic and Bit Communications in UAV Network: A Semi-NOMA Design》,原 PDF p.3,Fig. 1 Semi-NOMA enabled UAV heterogeneous semantic and bit communications framework 核对论文关键实验结果图/表|来源:《Heterogeneous Semantic and Bit Communications in UAV Network: A Semi-NOMA Design》,原 PDF p.12,Fig. 8 Comparison of heterogeneous semantic and bit scheme and bit-only scheme with varying SNR 核对论文
相关但非核心2025通用语义通信系统
Integrated Sensing, Computing and Semantic Communication for Vehicular Networks
现有进展:本文介绍了一种新的框架内集成的传感,计算和语义通信(ISCSC)的车辆网络包括路边单元(RSU)和多个自主车辆。 PDF p.1
仍然存在的问题:但是,若要将本材料用于任何其他目的,必须通过向pubs-permission@ieee.org发送请求,从IEEE获得许可。 PDF p.1
为什么已有方法解决不了:只优化合法接收端的重建或任务 loss,并不会自动消除 latent 泄露、窃听或操纵风险;缺少的是把攻击者与保护目标放进同一系统模型。 PDF p.1
为什么这个问题重要:语义质量必须在真实的带宽、功率和时延预算下成立,否则模型收益不能转化为通信系统收益。 PDF p.1
本文提出什么:本文介绍了一种新的框架内集成的传感,计算和语义通信(ISCSC)的车辆网络包括路边单元(RSU)和多个自主车辆。 PDF p.1
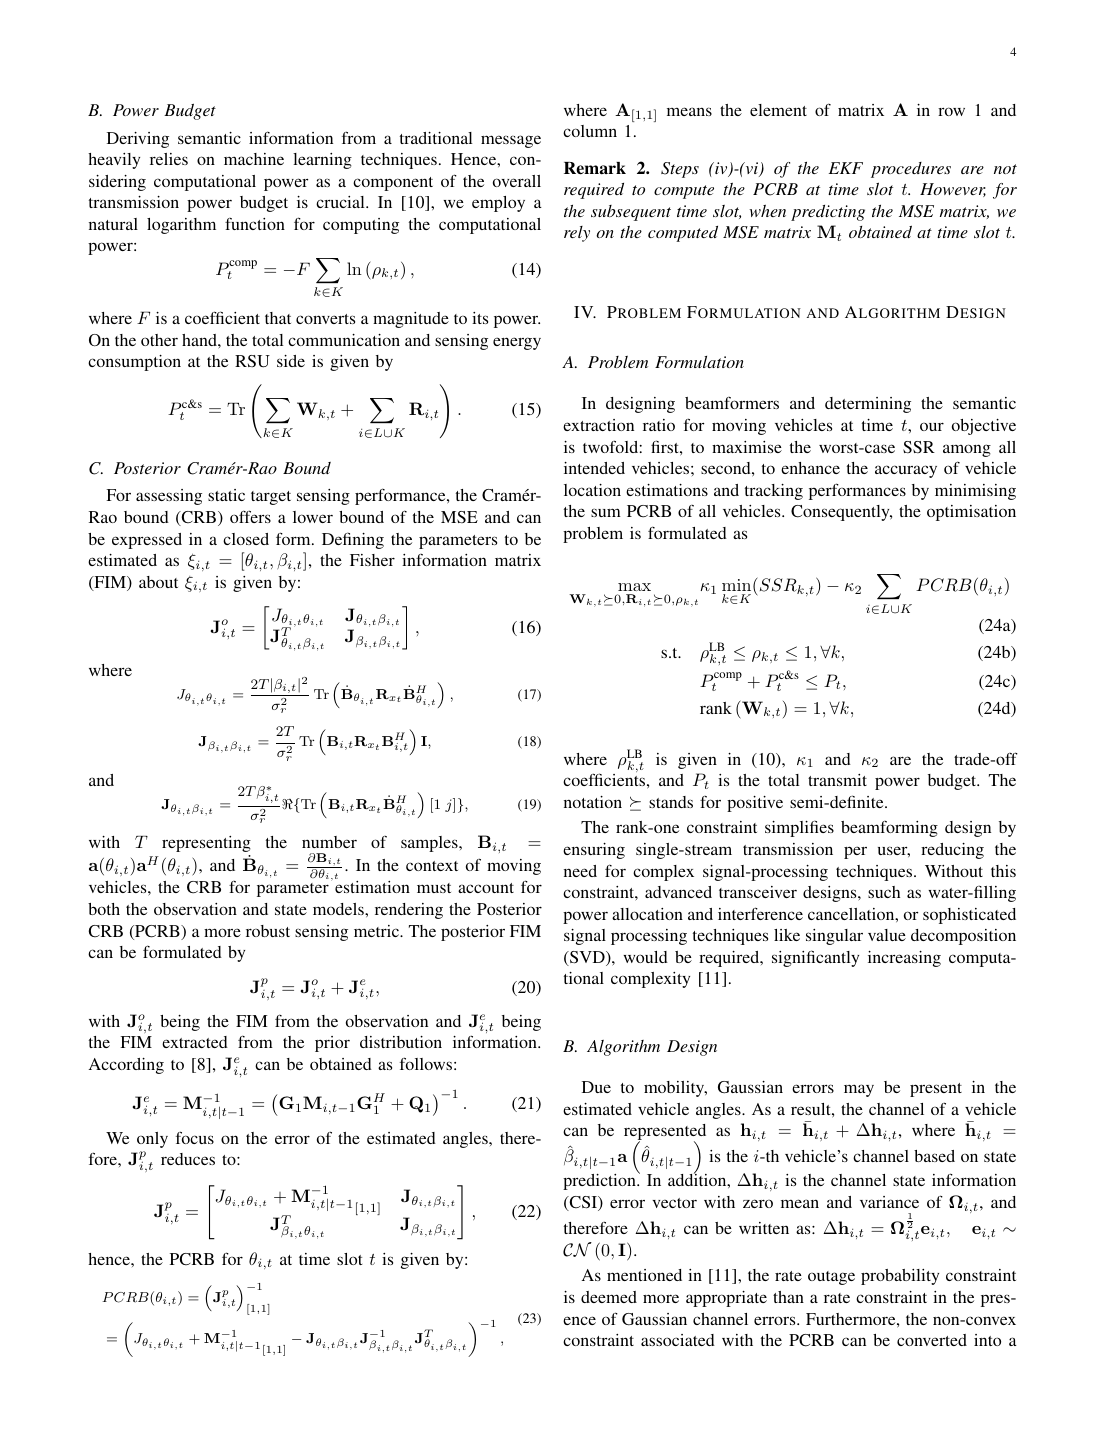
方案为何可能有效:我们制定了一个联合优化问题,平衡最大化的概率约束的语义保密率为每辆车,同时最小化的总和后Cramér-Rao界(PCRB),受RSU的计算能力。 PDF p.1
作者希望证明什么:该框架采用了安全通信设计,以确保发送给特定车辆的消息不会被截获。 PDF p.1
方法与端到端信息流
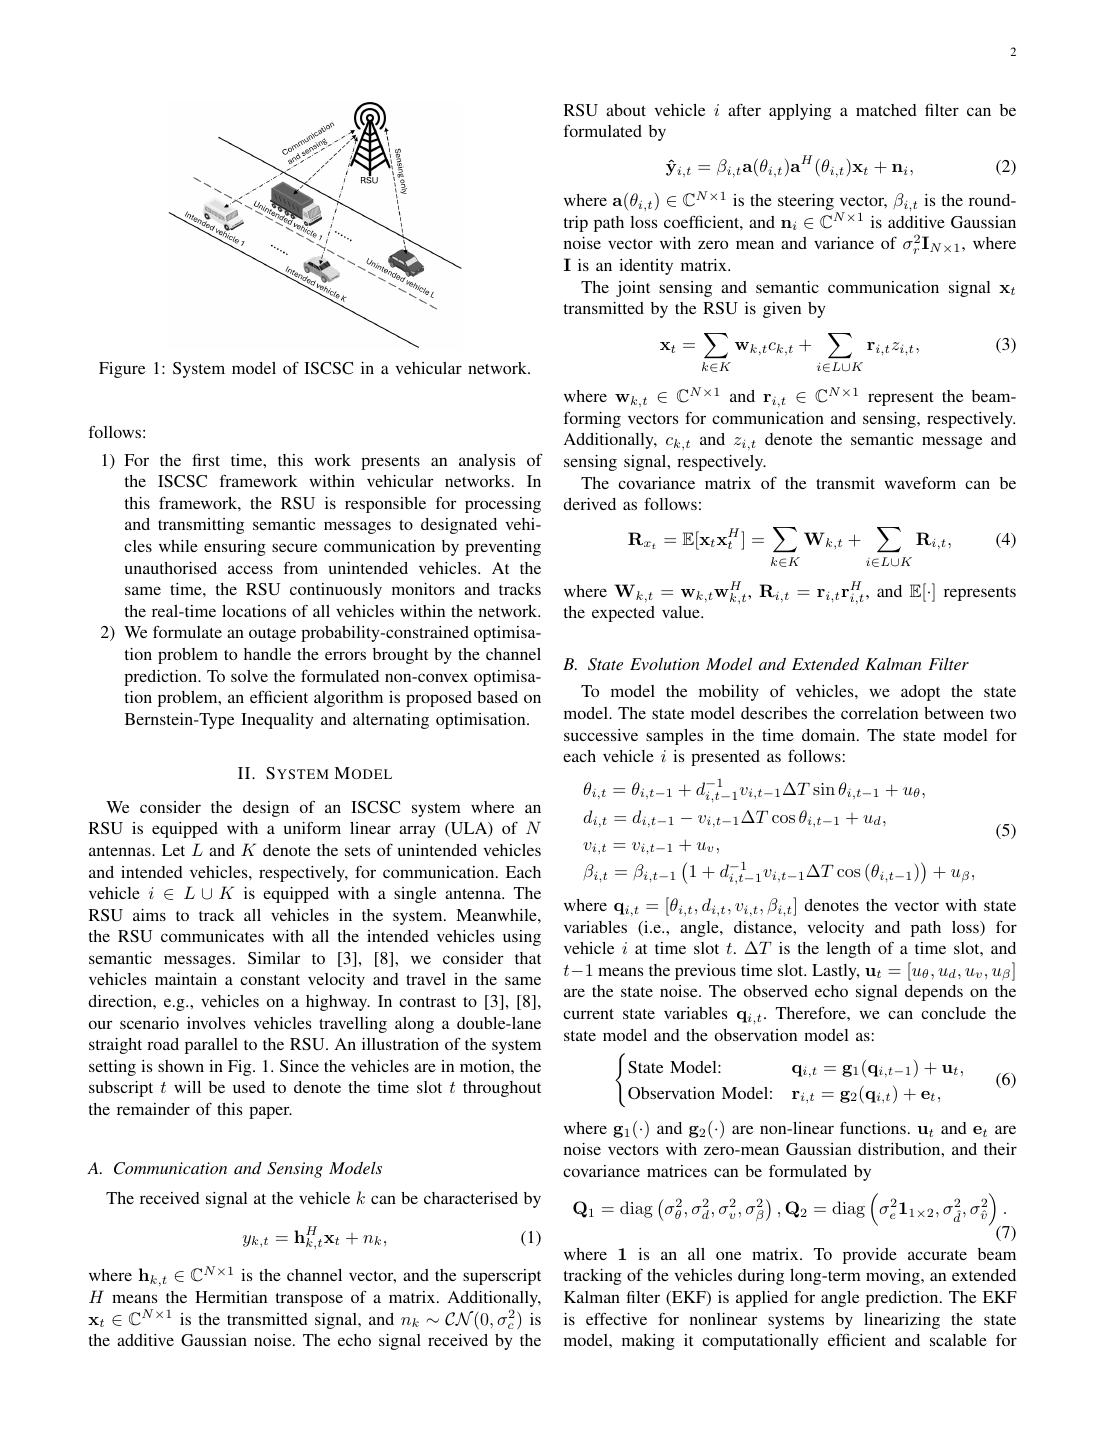
本文提出了一种新的集成感知、计算和语义通信的车载网络框架,该框架由一个路侧单元(RSU)和多个自主车辆组成,我们提出了一个联合优化问题,该问题在最大化每个车辆的概率约束语义保密率的同时,最小化后验Cramér-Rao界(PCRB)的和,考虑一个RSU配置N个天线的均匀线阵(ULA)的ISCSC系统的设计。 PDF p.1PDF p.2
架构/方法图|来源:《Integrated Sensing, Computing and Semantic Communication for Vehicular Networks》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Integrated Sensing, Computing and Semantic Communication for Vehicular Networks》,原 PDF p.4,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2025语义感知资源分配与网络优化
Joint Knowledge and Power Management for Secure Semantic Communication Networks
现有进展:近年来,语义通信(SemCom)在节约资源和信息交换方面显示出了巨大的优势。 PDF p.1
仍然存在的问题:然而,其独特的背景知识在保证语义推理和恢复准确性的同时,也带来了语义信息安全方面的问题。 PDF p.1
为什么已有方法解决不了:只优化合法接收端的重建或任务 loss,并不会自动消除 latent 泄露、窃听或操纵风险;缺少的是把攻击者与保护目标放进同一系统模型。 PDF p.1
为什么这个问题重要:功率、带宽、算力和时延是共享资源;若调度器不知道语义效用,它可能增加吞吐量却没有改善任何用户真正关心的任务。 PDF p.1
本文提出什么:为此,本文重点讨论了安全SemCom网络中的功率分配、知识库缓存(KBC)和设备到设备(D2 D)用户配对(DUP)三个核心问题。 PDF p.1
方案为何可能有效:其次,在安全的SemCom相关延迟和可靠性约束下,建立了SST最大化问题的数学模型。 PDF p.1
作者希望证明什么:仿真结果表明,与不同的基准测试相比,本文提出的方案可以使SST性能提高近一倍,而排队延迟性能降低不到一半。 PDF p.1
方法与端到端信息流
为此,本文重点关注在安全SemCom网络中联合解决功率分配、知识库缓存(KBC)和设备到设备(D2D)用户配对(DUP)这三个核心问题。SST最大化问题被公式化为服从安全SemCom,理论分析和数值结果都验证了本文提出的解决方案在语义方面的性能优越性保密吞吐量、排队延迟和语义知识满意度。 PDF p.1PDF p.2
输入输入是语义感知资源分配与网络优化所需的用户、任务、信道和资源状态。
发送端发送端采用 Joint Knowledge and Power Management for Secure Semantic Communication Networks:为此,本文重点关注在安全SemCom网络中联合解决功率分配、知识库缓存(KBC)和设备到设备(D2D)用户配对(DUP)这三个核心问题。SST最大化问题被公式化为服从安全SemCom,理论分析和数值结果都验证了本文提出的解决方案在语义方面的性能优越性保密吞吐量、排队延迟和语义知识满意度。
实际发送实际发送对象是语义 feature 或未完整规定 bit 映射的 latent。
信道信道作用方式按“类别 0:信道作用点不足,或由外部传统链路抽象承担”解释。
接收端接收端从论文假设已经恢复的语义特征开始,再执行语义解码、任务推理或生成。
输出最终输出为资源/部署策略及其语义效用。
它在通信系统中的位置:把窃听、攻击或隐私泄露纳入语义链路,同时考察合法端质量与攻击端获得的信息。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:语义 feature/latent;量化到 bitstream 的接口未完整报告
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“语义 feature/latent;量化到 bitstream 的接口未完整报告”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:Joint Knowledge and Power Management for Secure Semantic Communication Networks 的主传输单位属于“语义 feature/latent;量化到 bitstream 的接口未完整报告”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
论文未同时报告输入尺寸、encoder 输出尺寸、量化精度/码本大小和帧级开销,因此不能从全文唯一重建总 bit 数。页面保留论文实际使用的 CBR、bpp、token 数或信道使用次数;缺失项不作臆测。 PDF p.2PDF p.3
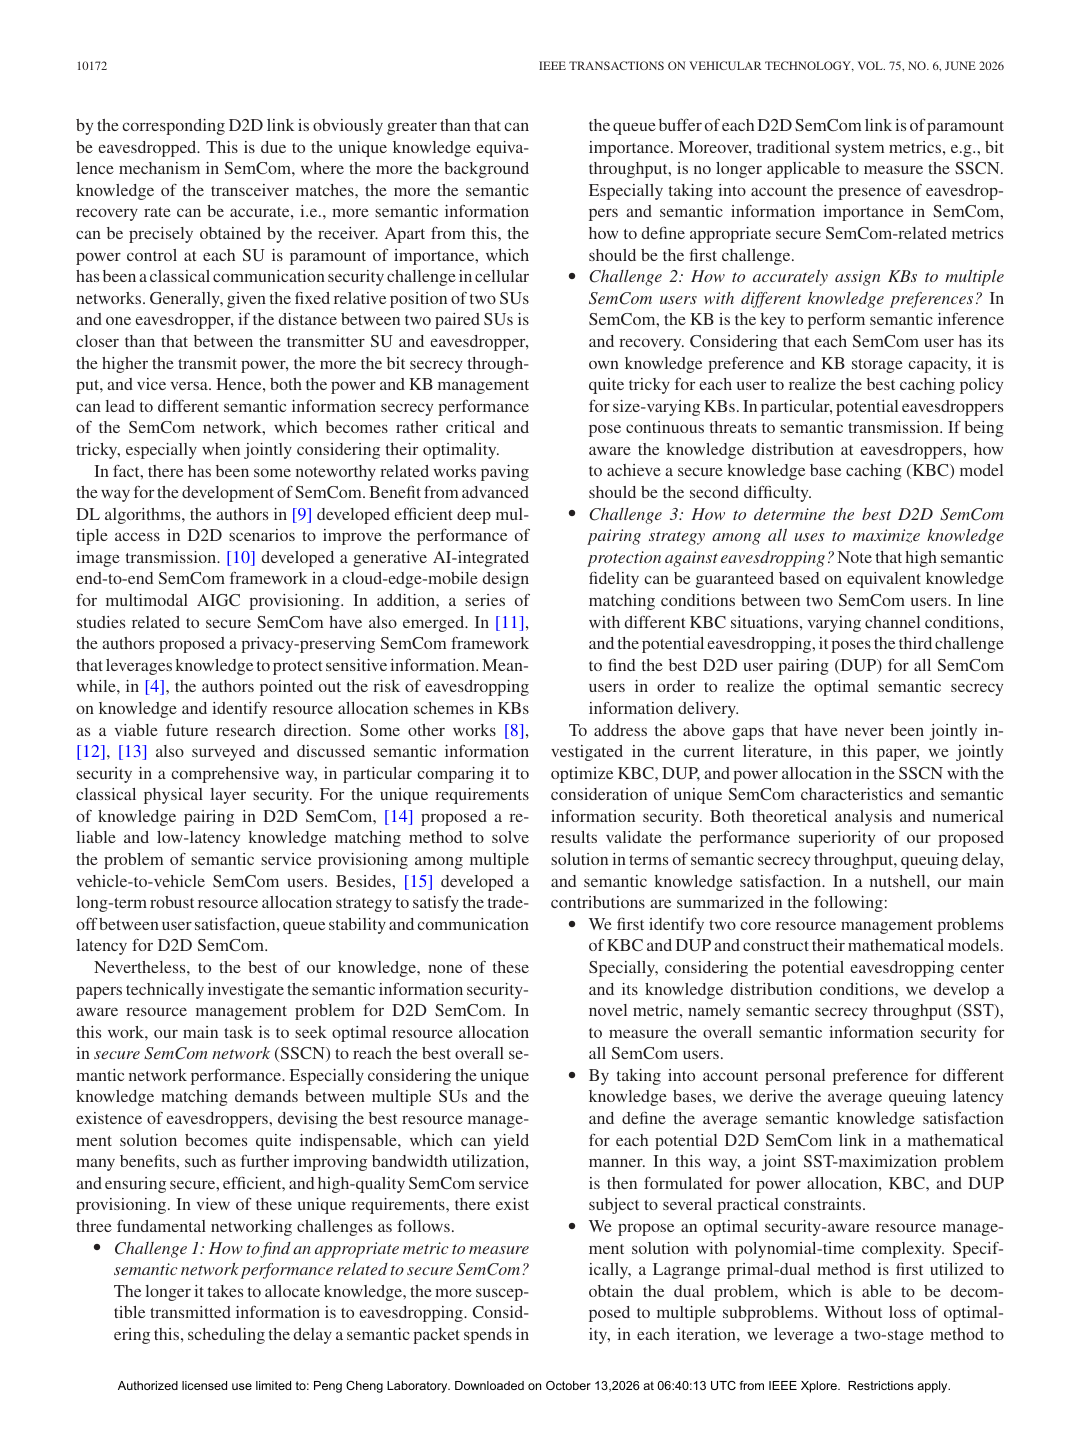
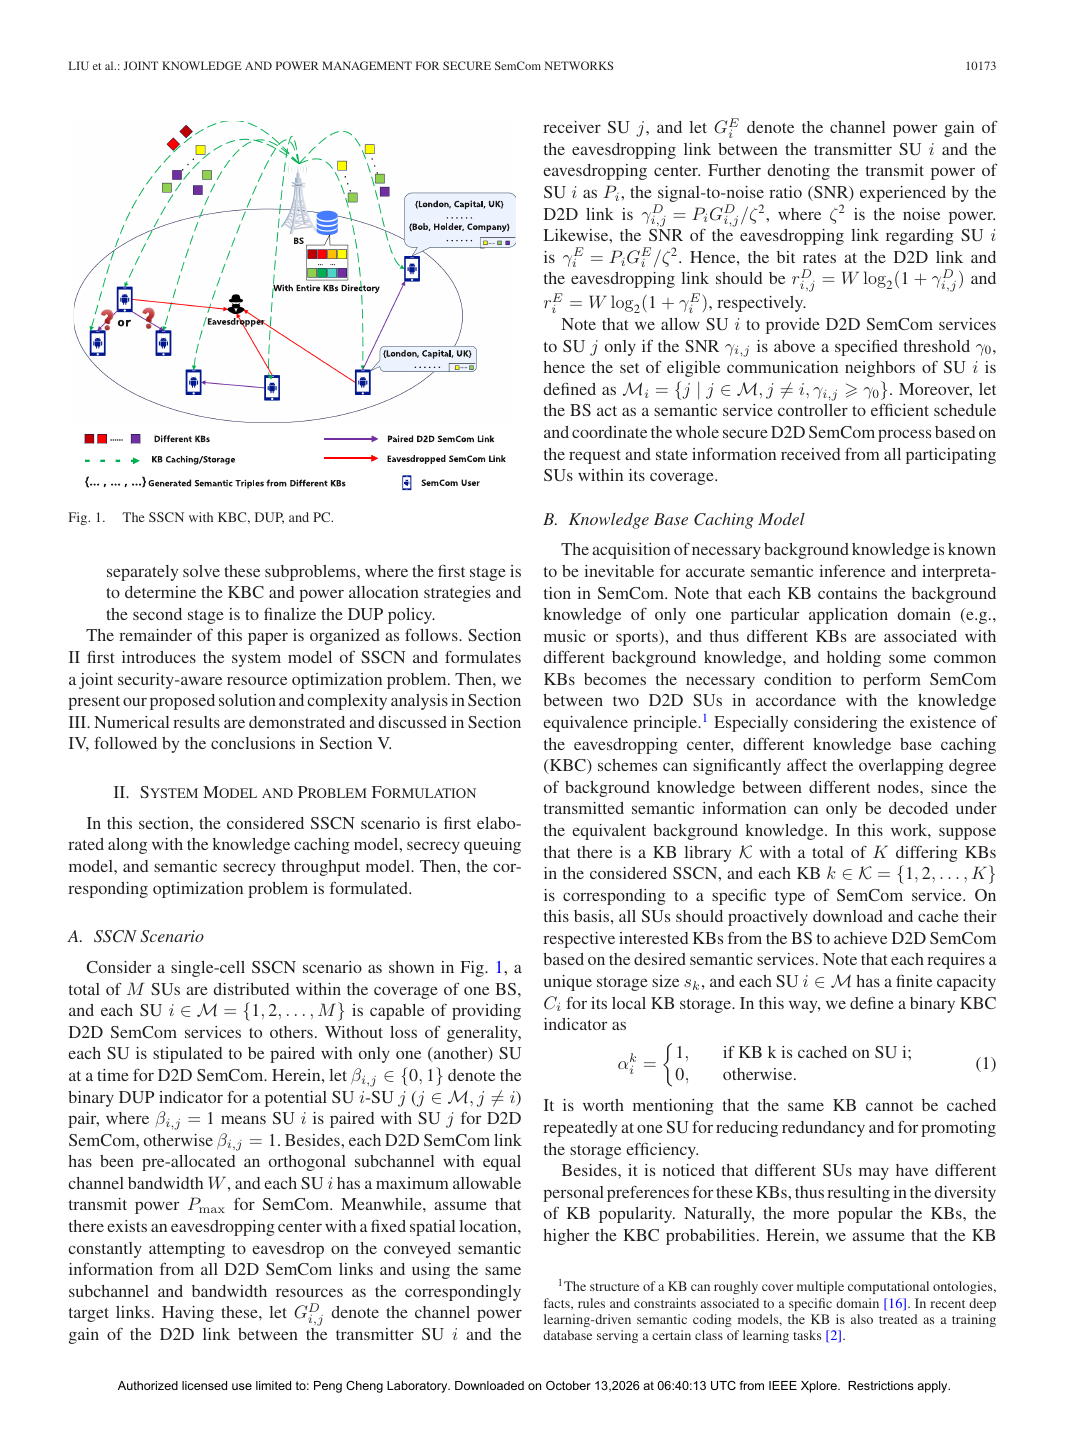
架构/方法图|来源:《Joint Knowledge and Power Management for Secure Semantic Communication Networks》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Joint Knowledge and Power Management for Secure Semantic Communication Networks》,原 PDF p.3,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2025通用语义通信系统
Learning to Decode Double Polar Codes for Joint Source-Channel Coding
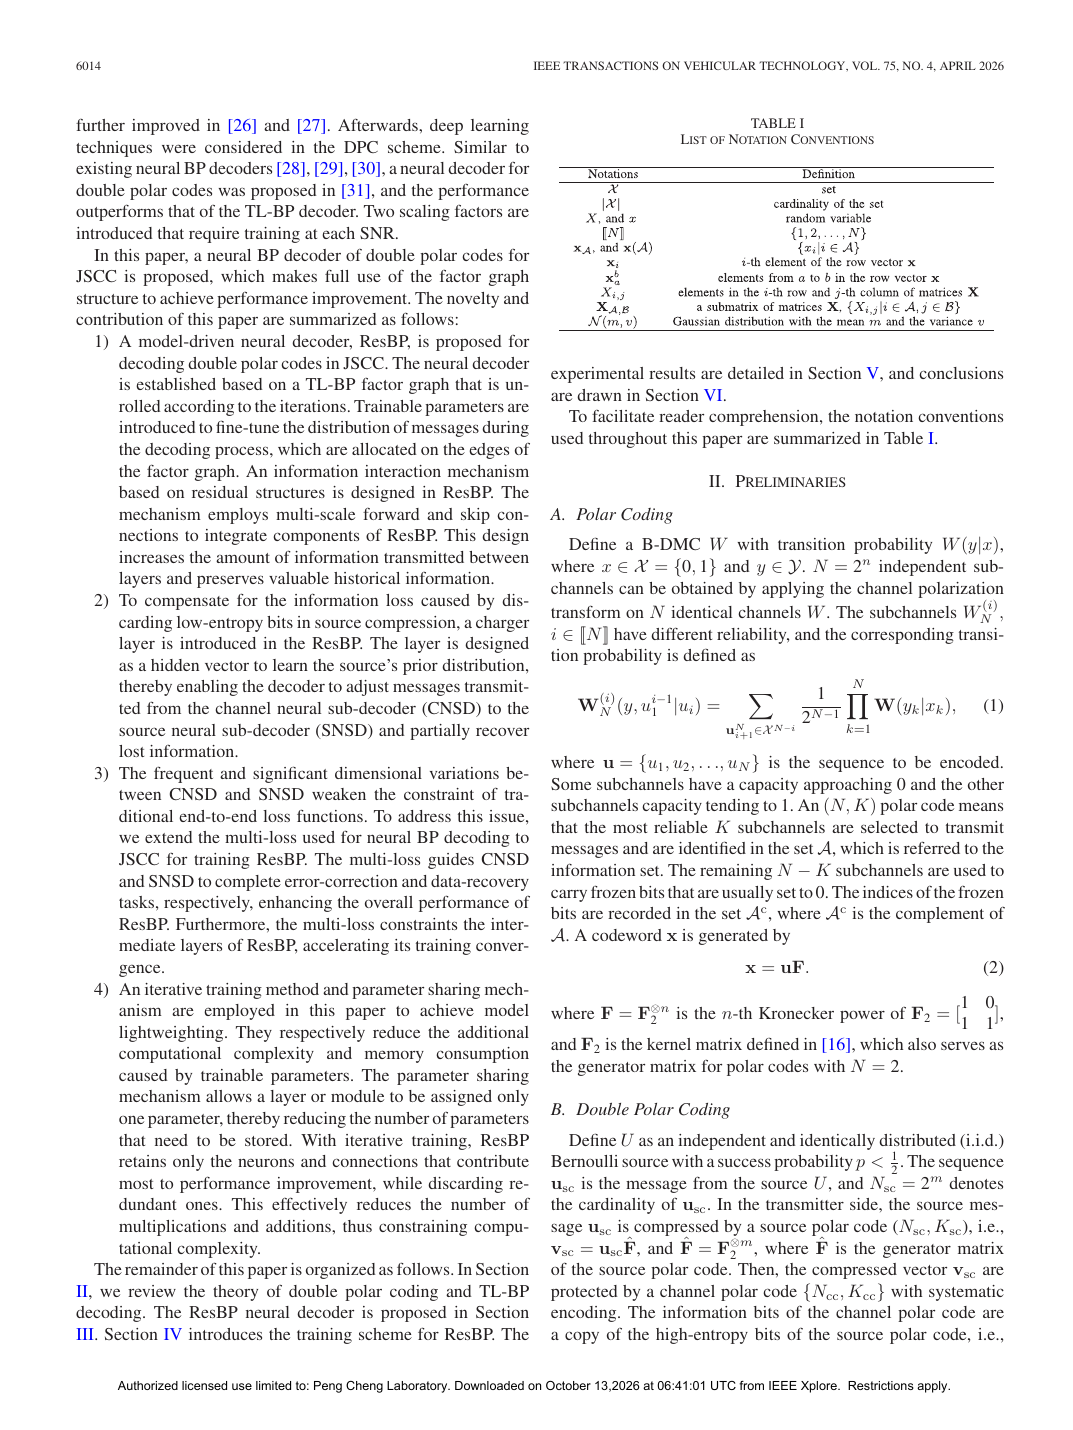
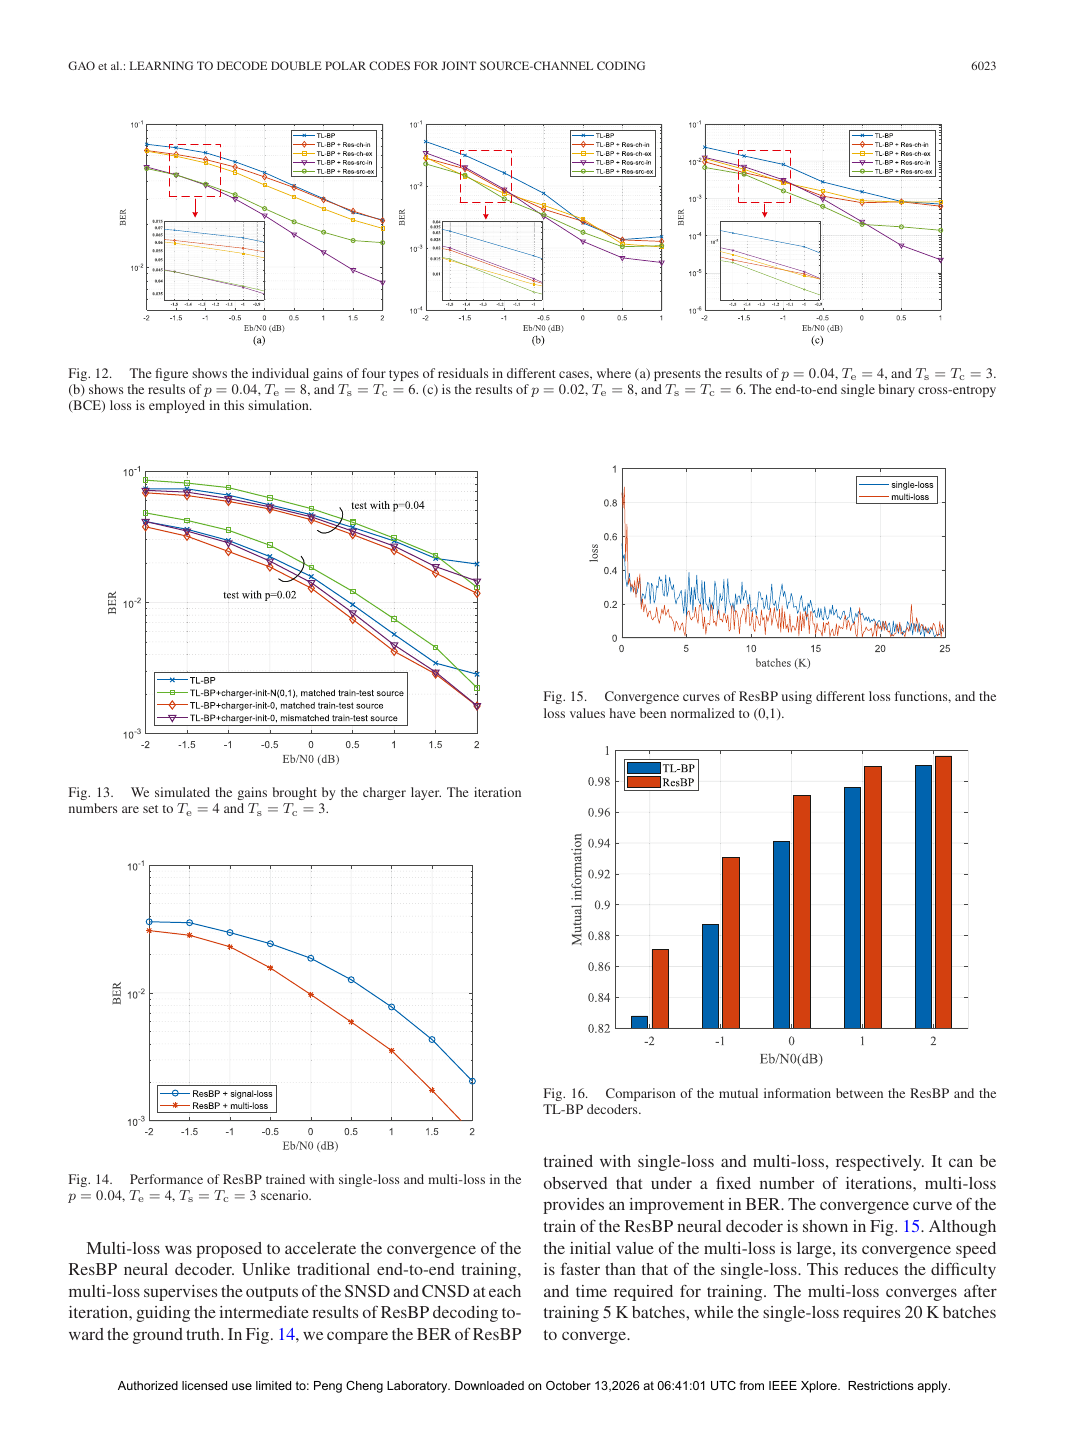
架构/方法图|来源:《Learning to Decode Double Polar Codes for Joint Source-Channel Coding》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Learning to Decode Double Polar Codes for Joint Source-Channel Coding》,原 PDF p.11,Fig. 16 Comparison of the mutual information between the ResBP and the TL-BP decoders 核对论文
核心纳入2025通用语义通信系统
Learning-Based Task-Centric Multi-User Semantic Communication Solution for Vehicle Networks
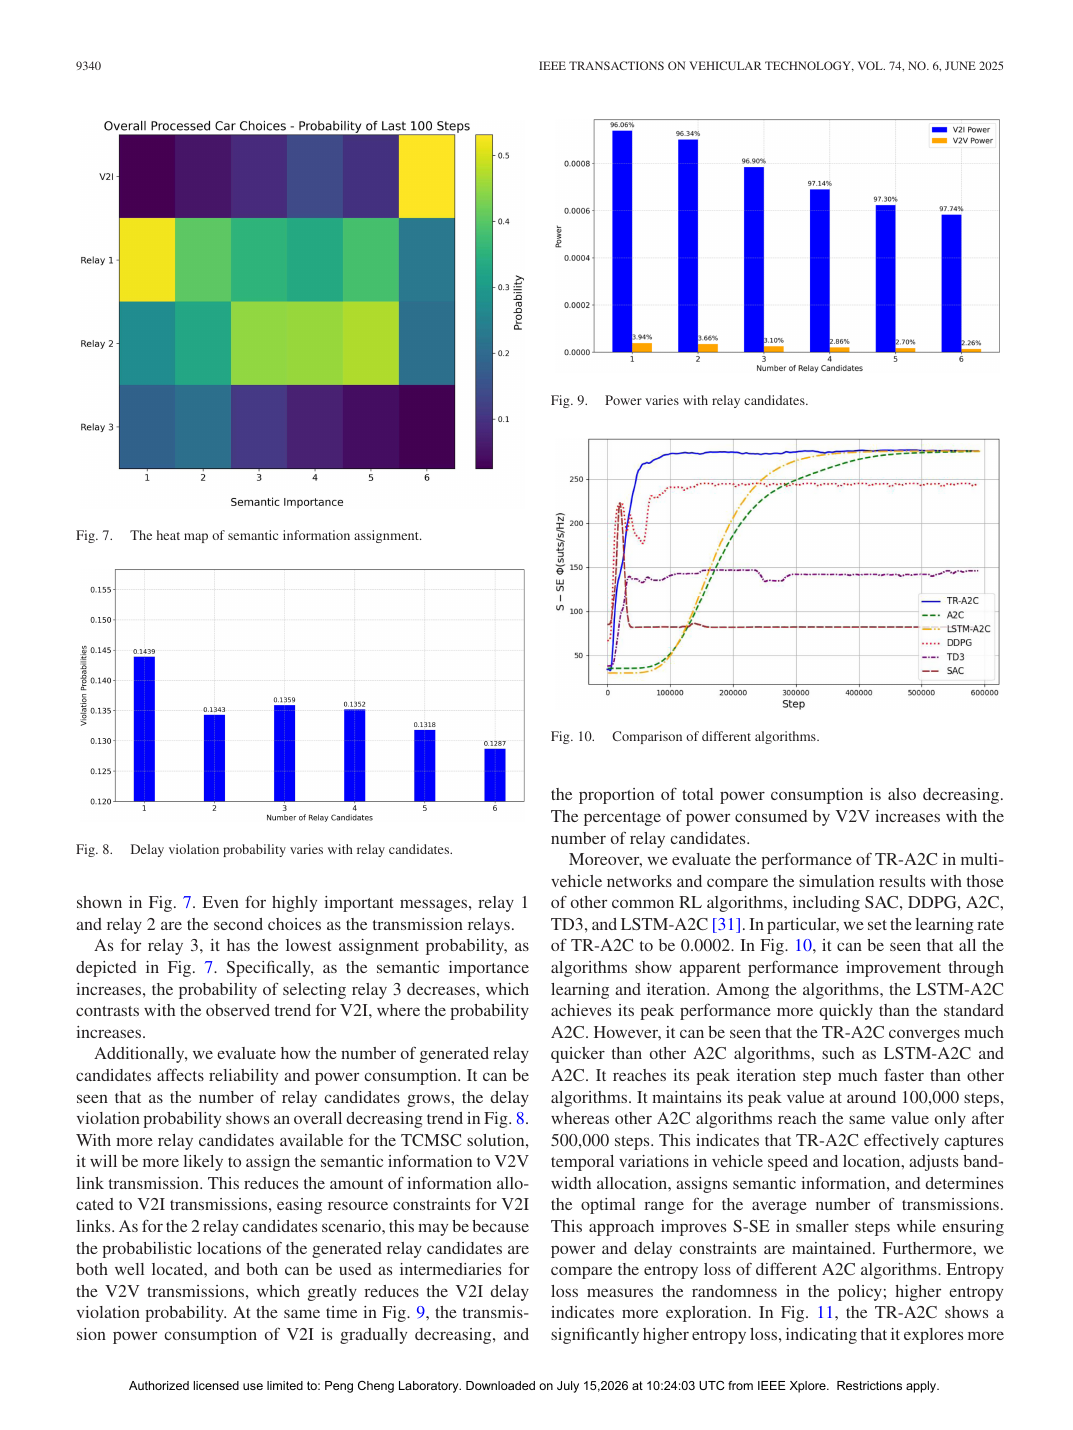
架构/方法图|来源:《Learning-Based Task-Centric Multi-User Semantic Communication Solution for Vehicle Networks》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Learning-Based Task-Centric Multi-User Semantic Communication Solution for Vehicle Networks》,原 PDF p.13,Fig. 10 Comparison of different algorithms 核对论文
核心纳入2025图像传输、压缩或生成
Lightweight Digital Semantic Communication Based on DeepReceiver
现有进展:语义通信(SemCom)由于其在不影响通信效率的前提下最大限度地减少数据传输量的潜力而引起了人们的广泛关注。 PDF p.1
仍然存在的问题:然而,现有的研究主要集中在模拟SemCom上,将从源数据中提取的语义特征直接映射到模拟符号上,限制了SemCom在现实场景中的适用性。 PDF p.1
为什么已有方法解决不了:连续 latent 或独立设计的传统链路没有回答语义特征怎样量化、映射为有限符号,以及 bit/index 出错后为何不会跳到完全不同的语义。仅改进信源网络无法补上这一接口。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
本文提出什么:在本文中,我们提出了一种新的数字SemCom,它具有轻量级语义矢量量化自动编码器/解码器(L-VQAE),以适应数字通信协议。 PDF p.1
方案为何可能有效:在本文中,我们提出了一种新的数字SemCom,它具有轻量级语义矢量量化自动编码器/解码器(L-VQAE),以适应数字通信协议。 PDF p.1
作者希望证明什么:实验数据显示,不同算法的峰值信噪比(PSNR)性能相比于基线有显著提高。 PDF p.1
方法与端到端信息流
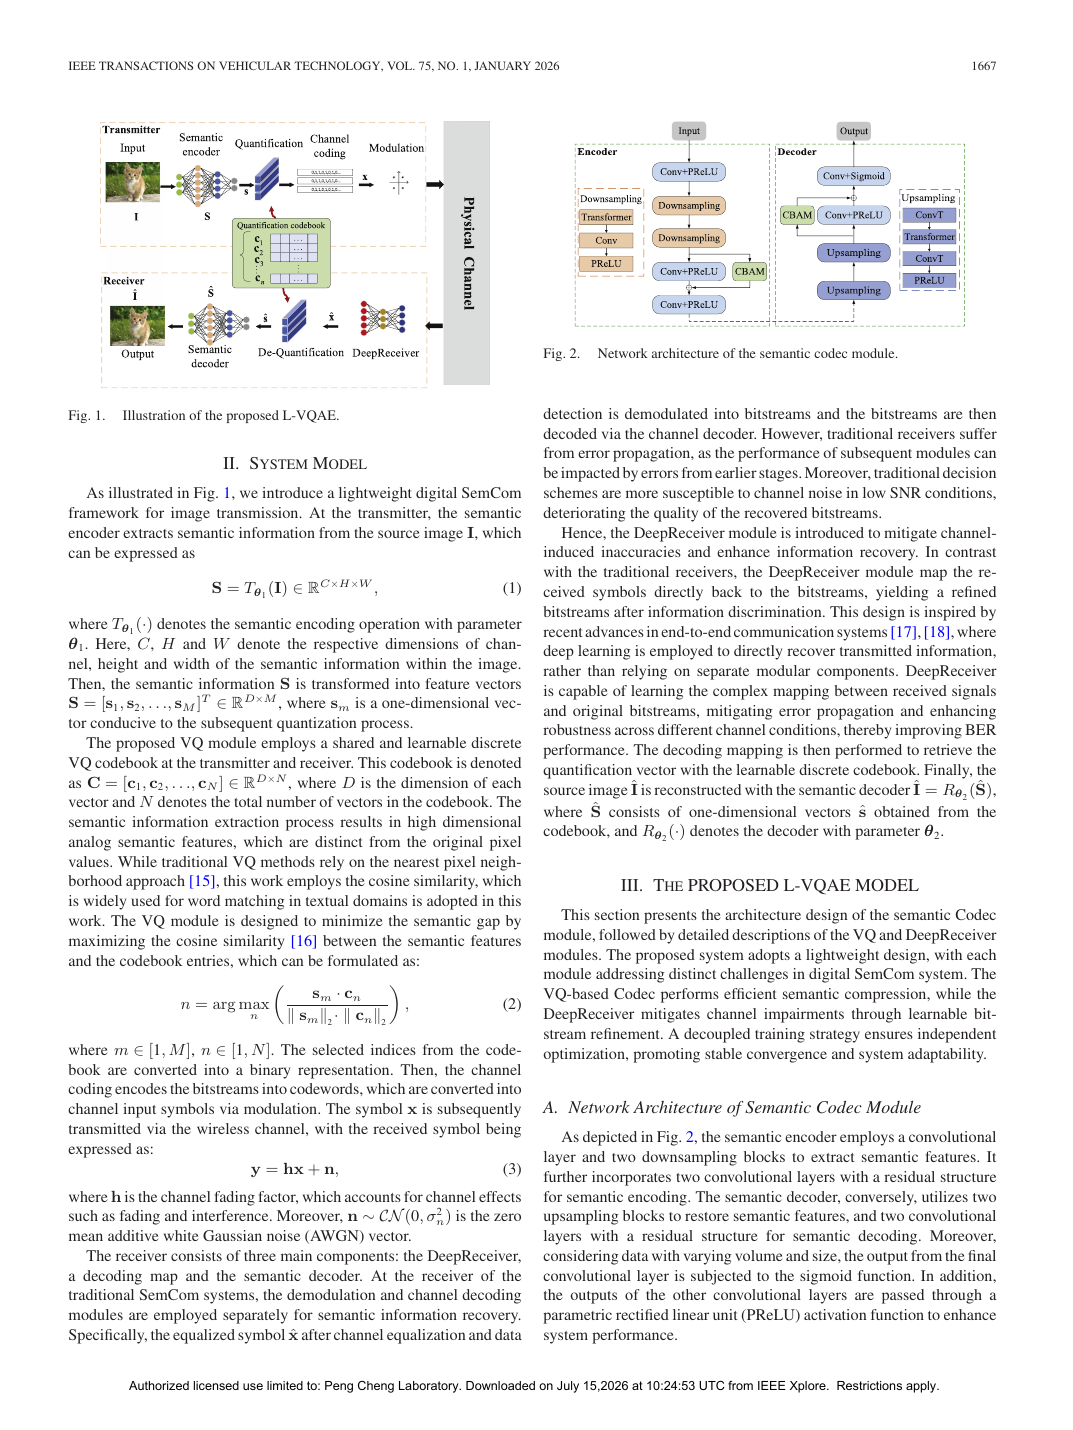
在本文中,我们提出了一种新的数字SemCom系统,它采用轻量级语义矢量量化自动编码/解码器(L-VQAE),以适应数字通信协议的要求,系统采用轻量级设计,每个模块都能解决数字SemCom系统中的不同问题。 PDF p.1PDF p.2
输入输入是图像传输、压缩或生成所需的图像及其视觉/任务语义。
发送端发送端采用 Lightweight Digital Semantic Communication Based on DeepReceiver:在本文中,我们提出了一种新的数字SemCom系统,它采用轻量级语义矢量量化自动编码/解码器(L-VQAE),以适应数字通信协议的要求,系统采用轻量级设计,每个模块都能解决数字SemCom系统中的不同问题。
在本文中,我们提出了一种新的数字SemCom,它采用轻量级的语义矢量量化自动编码器/解码器(L-VQAE),以适应数字通信协议。 表示判定:Lightweight Digital Semantic Communication Based on DeepReceiver 的主传输单位属于“显式数字语义表示:bit、离散 token 或码本 index”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.1PDF p.2
VQ和DeepReceiver模块(5)的网络体系结构,其中I表示头的数量,fi 3 ×3(·)表示3 × 3卷积层,dk表示K的维数,其用于缩放点积的结果以避免softmax函数的梯度消失问题。 PDF p.3
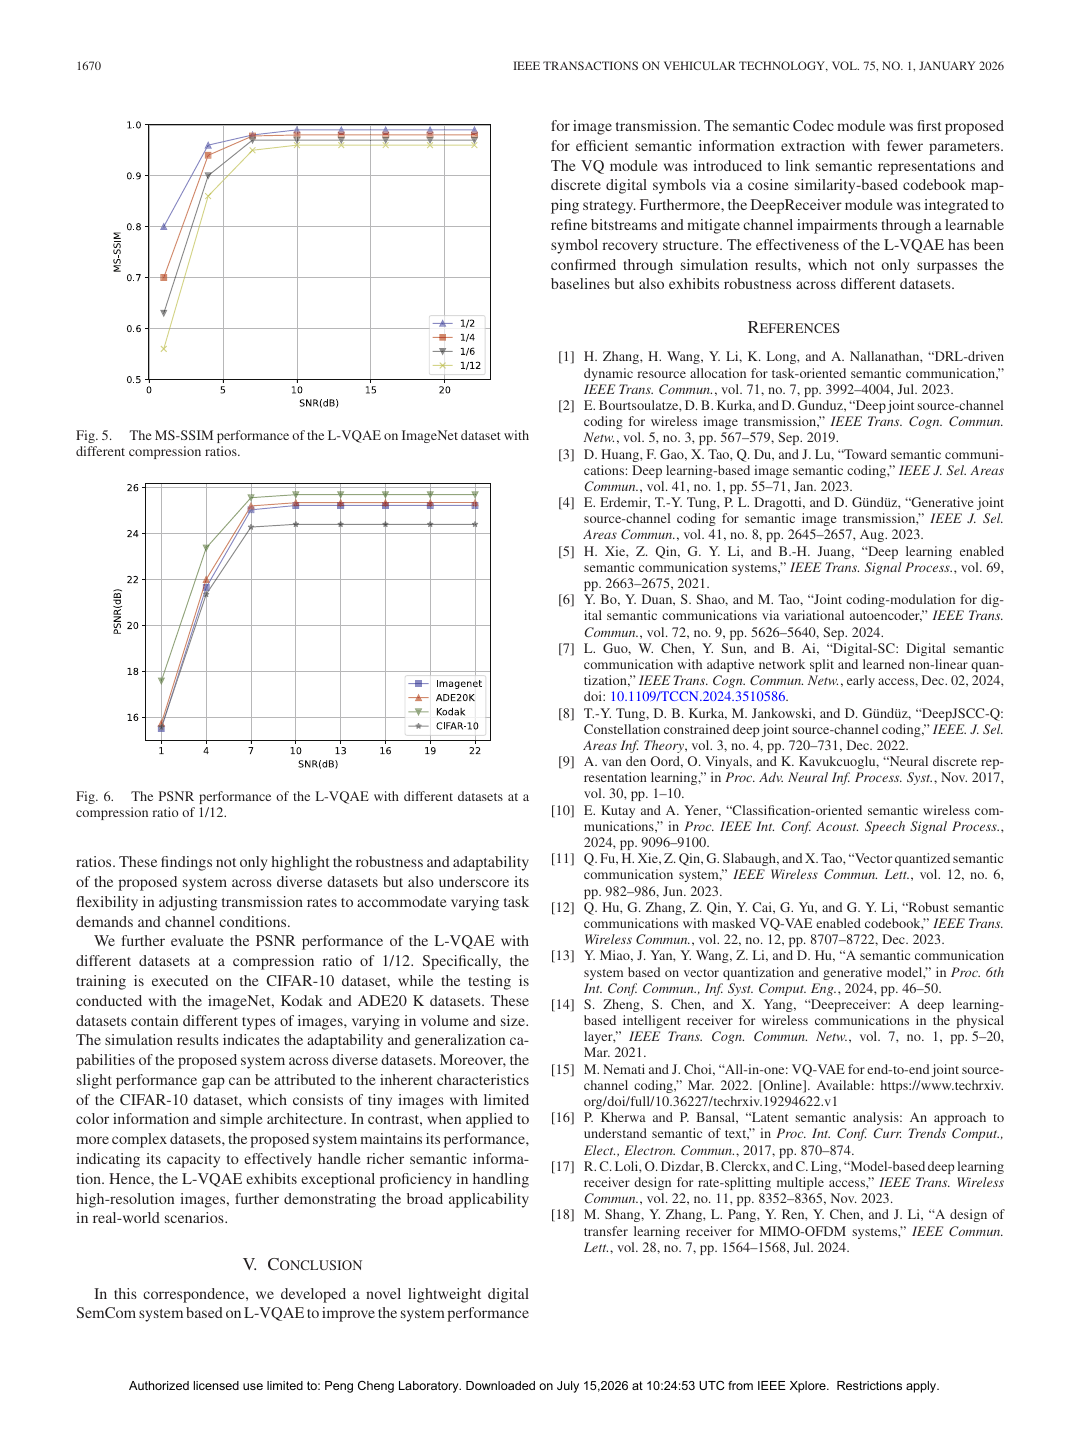
数据集为CIFAR-10、ImageNet;实验小节中明确出现的比较对象包括BPG、DeepSC、LDPC;指标包括PSNR、SSIM、MS-SSIM、MSE、accuracy、mAP、latency、BER;信道/链路条件包括AWGN;正文可定位的代表性工作点有compression ratio of 1/12。 PDF p.4
仿真结果表明,与传统的低密度奇偶校验(LDPC)码BPG方案相比,L-VQAE方案的峰值信噪比(PSNR)有了显著提高,且避免了悬崖效应,性能优于BPG+LDPC方案,具有更优的鲁棒性和图像重建能力。 PDF p.1PDF p.4
架构/方法图|来源:《Lightweight Digital Semantic Communication Based on DeepReceiver》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Lightweight Digital Semantic Communication Based on DeepReceiver》,原 PDF p.5,Fig. 5 The MS-SSIM performance of the L-VQAE on ImageNet dataset with different compression ratios 核对论文
核心纳入2025任务导向推理
Lightweight Task-Oriented Semantic Communication Empowered by Large-Scale AI Models
现有进展:最近的研究集中在利用大规模人工智能(LAI)模型来提高语义表示和压缩能力。 PDF p.1
仍然存在的问题:然而,LAI模型的大量计算需求对实时通信场景提出了重大挑战。 PDF p.1
为什么已有方法解决不了:像素级重建是比下游决策更强、也更昂贵的目标;但只压缩 feature 又可能丢掉决定任务的少量证据,因此需要把任务 loss 与通信瓶颈联合设计。 PDF p.1
为什么这个问题重要:边缘设备常需要及时决策而不是完整副本;只发送任务充分信息可以降低时延与带宽,但前提是关键证据确实能穿过信道。 PDF p.1
本文提出什么:针对这一问题,提出了利用知识提炼(KD)技术从LAI模型中提取和浓缩知识,有效降低模型复杂度和计算延迟。 PDF p.1
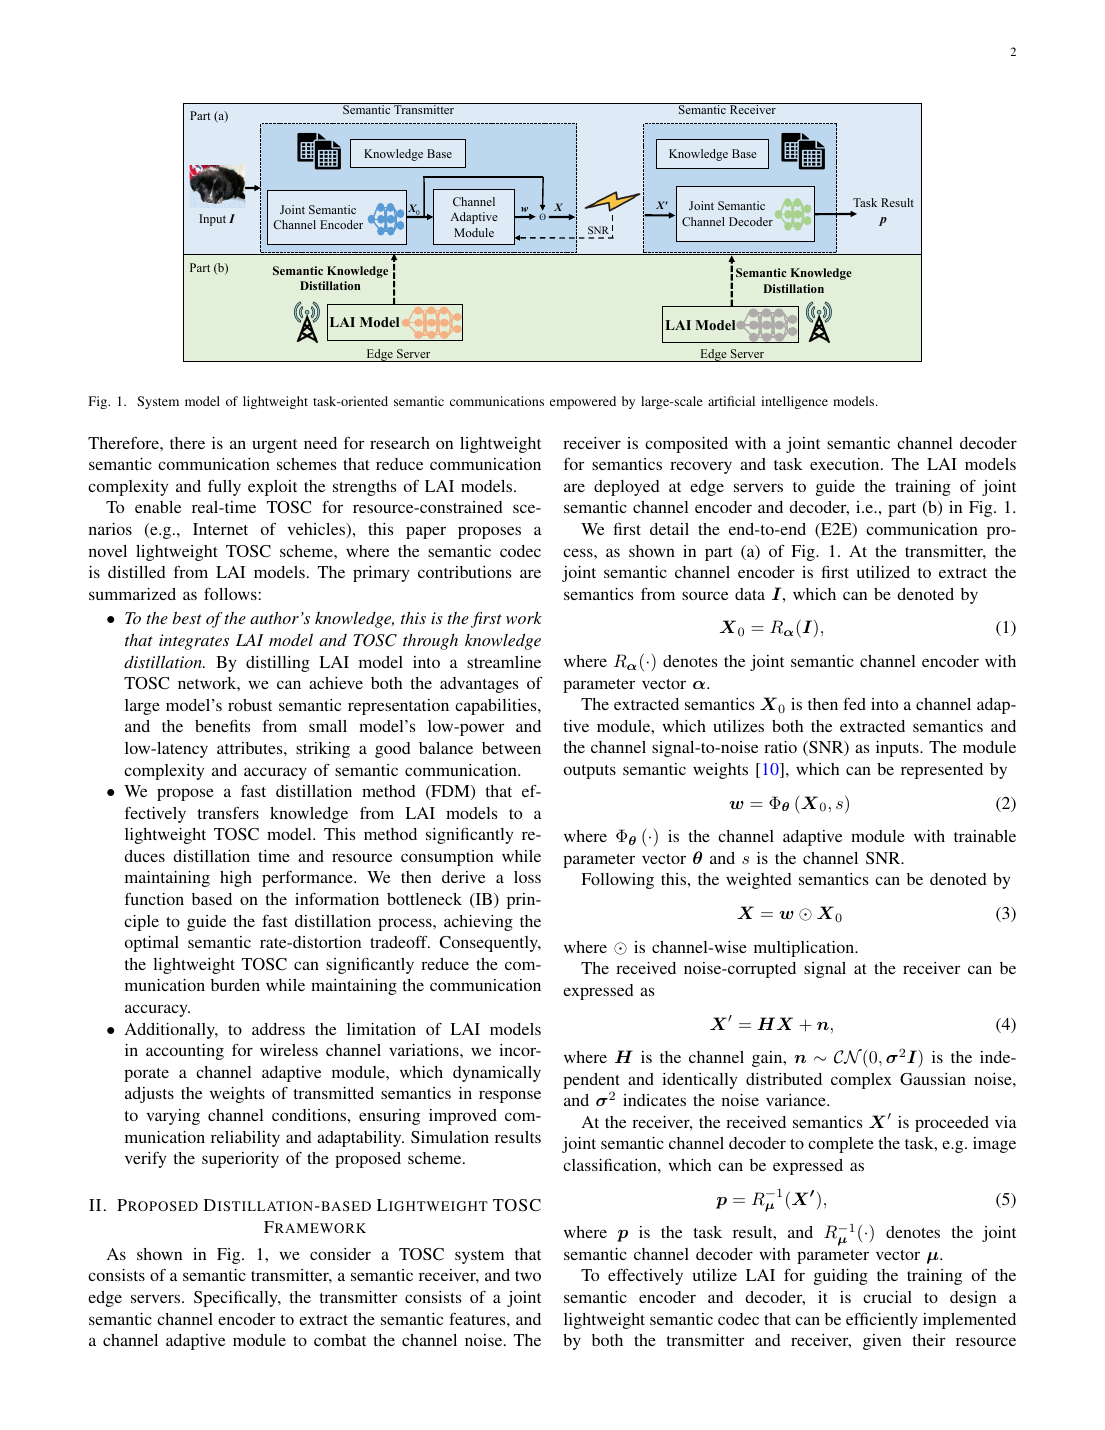
方案为何可能有效:为了实现资源受限场景(如车联网)下的实时TOSC,该文提出了一种新的轻量级TOSC方案,该方案从LAI模型中提取语义编码。 PDF p.2
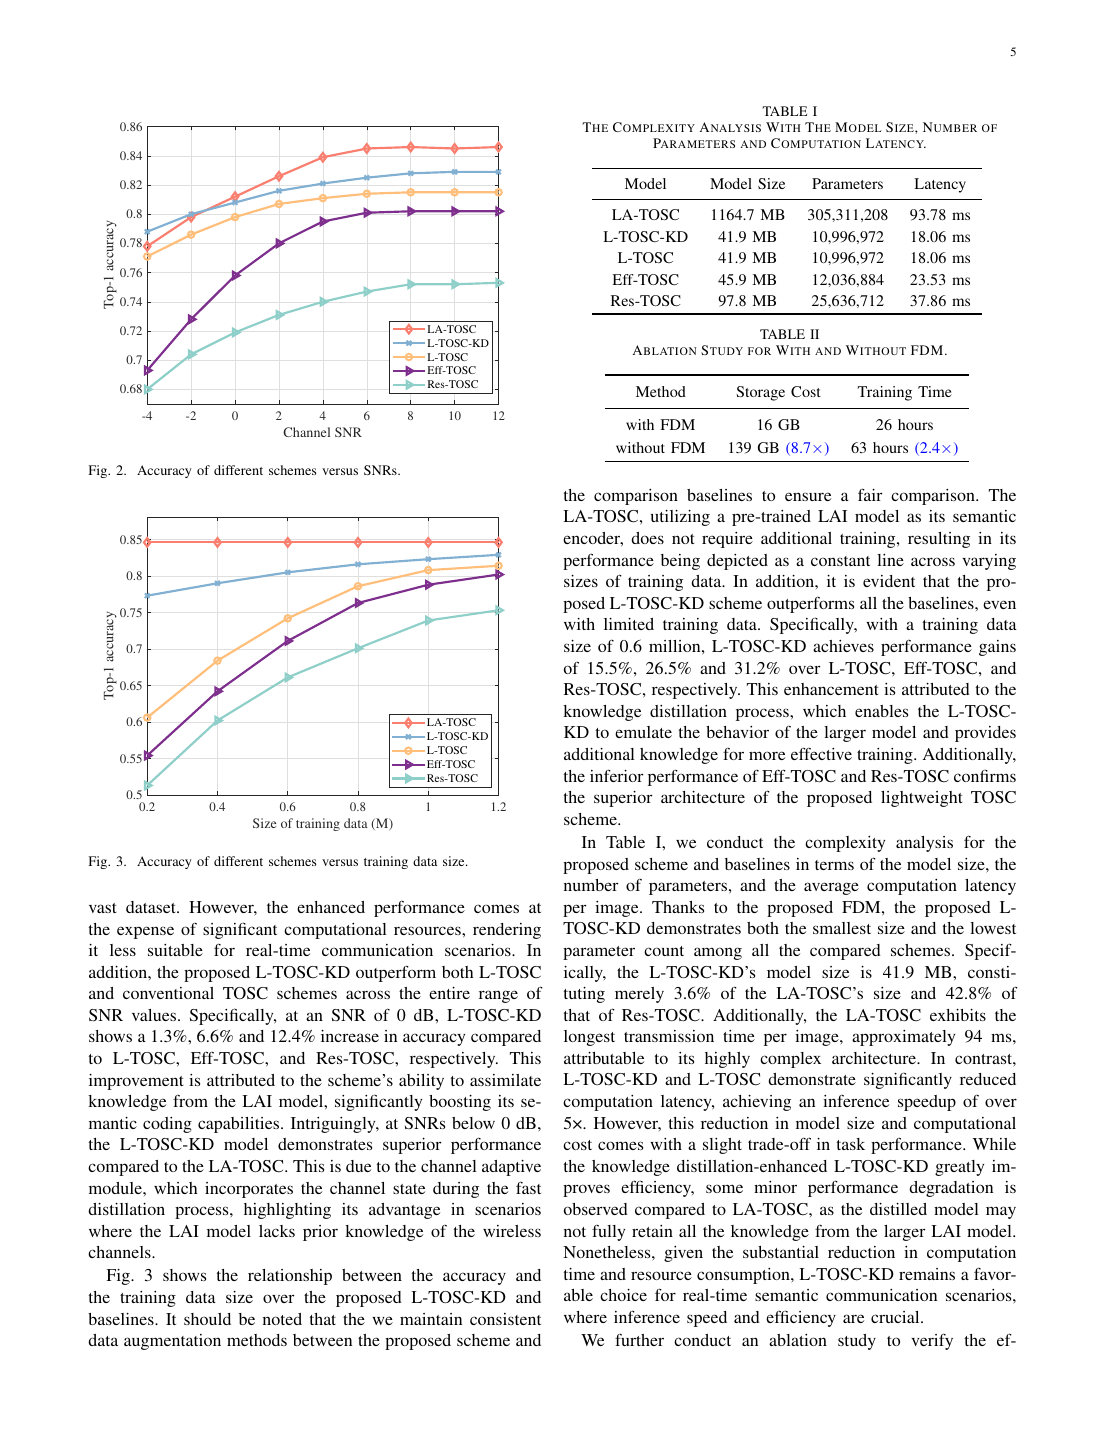
作者希望证明什么:实验表明该方案在任务准确性、模型规模、计算延迟和训练数据需求等方面均优于基准方案。 PDF p.1
方法与端到端信息流
针对这一问题,本文提出了利用知识提炼(KD)技术从LAI模型中提取和浓缩知识,有效地降低了模型复杂度和计算延迟。本文提出了一种新的轻量化TOSC方案,其中语义编解码器是从LAI模型中提取出来的。为了在资源受限的场景中启用实时TOSC该文提出了一种新的轻量级TOSC方案,该方案从LAI模型中提取语义编码。 PDF p.1PDF p.2
输入输入是任务导向推理所需的源数据与下游任务所需特征。
发送端发送端采用 Lightweight Task-Oriented Semantic Communication Empowered by Large-Scale AI Models:针对这一问题,本文提出了利用知识提炼(KD)技术从LAI模型中提取和浓缩知识,有效地降低了模型复杂度和计算延迟。本文提出了一种新的轻量化TOSC方案,其中语义编解码器是从LAI模型中提取出来的。为了在资源受限的场景中启用实时TOSC该文提出了一种新的轻量级TOSC方案,该方案从LAI模型中提取语义编码。
实际发送实际发送对象是语义 feature 或未完整规定 bit 映射的 latent。
信道信道作用方式按“类别 0:信道作用点不足,或由外部传统链路抽象承担”解释。
接收端接收端从论文假设已经恢复的语义特征开始,再执行语义解码、任务推理或生成。
输出最终输出为分类、分割、检索或其他任务决策。
它在通信系统中的位置:只传下游任务需要的信息,并以任务质量而不是逐 bit 正确作为最终目标。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:语义 feature/latent;量化到 bitstream 的接口未完整报告
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“语义 feature/latent;量化到 bitstream 的接口未完整报告”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:Lightweight Task-Oriented Semantic Communication Empowered by Large-Scale AI Models 的主传输单位属于“语义 feature/latent;量化到 bitstream 的接口未完整报告”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
论文未同时报告输入尺寸、encoder 输出尺寸、量化精度/码本大小和帧级开销,因此不能从全文唯一重建总 bit 数。页面保留论文实际使用的 CBR、bpp、token 数或信道使用次数;缺失项不作臆测。 PDF p.2PDF p.4
架构/方法图|来源:《Lightweight Task-Oriented Semantic Communication Empowered by Large-Scale AI Models》,原 PDF p.2,Fig. 1 We first detail the end-to-end (E2E) communication process, as shown in part (a) of 核对论文关键实验结果图/表|来源:《Lightweight Task-Oriented Semantic Communication Empowered by Large-Scale AI Models》,原 PDF p.5,Fig. 2 Accuracy of different schemes versus SNRs 核对论文
核心纳入2025语义感知资源分配与网络优化
Mixture of Experts-Based Semantic Communication for Secure Artificial Intelligence of Things
现有进展:基于深度学习的语义通信系统在人工智能物联网(AIoT)(例如,智能交通系统(ITS))中有效地传输信息方面已经变得普遍。 PDF p.1
仍然存在的问题:然而,它们在无线网络上的部署引入了显著的安全漏洞,包括语义噪声攻击、物理层对抗攻击和窃听攻击。 PDF p.1
为什么已有方法解决不了:只优化合法接收端的重建或任务 loss,并不会自动消除 latent 泄露、窃听或操纵风险;缺少的是把攻击者与保护目标放进同一系统模型。 PDF p.1
为什么这个问题重要:功率、带宽、算力和时延是共享资源;若调度器不知道语义效用,它可能增加吞吐量却没有改善任何用户真正关心的任务。 PDF p.1
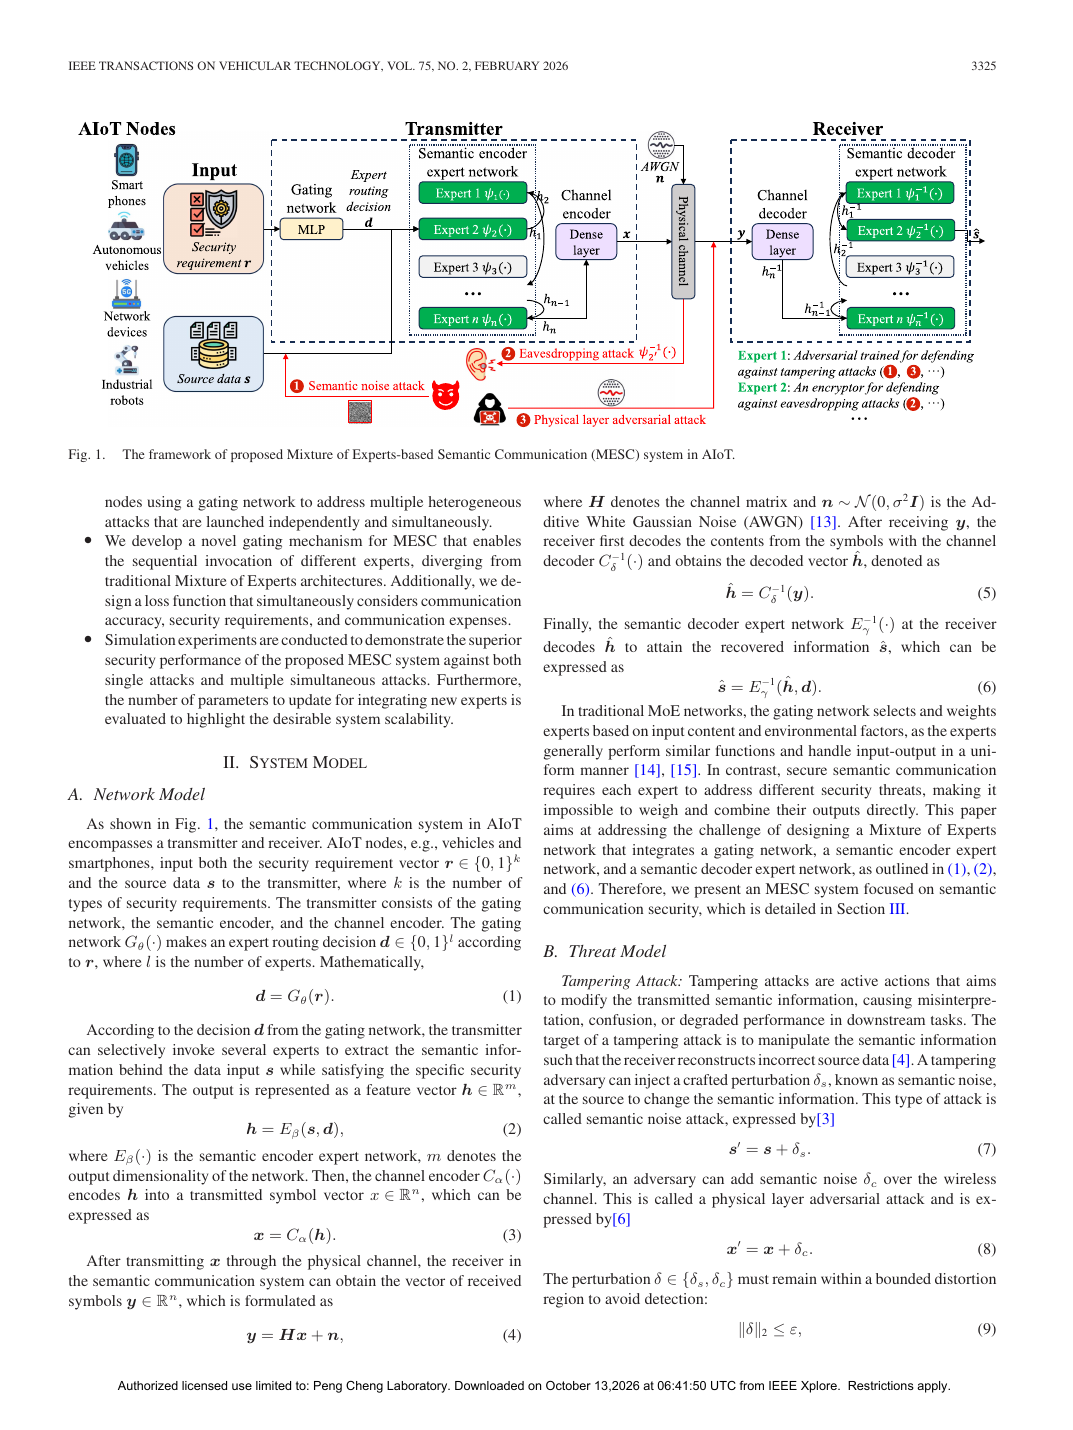
本文提出什么:为了解决这个问题,本文介绍了一种基于专家的语义通信(MESC)混合系统,该系统根据AIoT节点的安全需求自适应地选择合适的安全专家。 PDF p.1
方案为何可能有效:因此,我们提出了一个MESC系统侧重于语义通信安全,这是详细的第三节。 PDF p.2
作者希望证明什么:此外,MESC的可扩展性允许以最低的培训费用增加新的安全专家,从而大大降低了持续成本。 PDF p.1
方法与端到端信息流
为了解决这一问题,本文提出了一种基于专家的语义通信混合系统(MESC),该系统根据AIoT节点的安全需求自适应地选择合适的安全专家,因此,我们提出了一种专注于语义通信安全的MESC系统,第三节详细介绍了基于专家的语义通信混合(MESC)的框架。系统中的AIoT。节点使用门控网络来解决独立且同时发起的多个异构攻击。r我们为MESC开发了一种新的门控机制,该机制能够顺序调用不同的专家,与传统的专家混合架构不同。 PDF p.1PDF p.2
架构/方法图|来源:《Mixture of Experts-Based Semantic Communication for Secure Artificial Intelligence of Things》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Mixture of Experts-Based Semantic Communication for Secure Artificial Intelligence of Things》,原 PDF p.4,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2025多模态检索与任务通信
Multimodal Semantic Communications Empowered Lane-Change Planning for Autonomous Driving
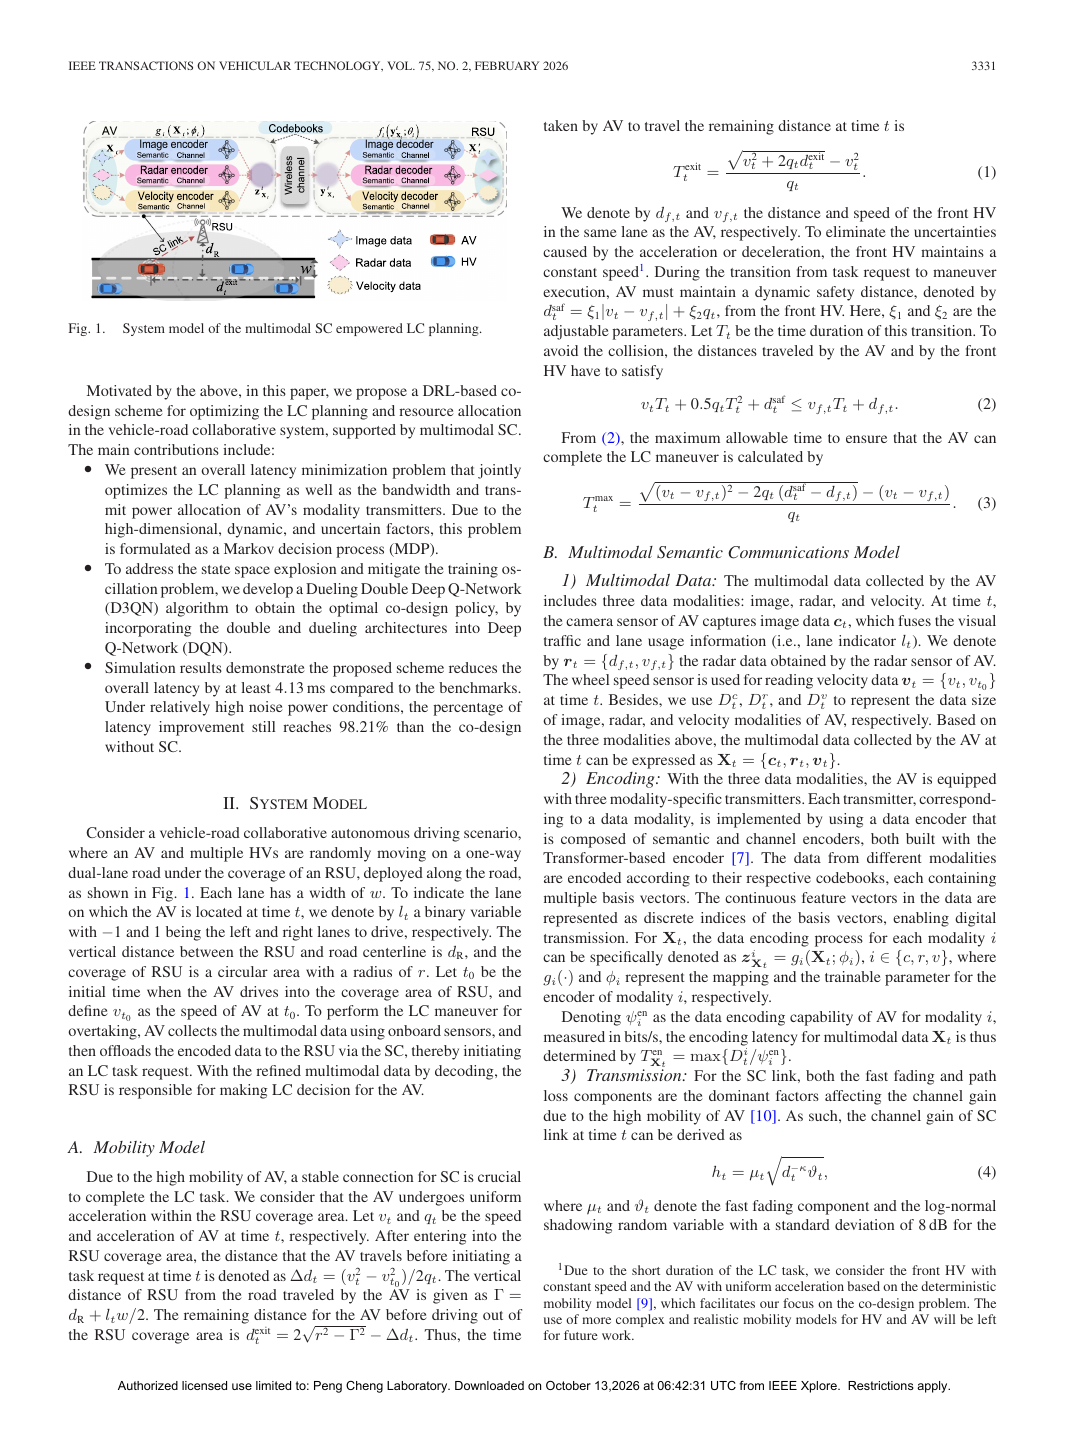
现有进展:为了满足复杂和动态的交通情况下,SC使能LC规划必须动态分配无线资源的多模态语义表示的基础上。 PDF p.1
仍然存在的问题:然而,为了适应动态复杂的交通环境,基于多模态语义表示的动态资源分配是至关重要的,这需要运动规划和资源分配的协同设计。 PDF p.1
为什么已有方法解决不了:只按 bit rate、吞吐量或平均失真分配资源,无法区分不同样本和任务的语义价值;外层优化必须得到可用的语义效用—资源曲线。 PDF p.1
为什么这个问题重要:语义质量必须在真实的带宽、功率和时延预算下成立,否则模型收益不能转化为通信系统收益。 PDF p.1
本文提出什么:然而,为了适应动态复杂的交通环境,基于多模态语义表示的动态资源分配是至关重要的,这需要运动规划和资源分配的协同设计。 PDF p.1
方案为何可能有效:基于上述考虑,本文提出了一种基于DRL的协同设计方案,用于优化多模态供应链支持下的车路协同系统中的LC规划和资源分配。 PDF p.2
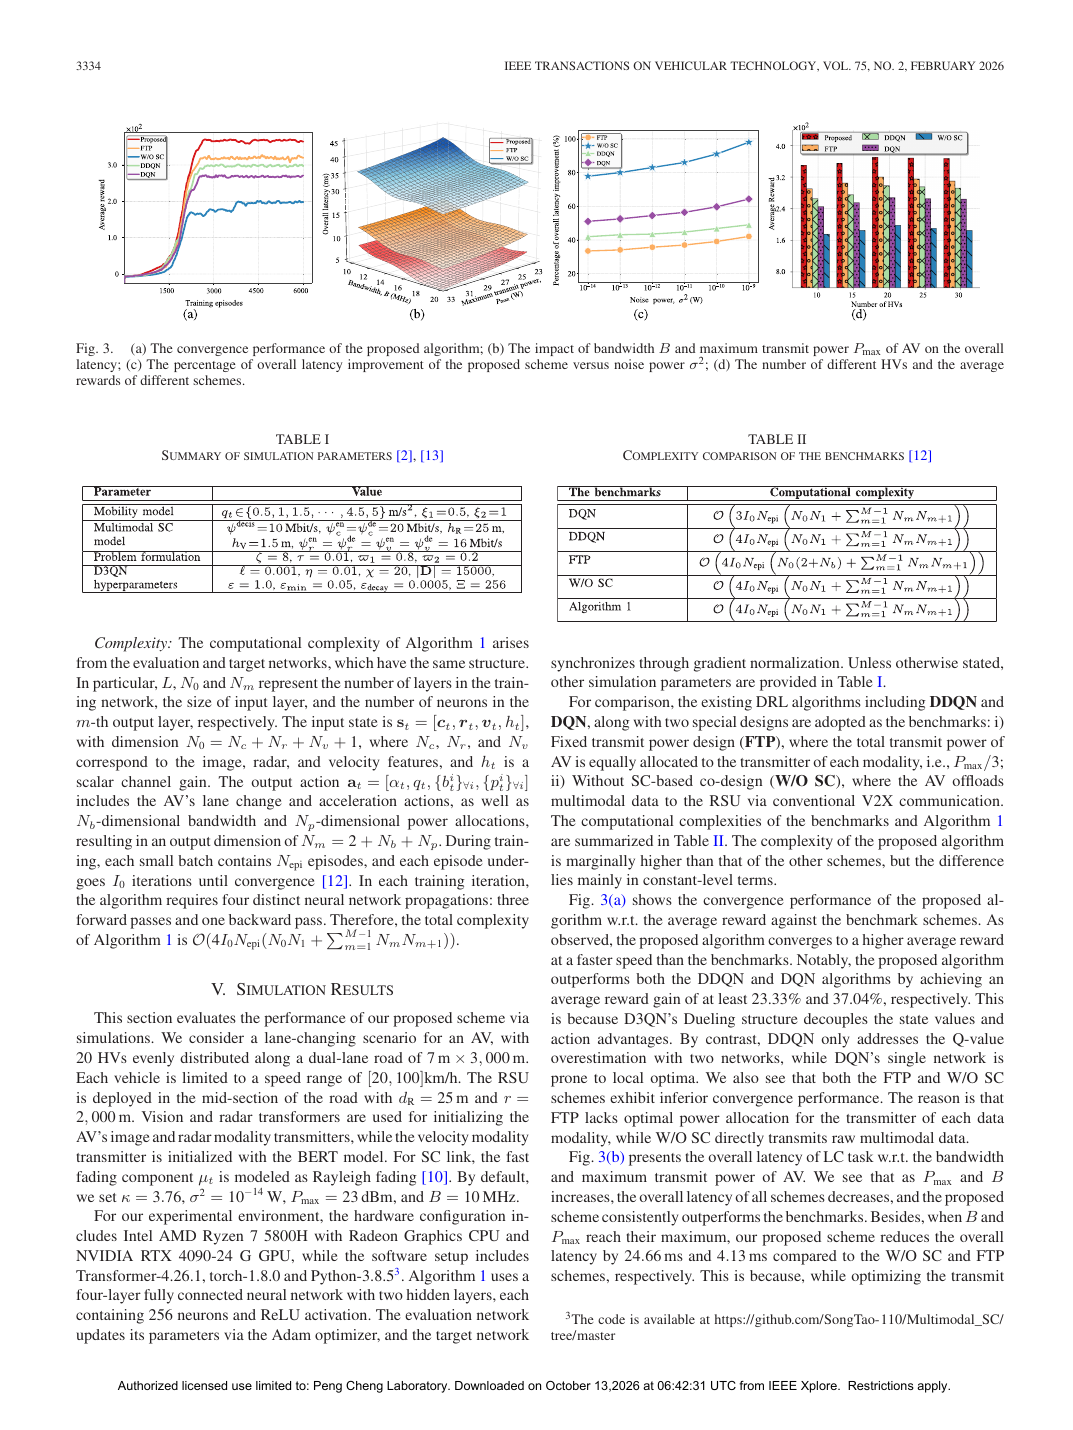
作者希望证明什么:仿真结果表明,我们提出的方案的优越性,实现了至少4.13毫秒的整体延迟减少和延迟改善的百分比高达98.21的基准。 PDF p.1
方法与端到端信息流
基于此,本文提出了一种基于DRL的车辆-道路协同系统中LC规划与资源分配的协同设计方案,并对该方案进行了仿真验证,结果表明该方案能够有效地解决车辆-道路协同系统中LC规划与资源分配的问题,基于以上考虑,本文提出了一种基于DRL的协同设计方案,用于优化多模态供应链支持下的车路协同系统中的LC规划和资源分配。 PDF p.1PDF p.2
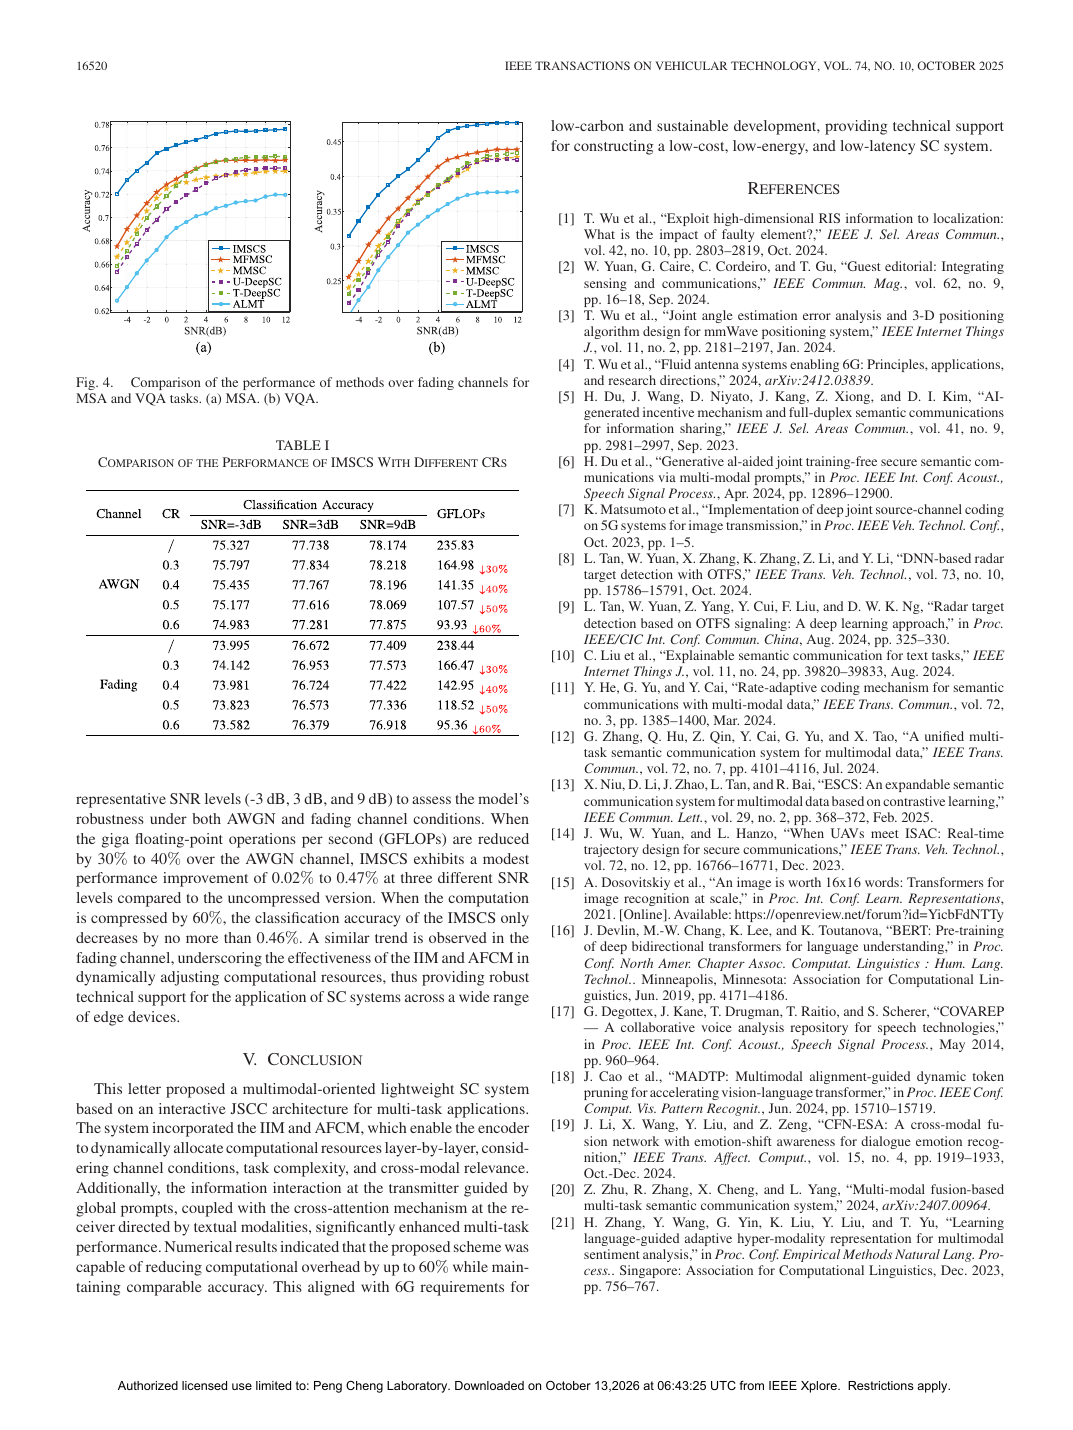
架构/方法图|来源:《Multimodal-Oriented Interactive Joint Source-Channel Coding for Lightweight Semantic Communication》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Multimodal-Oriented Interactive Joint Source-Channel Coding for Lightweight Semantic Communication》,原 PDF p.5,Fig. 4 Comparison of the performance of methods over fading channels for MSA and VQA tasks 核对论文
核心纳入2025图像传输、压缩或生成
PreNet Aided DF-JSCC: An Optimized Approach for Wireless Semantic Image Transmission Over Dynamic Radio Channels
仍然存在的问题:为了应对这些挑战,研究人员深入研究了无线语义图像传输(WSIT)技术。 PDF p.1
为什么已有方法解决不了:分离压缩与信道编码优化的是中间 bit 可靠性,未必等价于本文关心的语义/任务质量;反过来,只做端到端网络而不交代带宽、功率和信道作用点也无法形成公平通信比较。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
本文提出什么:本文提出了一种非常灵活的联合信源信道编码(DF-JSCC)方案和传输性能预测网络(PreNet),以改善整体WSIT系统的性能。 PDF p.1
方案为何可能有效:首先,我们将一个多信道特征融合模块(MC-FFM)到DF-JSCC,以提高捕获不同尺度的详细图像特征的能力。 PDF p.1
作者希望证明什么:实验结果表明,与DeepJSCC-V和WITT方案相比,DF-JSCC方案的PSNR分别提高了至少0.93 dB和0.44 dB,同时在相同传输条件下,资源消耗减少了50%以上,体现了其在频谱效率方面的更优的性能。 PDF p.1
方法与端到端信息流
本文提出了一种高度灵活的联合信源信道编码(DF-JSCC)方案和传输性能预测网络(PreNet)来改善WSIT系统的整体性能。首先,我们在DF-JSCC中加入了多信道特征融合模块(MC-FFM),以增强在不同尺度下捕获详细图像特征的能力。本文提出了一种非常灵活的联合信源信道编码(DF-JSCC)方案和一种预测网络(PreNet)模型,以实现更灵活和自适应的码率控制,以及在不同信道条件和传输内容下的性能预测。 PDF p.1PDF p.3
实验结果表明,与DeepJSCC-V和WITT方案相比,DF-JSCC方案的峰值信噪比分别提高了至少0.93dB和0.44dB,在相同传输条件下,其资源消耗降低了50%以上,虽然FEM和MC-FFM始终提供比DeepJSCC-V和ADJSCC更高的PSNR,但是它们在低SNR区域中的性能更接近于DF-JSCC。 PDF p.1PDF p.9
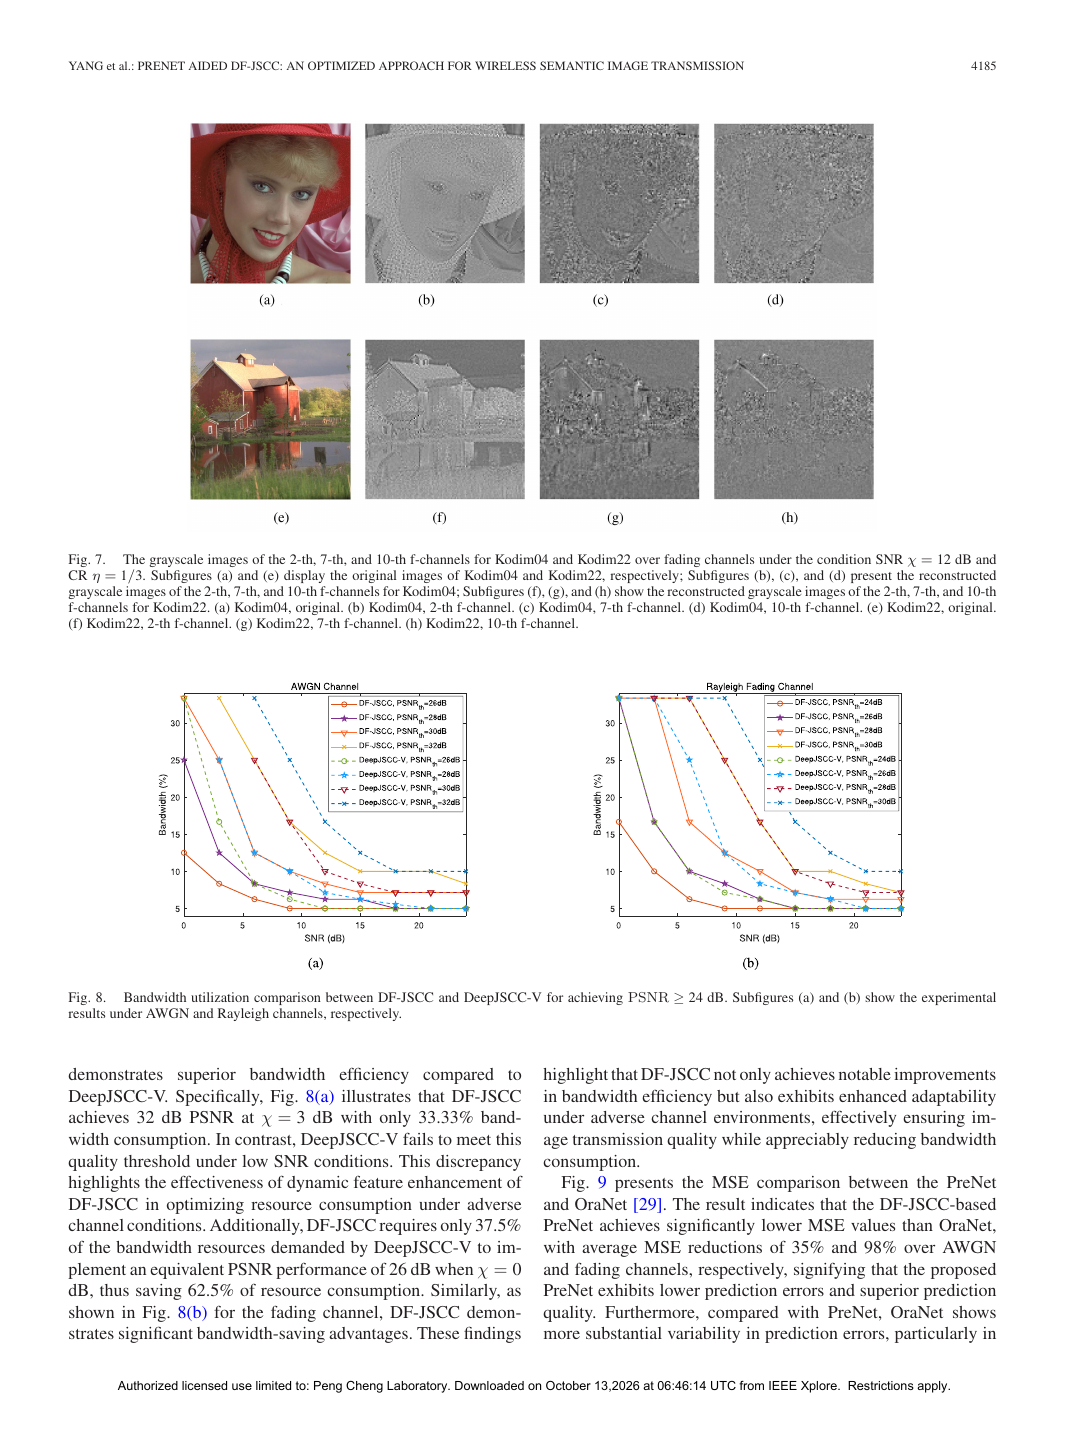
架构/方法图|来源:《PreNet Aided DF-JSCC: An Optimized Approach for Wireless Semantic Image Transmission Over Dynamic Radio Channels》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《PreNet Aided DF-JSCC: An Optimized Approach for Wireless Semantic Image Transmission Over Dynamic Radio Channels》,原 PDF p.10,Fig. 8 Bandwidth utilization comparison between DF-JSCC and DeepJSCC-V for achieving PSNR ≥ 24 dB 核对论文
相关但非核心2025图像传输、压缩或生成
QoE-Aware Latency Optimization in Semantic Transmission Empowered Edge Assisted AR
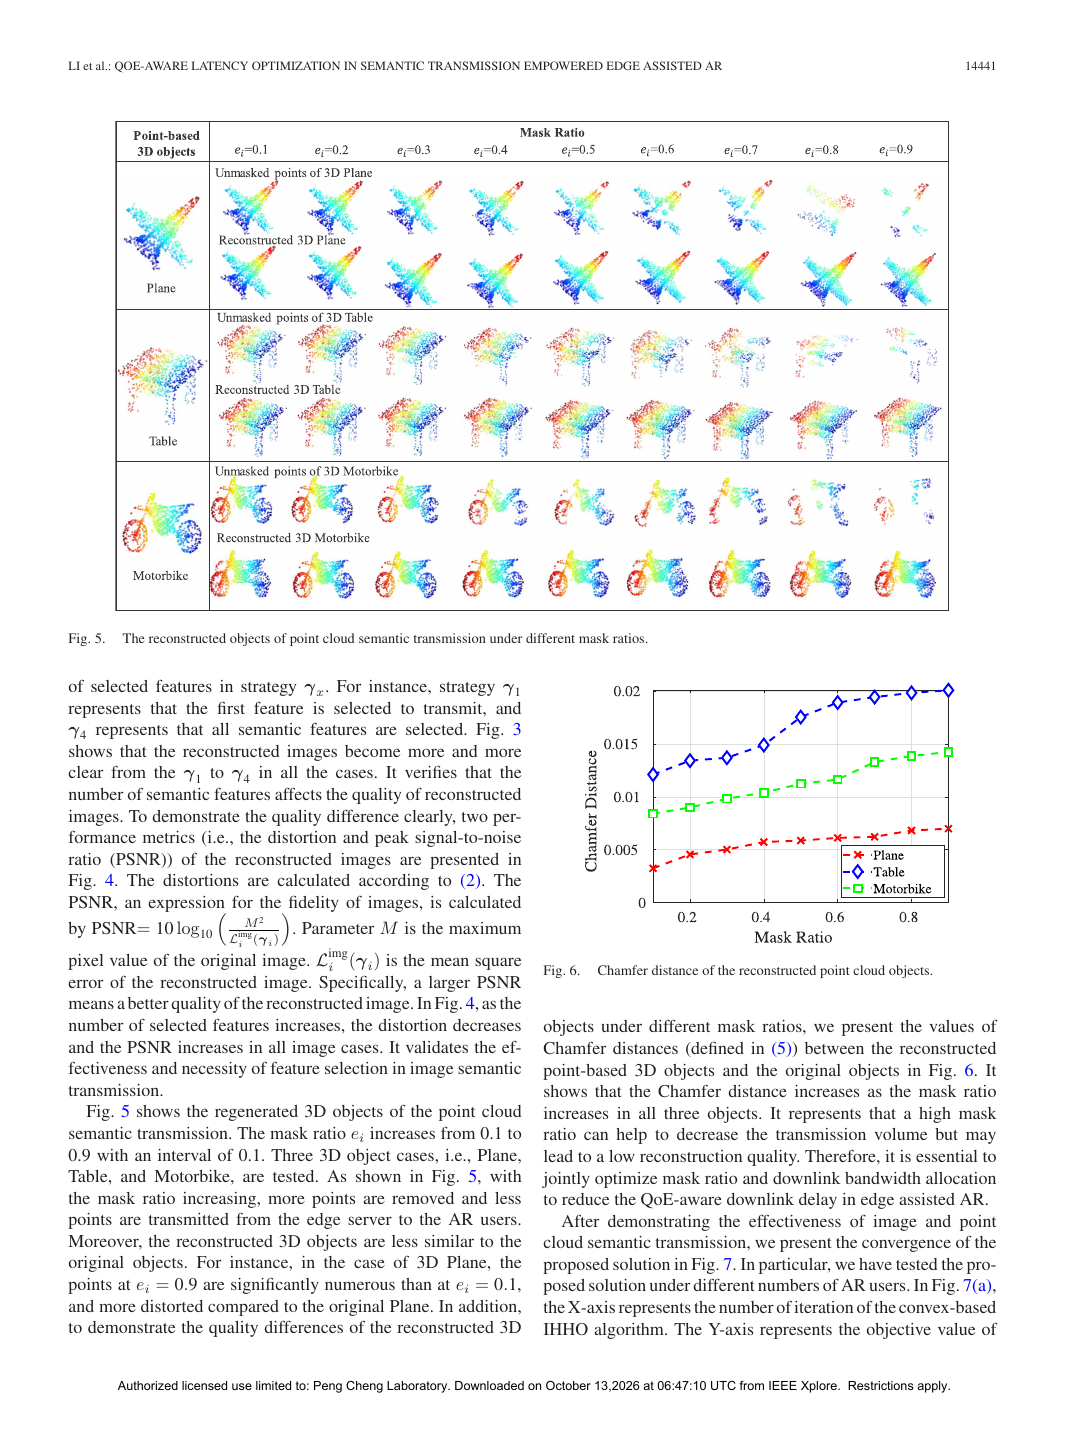
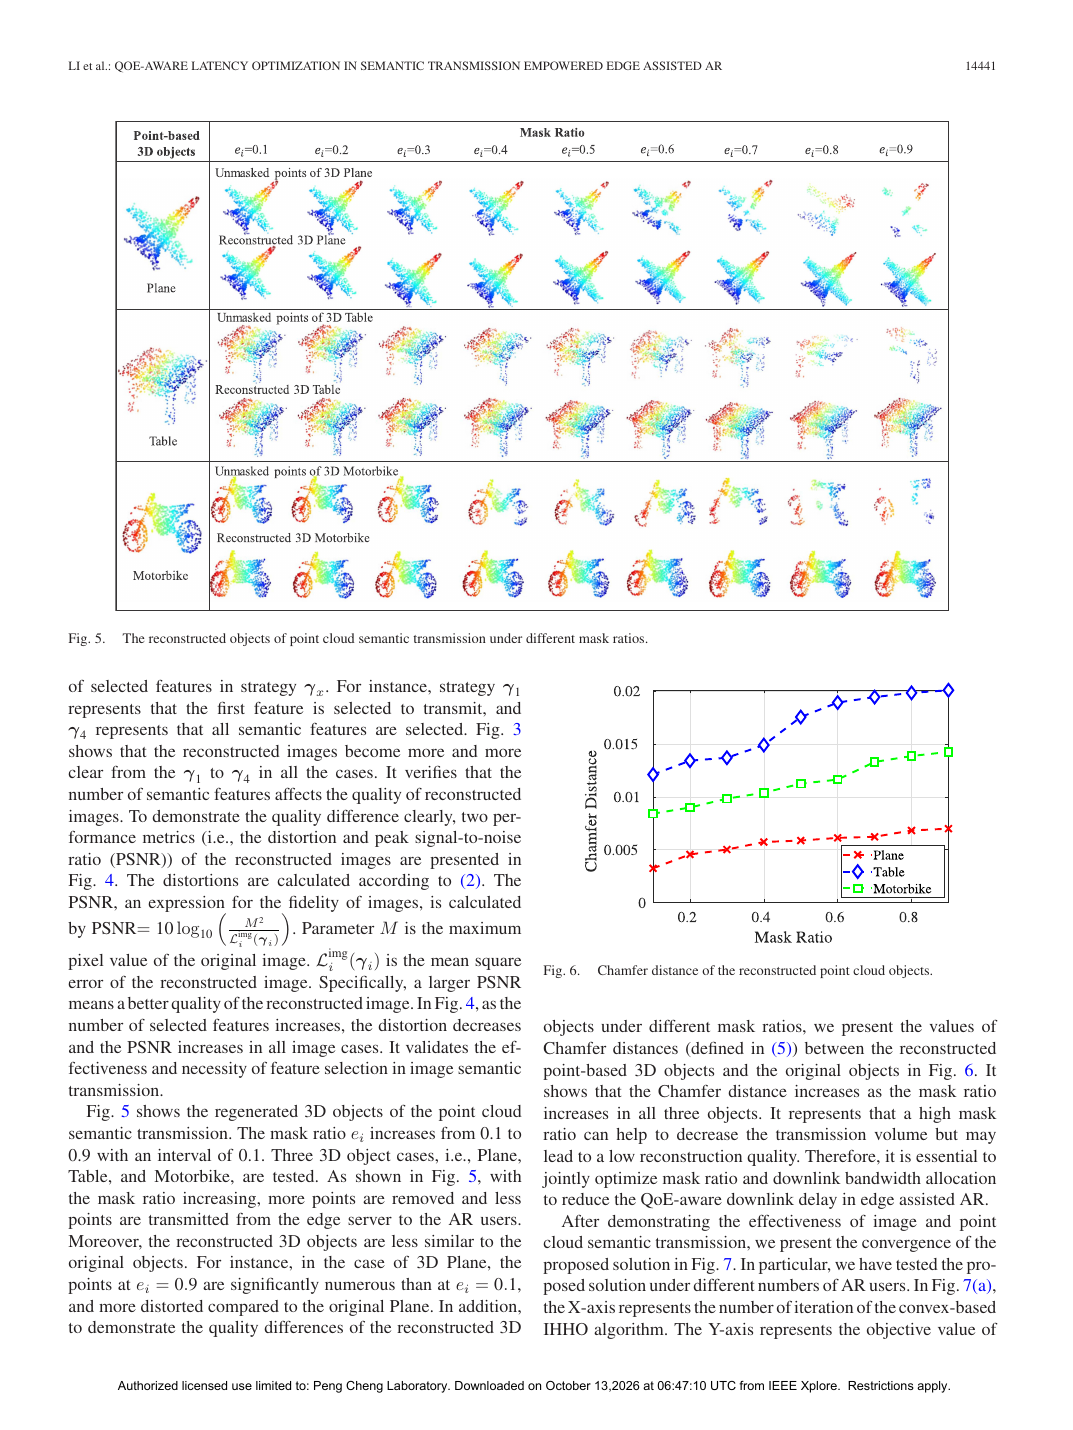
架构/方法图|来源:《QoE-Aware Latency Optimization in Semantic Transmission Empowered Edge Assisted AR》,原 PDF p.10,Fig. 5 The reconstructed objects of point cloud semantic transmission under different mask ratios 核对论文关键实验结果图/表|来源:《QoE-Aware Latency Optimization in Semantic Transmission Empowered Edge Assisted AR》,原 PDF p.10,Fig. 7 In particular, we have tested the proposed solution under different numbers of AR users 核对论文
核心纳入2025图像传输、压缩或生成
Robust Semantic Communication via Adversarial Training
现有进展:近年来,神经网络(NN)取得了显著的进步,特别是在跨文本、图像、音频和视频的编码任务方面。 PDF p.1
仍然存在的问题:但是,它们也面临着众多挑战,包括智能数据传输和海量数据量的传输。 PDF p.1
为什么已有方法解决不了:分离压缩与信道编码优化的是中间 bit 可靠性,未必等价于本文关心的语义/任务质量;反过来,只做端到端网络而不交代带宽、功率和信道作用点也无法形成公平通信比较。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
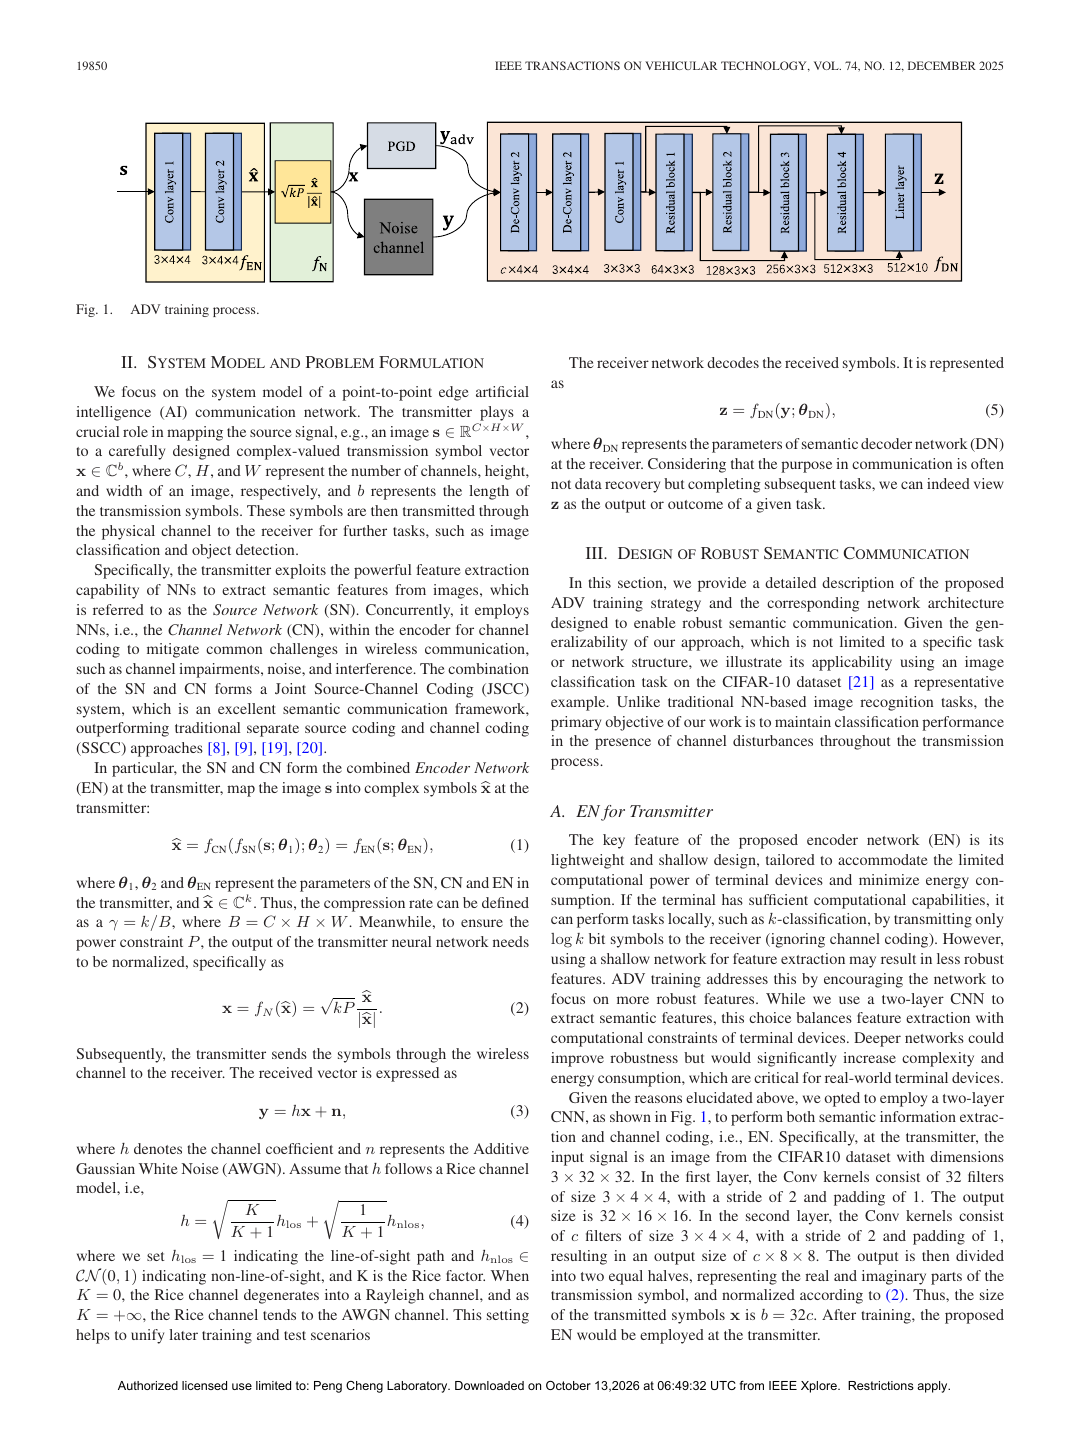
本文提出什么:为了应对这一挑战,我们提出了一种强大的语义通信方法,该方法利用对抗(ADV)训练来扩大其在各种不可见信道条件下的适应性。 PDF p.1
方案为何可能有效:具体来说,我们的方法通过结合ADV训练,使NN受到精心制作的ADV扰动,模仿不同的信道失真,增强了语义通信系统在不同信道条件下的鲁棒性。 PDF p.1
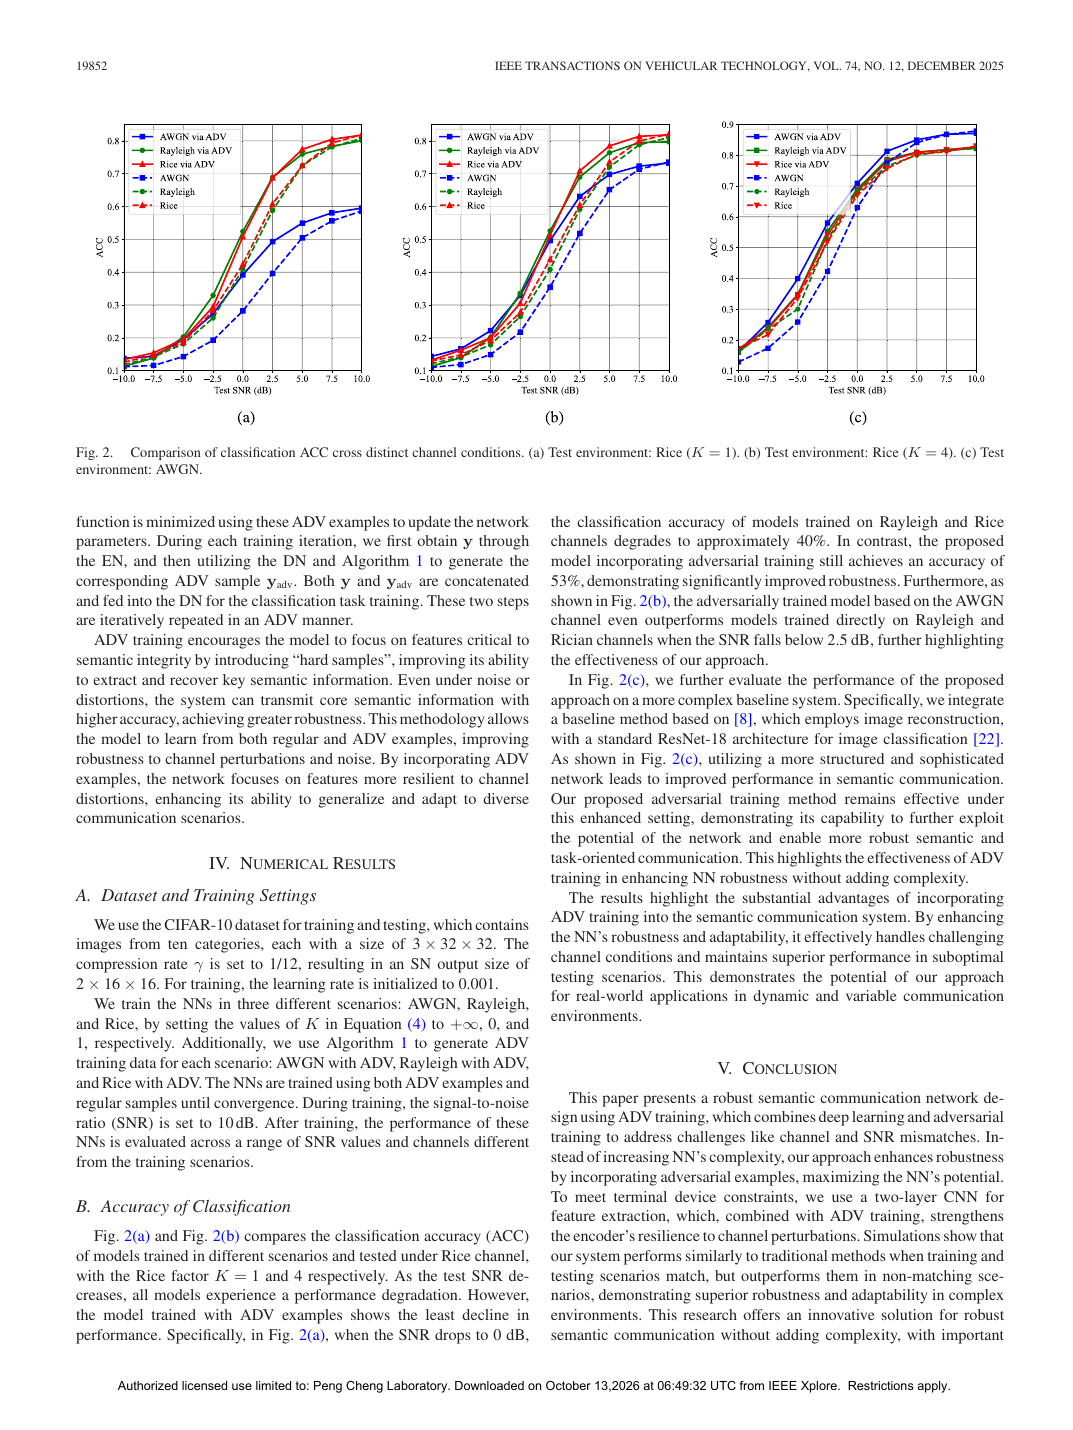
作者希望证明什么:仿真实验表明,集成ADV训练产生了超过10%的信道状态变化时,在不增加神经网络的复杂性大幅提高性能。 PDF p.1
方法与端到端信息流
为了应对这一挑战,我们提出了一种鲁棒的语义通信方法,该方法利用对抗(ADV)训练来扩大其在各种不可见信道条件下的适应性。具体来说,我们的方法通过结合ADV训练来增强语义通信系统在不同信道条件下的鲁棒性,使神经网络受到精心制作的ADV扰动,模仿不同的信道失真。它表示我们专注于点到点的系统模型,点边缘人工智能(AI)通信网络。 PDF p.1PDF p.2
架构/方法图|来源:《Robust Semantic Communication via Adversarial Training》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Robust Semantic Communication via Adversarial Training》,原 PDF p.4,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2025文本传输或语言任务
Robust Transmission of Punctured Text With Large Language Model-Based Recovery
仍然存在的问题:然而,由于特征提取依赖于基于学习的模型,其性能从根本上取决于训练数据集或任务。 PDF p.1
为什么已有方法解决不了:把生成模型放在接收端并不等于通信开销自然降低;仍需明确发送什么条件、条件占多少资源,以及信道破坏条件时怎样约束幻觉和时延。 PDF p.1
为什么这个问题重要:一个 token 错误就可能改变整句含义,因此仅看 BER 不足以评价链路;必须追踪最终语言意义或任务输出。 PDF p.1
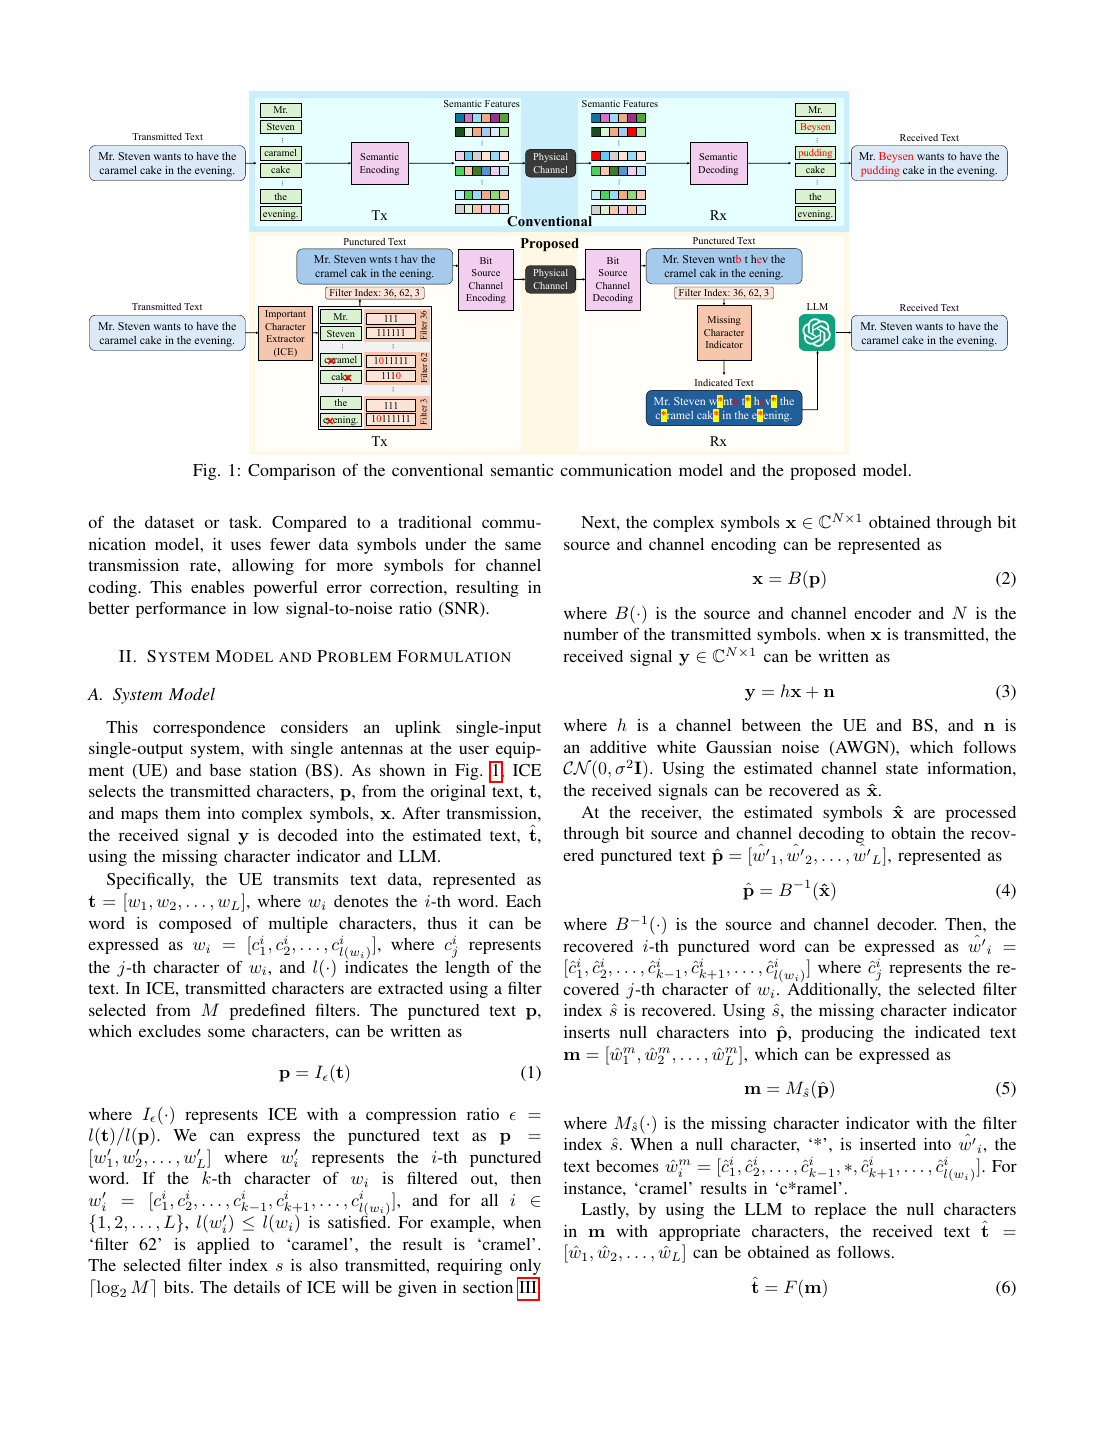
本文提出什么:为此,我们的贡献如下:不同于现有的传输模型,执行字级特征提取,该模型选择性地传输字符的基础上提出的算法,并在接收端处重建它们。 PDF p.1
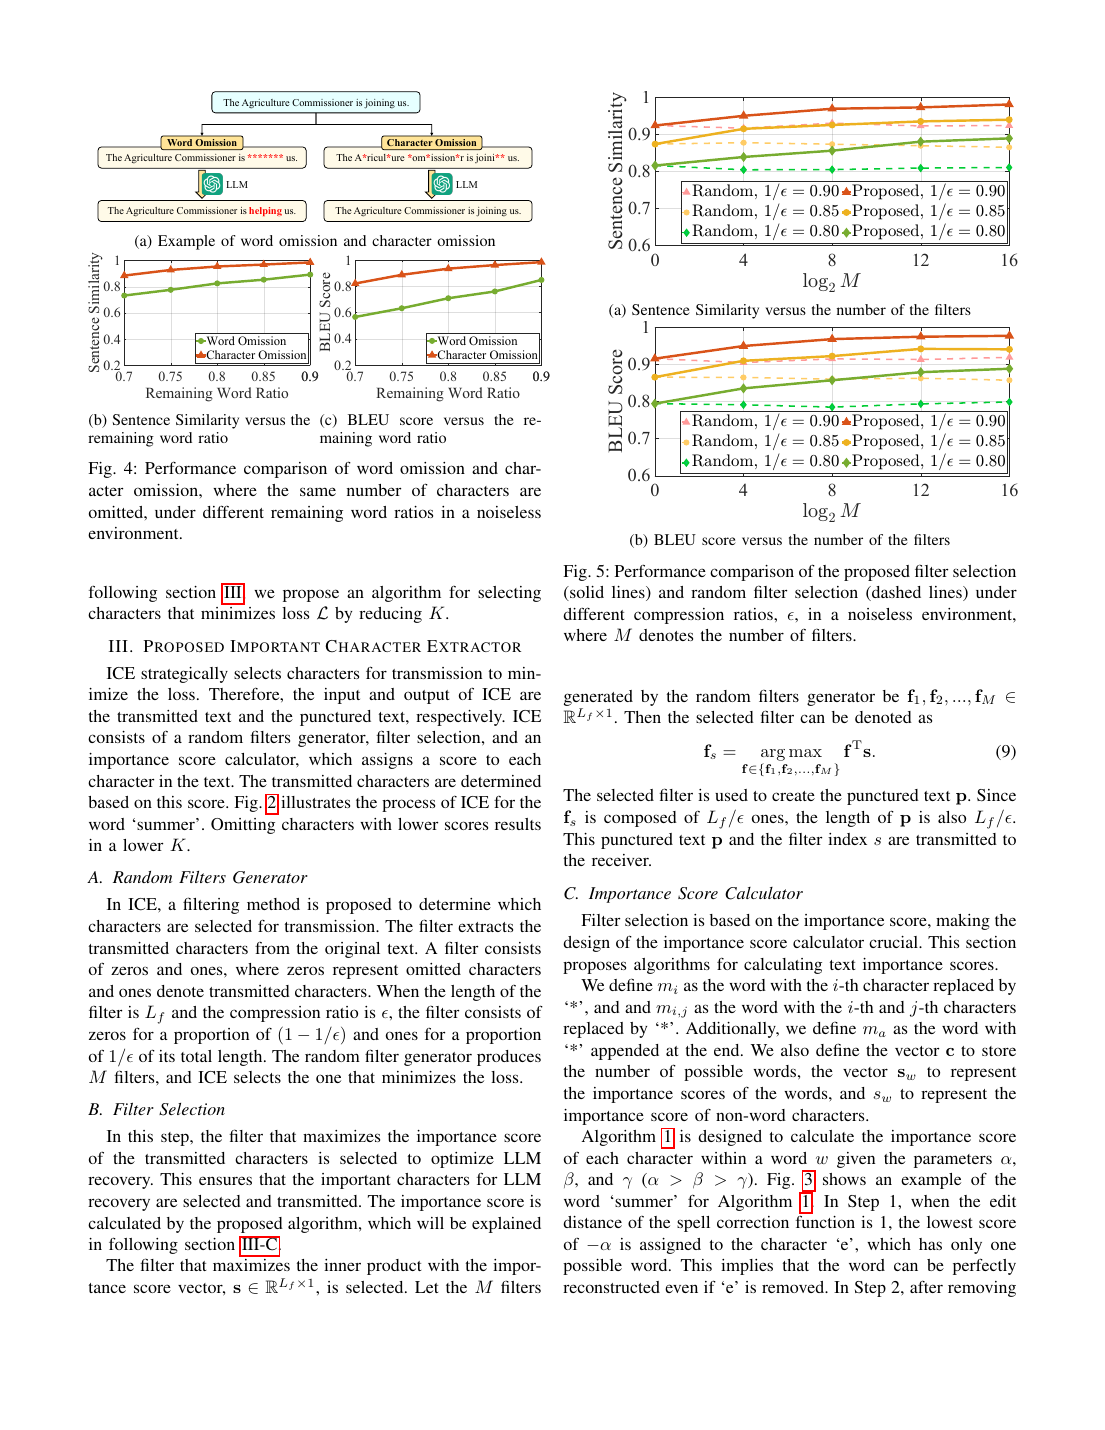
方案为何可能有效:因此,我们专注于优化ICE以生成可以由LLM有效恢复的打孔文本。 PDF p.3
作者希望证明什么:此外,该模型在不同的数据集和任务之间表现出鲁棒的性能,并且在低信噪比条件下优于传统通信。 PDF p.1
方法与端到端信息流
为此,我们的贡献如下:与现有的执行字级特征提取的传输模型不同,所提出的模型基于所提出的算法选择性地传输字符并在接收端重构它们。因此,我们专注于优化ICE以生成可以由LLM有效恢复的打孔文本。 PDF p.1PDF p.3
输入输入是文本传输或语言任务所需的句子、token 序列或语言语义。
发送端发送端采用 Robust Transmission of Punctured Text With Large Language Model-Based Recovery:为此,我们的贡献如下:与现有的执行字级特征提取的传输模型不同,所提出的模型基于所提出的算法选择性地传输字符并在接收端重构它们。因此,我们专注于优化ICE以生成可以由LLM有效恢复的打孔文本。
实际发送实际发送对象是语义 feature 或未完整规定 bit 映射的 latent。
信道信道作用方式按“类别 0:信道作用点不足,或由外部传统链路抽象承担”解释。
接收端接收端从论文假设已经恢复的语义特征开始,再执行语义解码、任务推理或生成。
输出最终输出为恢复文本、翻译结果或语言任务输出。
它在通信系统中的位置:利用接收端生成先验,把可预测细节从空口发送对象中移除。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:语义 feature/latent;量化到 bitstream 的接口未完整报告
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“语义 feature/latent;量化到 bitstream 的接口未完整报告”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:Robust Transmission of Punctured Text With Large Language Model-Based Recovery 的主传输单位属于“语义 feature/latent;量化到 bitstream 的接口未完整报告”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
论文未同时报告输入尺寸、encoder 输出尺寸、量化精度/码本大小和帧级开销,因此不能从全文唯一重建总 bit 数。页面保留论文实际使用的 CBR、bpp、token 数或信道使用次数;缺失项不作臆测。 PDF p.2PDF p.4
架构/方法图|来源:《Robust Transmission of Punctured Text With Large Language Model-Based Recovery》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Robust Transmission of Punctured Text With Large Language Model-Based Recovery》,原 PDF p.4,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2025通用语义通信系统
Semantic Communication and Control Co-Design for Multi-Objective Distinct Systems
现有进展:这封信介绍了一种深度学习方法,用于预测具有不同动态和控制规则的不同系统的语义控制动态。 PDF p.1
仍然存在的问题:然而,传统的系统架构将通信和控制分开处理,导致分布式和资源受限环境中的可扩展性瓶颈和稳定性挑战。 PDF p.1
为什么已有方法解决不了:为固定 SNR 或带宽训练的模型具有固定瓶颈和保护方式;条件变化时重复运行同一网络,不能把码率或冗余重新分给变得脆弱的信息。 PDF p.1
为什么这个问题重要:语义质量必须在真实的带宽、功率和时延预算下成立,否则模型收益不能转化为通信系统收益。 PDF p.1
本文提出什么:为此,我们将这种方法扩展到一个更复杂和现实的设置:具有不同的动态和控制规则的系统的多目标控制。 PDF p.1
方案为何可能有效:通过利用自动编码器(AE)框架中的Koopman算子,使用动态语义Koopman(DSK)模型在潜在空间中线性化系统的状态演化,捕获基线语义动态。 PDF p.1
作者希望证明什么:语义逻辑Koopman AE实现了与基线1相当的性能,并且在所有系统中显著优于基线2。 PDF p.5
方法与端到端信息流
为此,我们将这种方法扩展到更复杂和现实的环境:具有不同动态和控制规则的系统的多目标控制。通过利用自动编码器(AE)框架中的Koopman算子,使用动态语义Koopman(DSK)模型在潜在空间中线性化系统的状态演化,捕获基线语义动态。为了解决这个问题,我们在各种深度学习架构(如AE和transformers)中采用基于AE的深度学习方法,因为它在学习系统状态的低维表示方面的简单性和计算效率。 PDF p.1PDF p.3
架构/方法图|来源:《Semantic Communication and Control Co-Design for Multi-Objective Distinct Systems》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Semantic Communication and Control Co-Design for Multi-Objective Distinct Systems》,原 PDF p.4,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2025语义感知资源分配与网络优化
Semantic Communication-Based Aerial–Maritime Energy Trade-Off for Maritime Mobile Edge Computing Networks Under Jamming
架构/方法图|来源:《Semantic Communication-Based Aerial–Maritime Energy Trade-Off for Maritime Mobile Edge Computing Networks Under Jamming》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Semantic Communication-Based Aerial–Maritime Energy Trade-Off for Maritime Mobile Edge Computing Networks Under Jamming》,原 PDF p.10,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2025图像传输、压缩或生成
Semantic-Based Resource Management Based on D2D Multicast Content Delivery: A Game-Theoretic Approach
现有进展:设备到设备(D2 D)组播通信是无线网络设计的重要组成部分,为5G和未来网络架构带来更大的灵活性和效率。 PDF p.1
仍然存在的问题:但是,需要解决两个挑战:用户聚类和基于语义通信的资源管理。 PDF p.1
为什么已有方法解决不了:只按 bit rate、吞吐量或平均失真分配资源,无法区分不同样本和任务的语义价值;外层优化必须得到可用的语义效用—资源曲线。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
本文提出什么:针对用户聚类的第一个问题,我们引入了一种基于语义三元组的结构来提取图像的语义特征,并基于语义特征和其他指标来定义图像交付任务的用户相似度。 PDF p.1
方案为何可能有效:我们考虑最常见的情形,其中BS位于通信系统的中心,并且Ne CU和Nu TU存在于其周围。 PDF p.3
作者希望证明什么:最后,设计了一种基于空间自适应(JSCSA)算法的联合语义压缩比选择和信道分配策略,以达到纳什均衡(NE),并证明了算法的收敛性。 PDF p.1
方法与端到端信息流
对于用户聚类的第一个问题,我们引入了一种基于语义三元组的结构来提取图像的语义特征,并基于语义特征和其他指标来定义图像交付任务的用户相似度。我们考虑了最常见的场景,即BS位于通信系统的中心,并且在其周围存在Ne CU和Nu TU。因此,利用博弈论分析和解决图像语义和无线资源优化问题是一种很有前途的方法和途径。 PDF p.1PDF p.3
输入输入是图像传输、压缩或生成所需的图像及其视觉/任务语义。
发送端发送端采用 Semantic-Based Resource Management Based on D2D Multicast Content Delivery: A Game-Theoretic Approach:对于用户聚类的第一个问题,我们引入了一种基于语义三元组的结构来提取图像的语义特征,并基于语义特征和其他指标来定义图像交付任务的用户相似度。我们考虑了最常见的场景,即BS位于通信系统的中心,并且在其周围存在Ne CU和Nu TU。因此,利用博弈论分析和解决图像语义和无线资源优化问题是一种很有前途的方法和途径。
实际发送实际发送对象是系统模型定义的语义速率、任务效用或信道资源变量。
信道信道作用方式按“类别 5:沿用底层链路或抽象速率—效用模型”解释。
接收端接收端从系统公式假设的接收端输出或语义质量曲线开始,再执行语义解码、任务推理或生成。
输出最终输出为重建/生成图像或视觉任务输出。
它在通信系统中的位置:把语义/任务质量映射为网络效用,再分配功率、带宽、算力或时延。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:上层理论/资源变量;论文不单独定义可发送语义格式
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“上层理论/资源变量;论文不单独定义可发送语义格式”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:Semantic-Based Resource Management Based on D2D Multicast Content Delivery: A Game-Theoretic Approach 的主传输单位属于“上层理论/资源变量;论文不单独定义可发送语义格式”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
论文优化的是功率、带宽、时隙、用户调度或语义效用等上层资源变量,并未定义一条可逐 bit 复现的语义 codec。因而这里只报告系统约束和效用曲线,不能从优化变量反推 token/index 总 bit 数。 PDF p.2PDF p.11
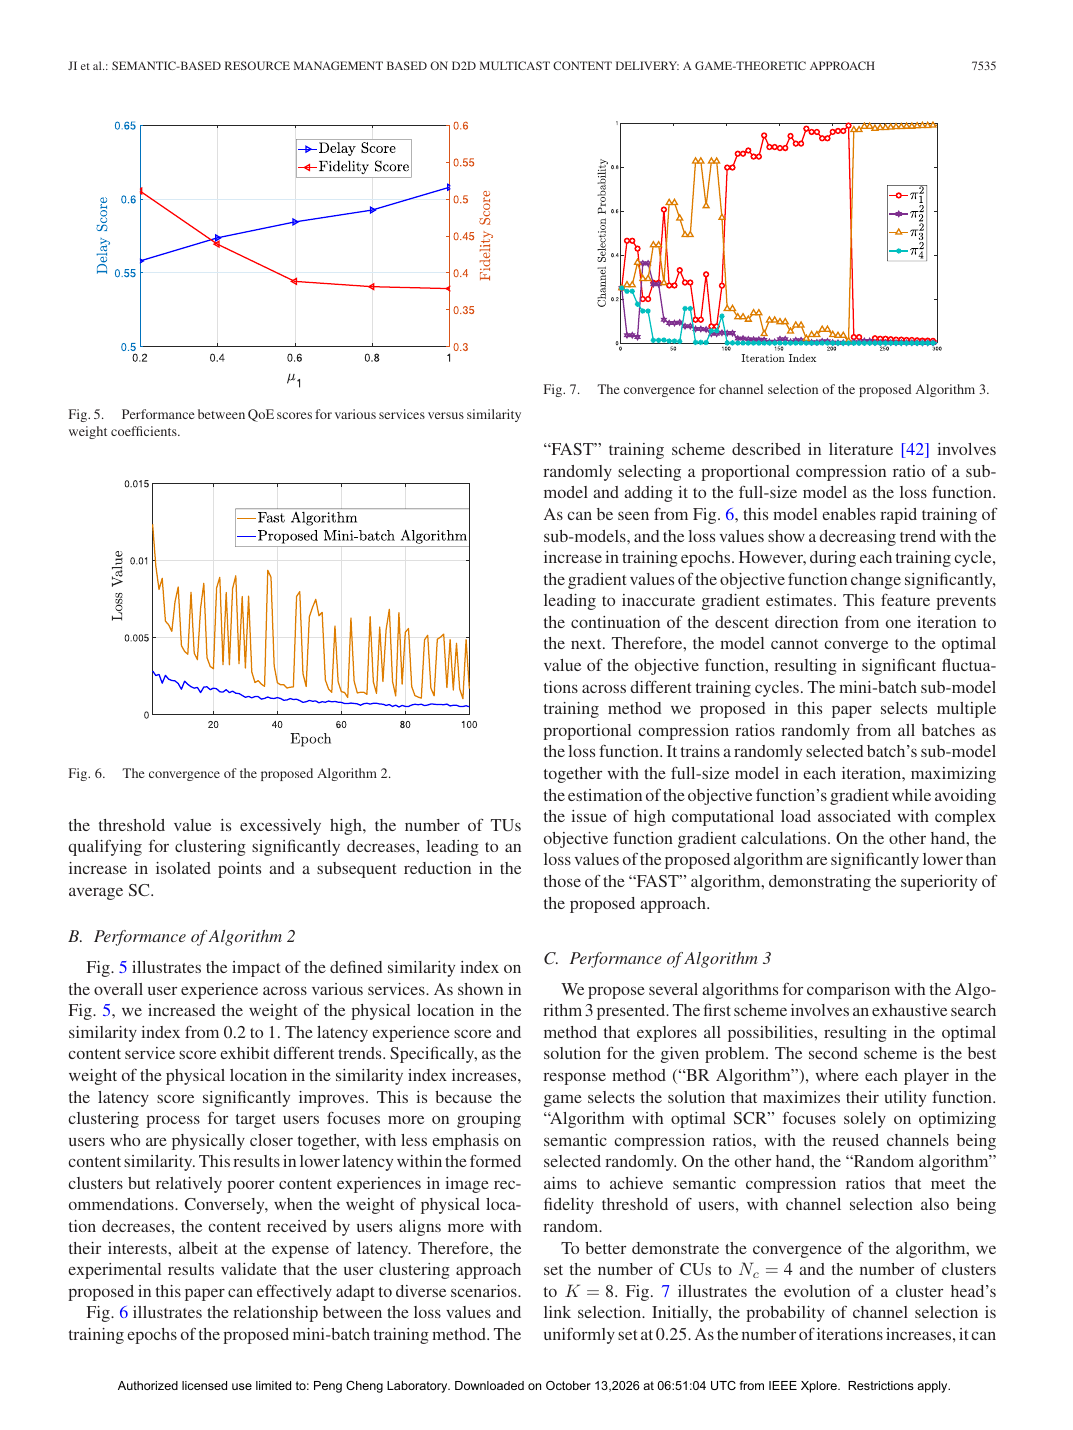
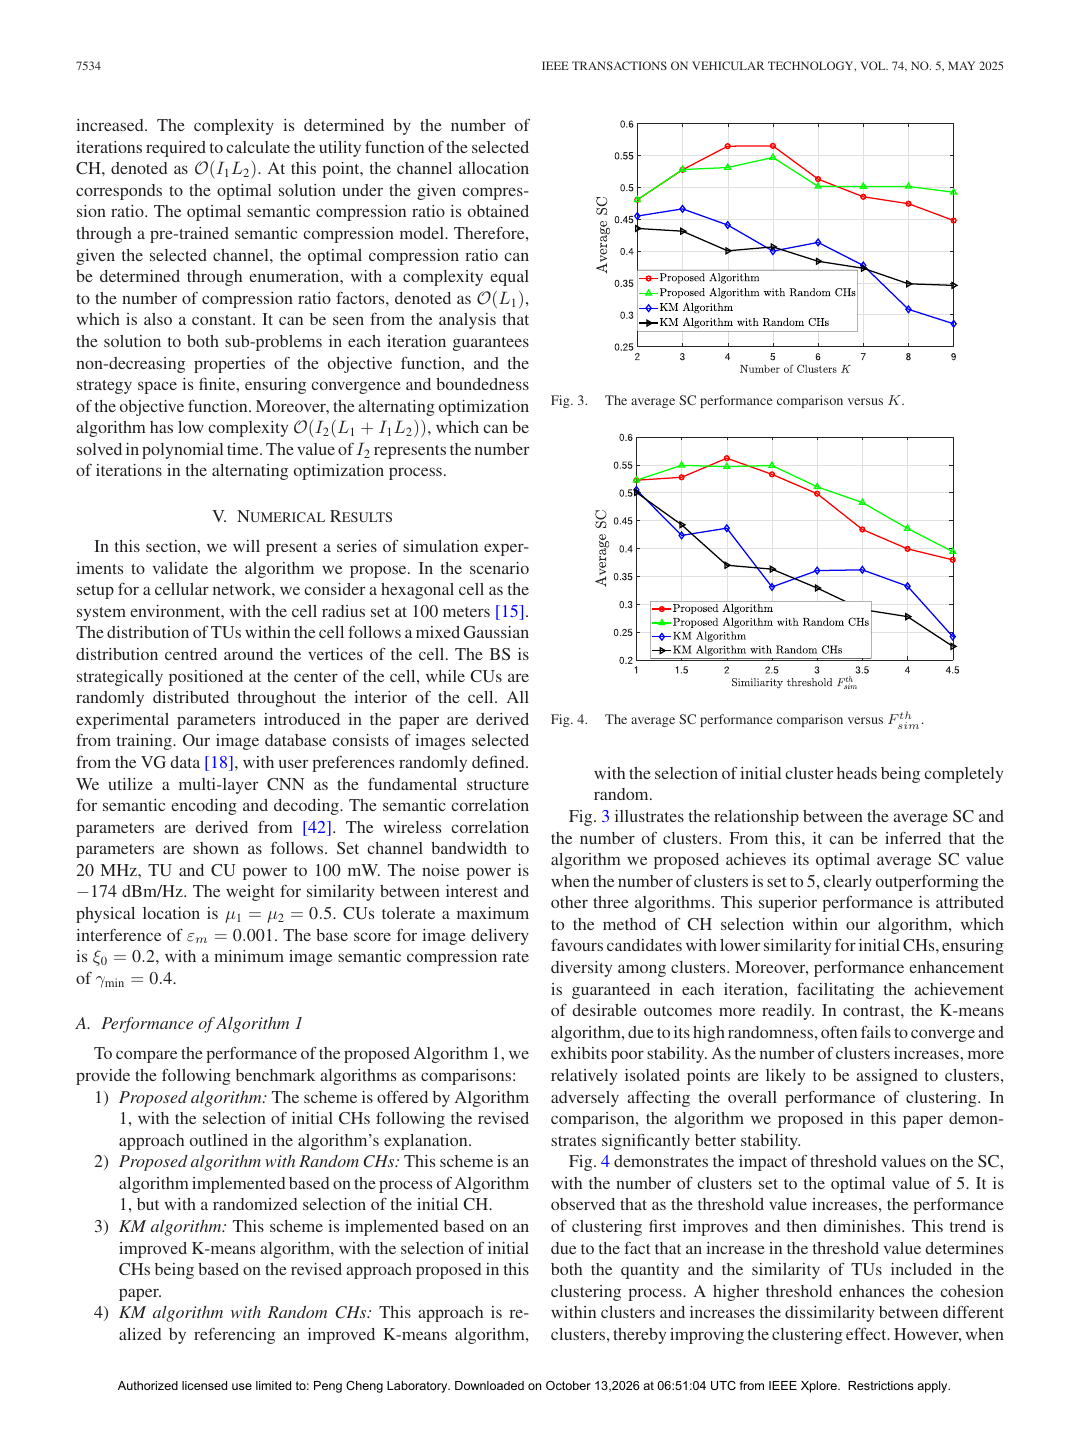
架构/方法图|来源:《Semantic-Based Resource Management Based on D2D Multicast Content Delivery: A Game-Theoretic Approach》,原 PDF p.12,Fig. 7 The convergence for channel selection of the proposed Algorithm 3 核对论文关键实验结果图/表|来源:《Semantic-Based Resource Management Based on D2D Multicast Content Delivery: A Game-Theoretic Approach》,原 PDF p.11,Fig. 3 The average SC performance comparison versus K 核对论文
核心纳入2025语音/音频传输或识别
SemAudio: Semantic Communication for Audio Streaming Transmission
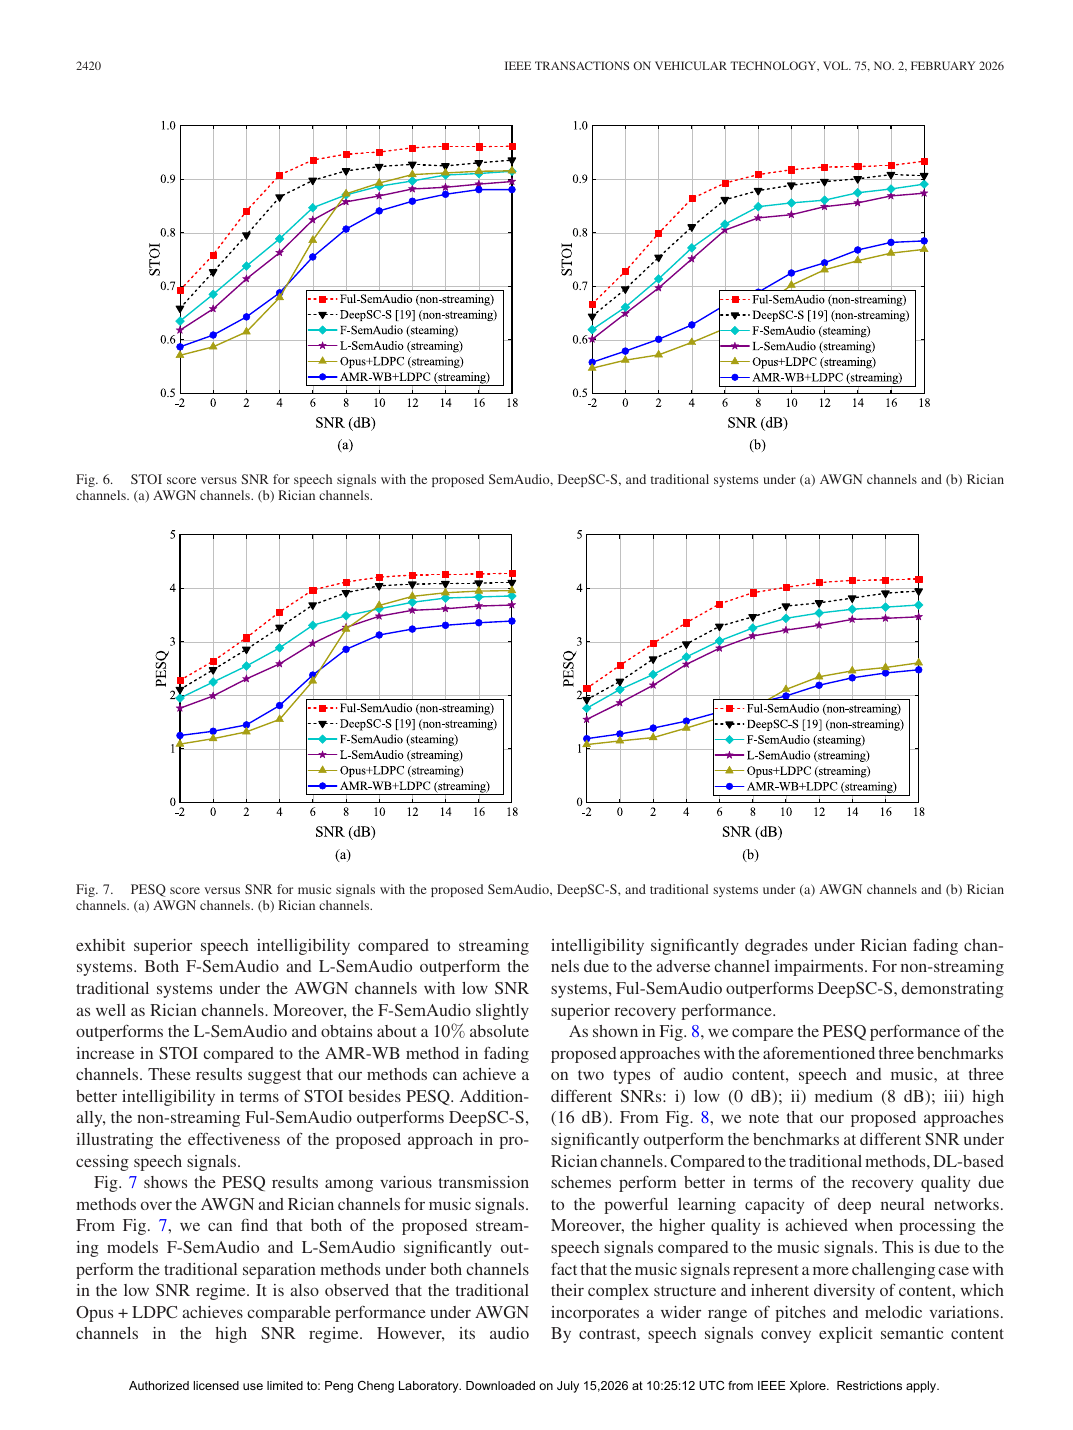
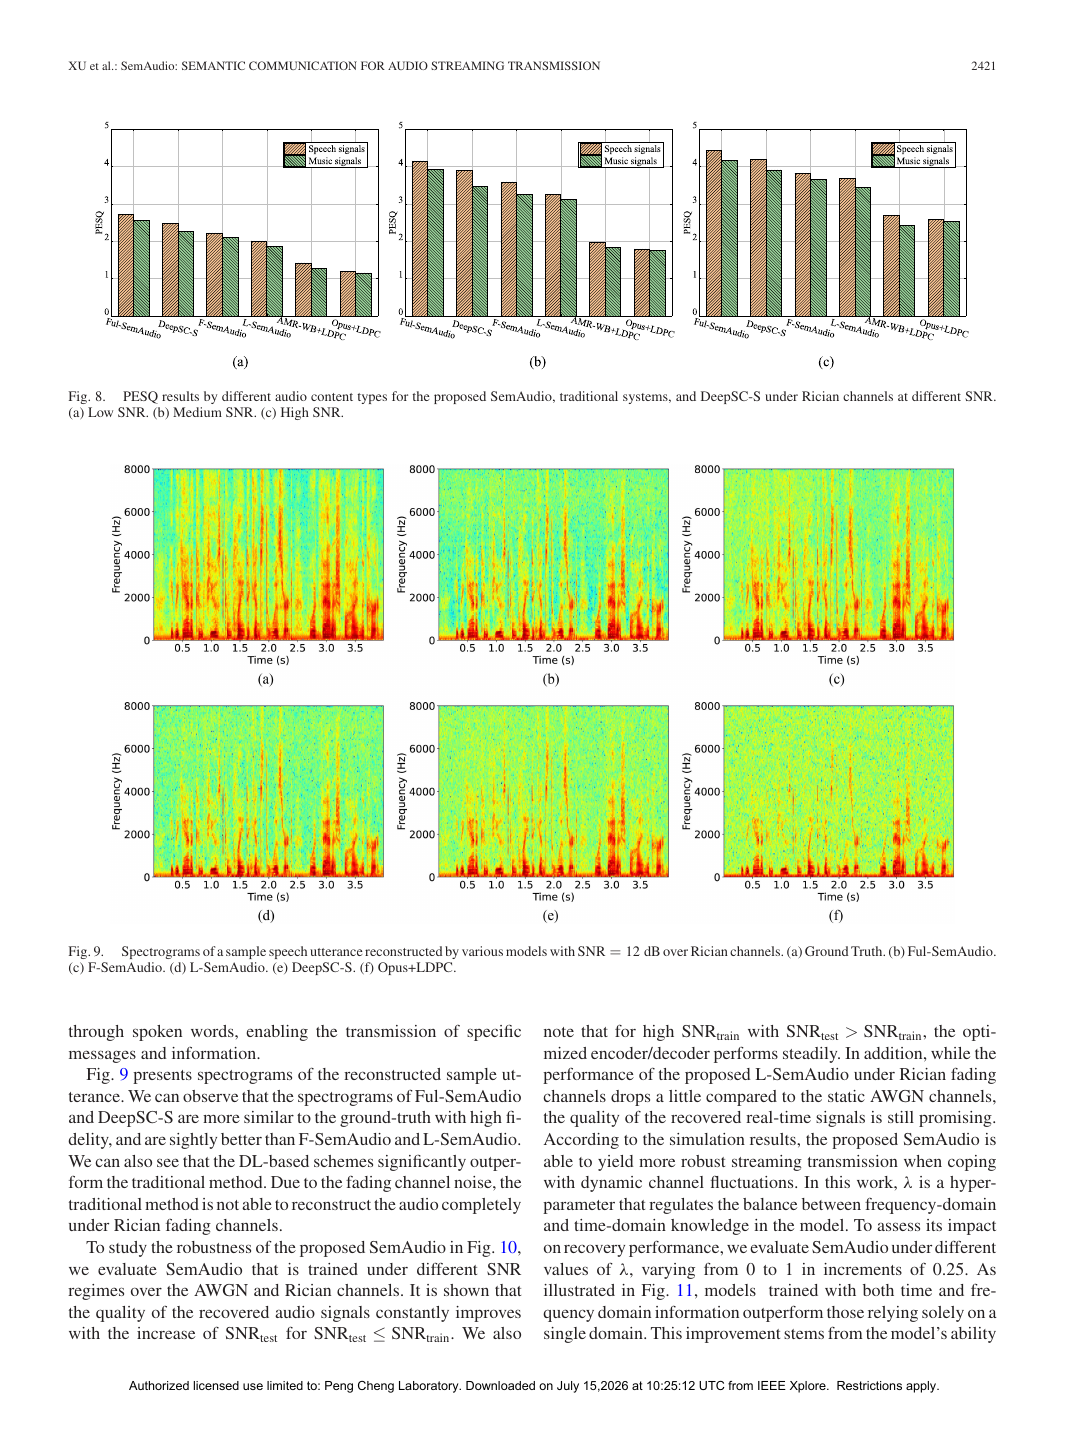
架构/方法图|来源:《SemAudio: Semantic Communication for Audio Streaming Transmission》,原 PDF p.10,Fig. 6 STOI score versus SNR for speech signals with the proposed SemAudio, DeepSC-S, and traditional systems under (a) AWGN channels and (b) Rician channels 核对论文关键实验结果图/表|来源:《SemAudio: Semantic Communication for Audio Streaming Transmission》,原 PDF p.11,Fig. 8 PESQ RESULTS by different audio content types for the proposed SemAudio, traditional systems, and DeepSC-S under Rician channels at different SNR 核对论文
核心纳入2025任务导向推理
Spiking Semantic Communication for Feature Transmission With HARQ
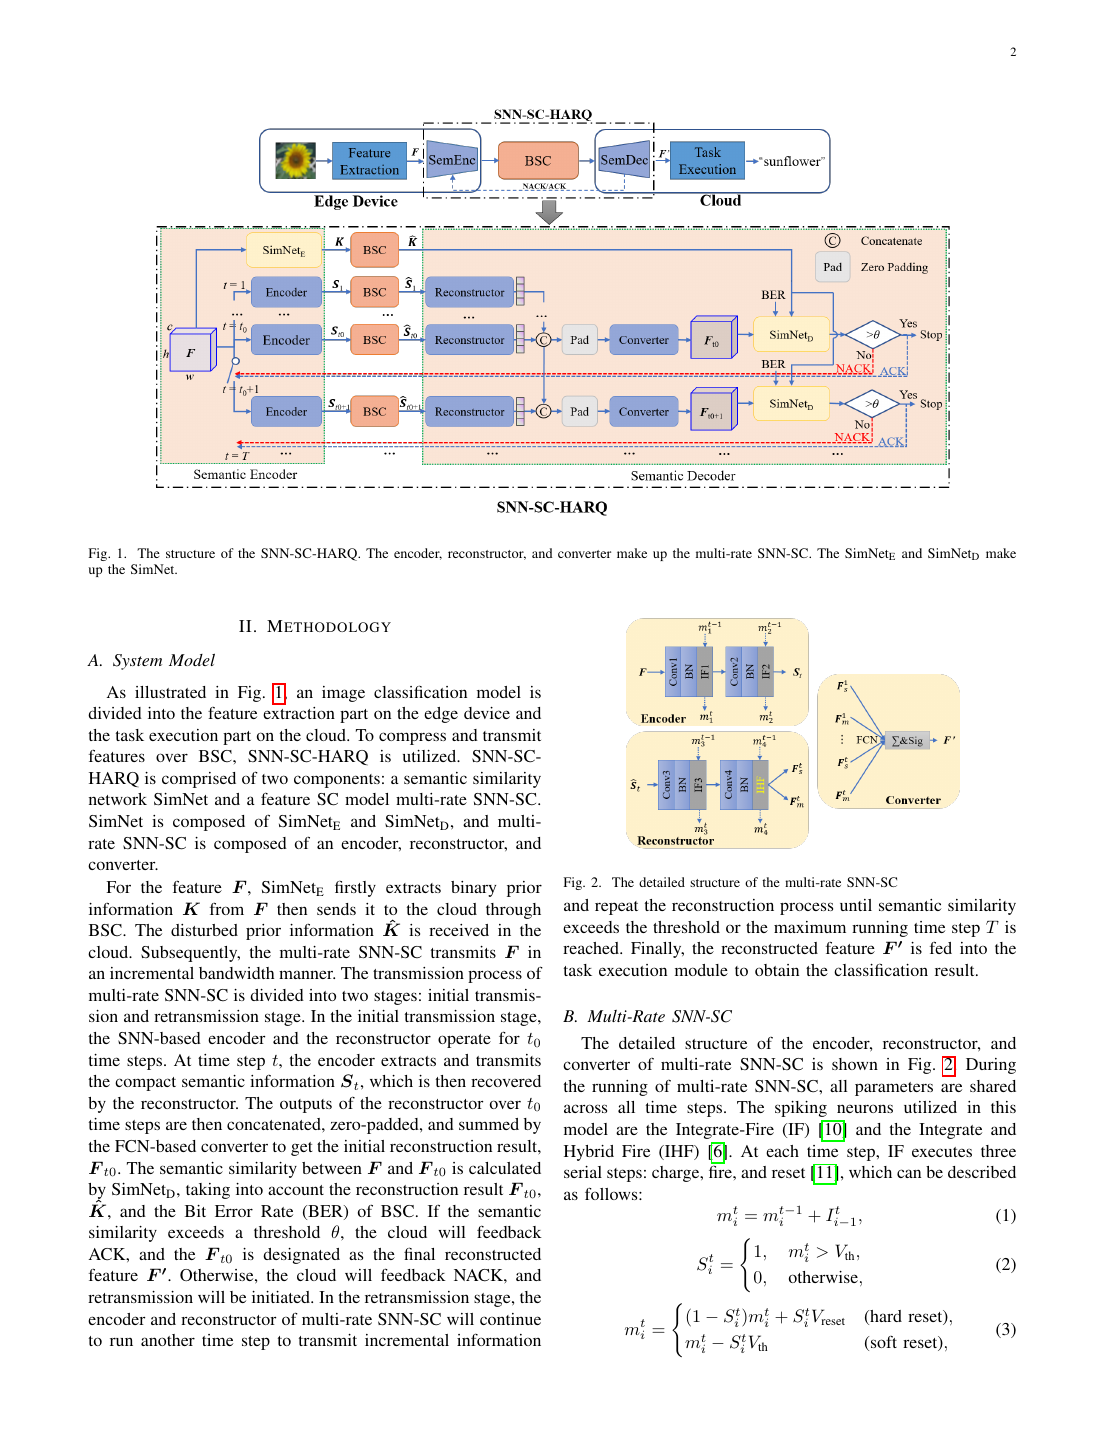
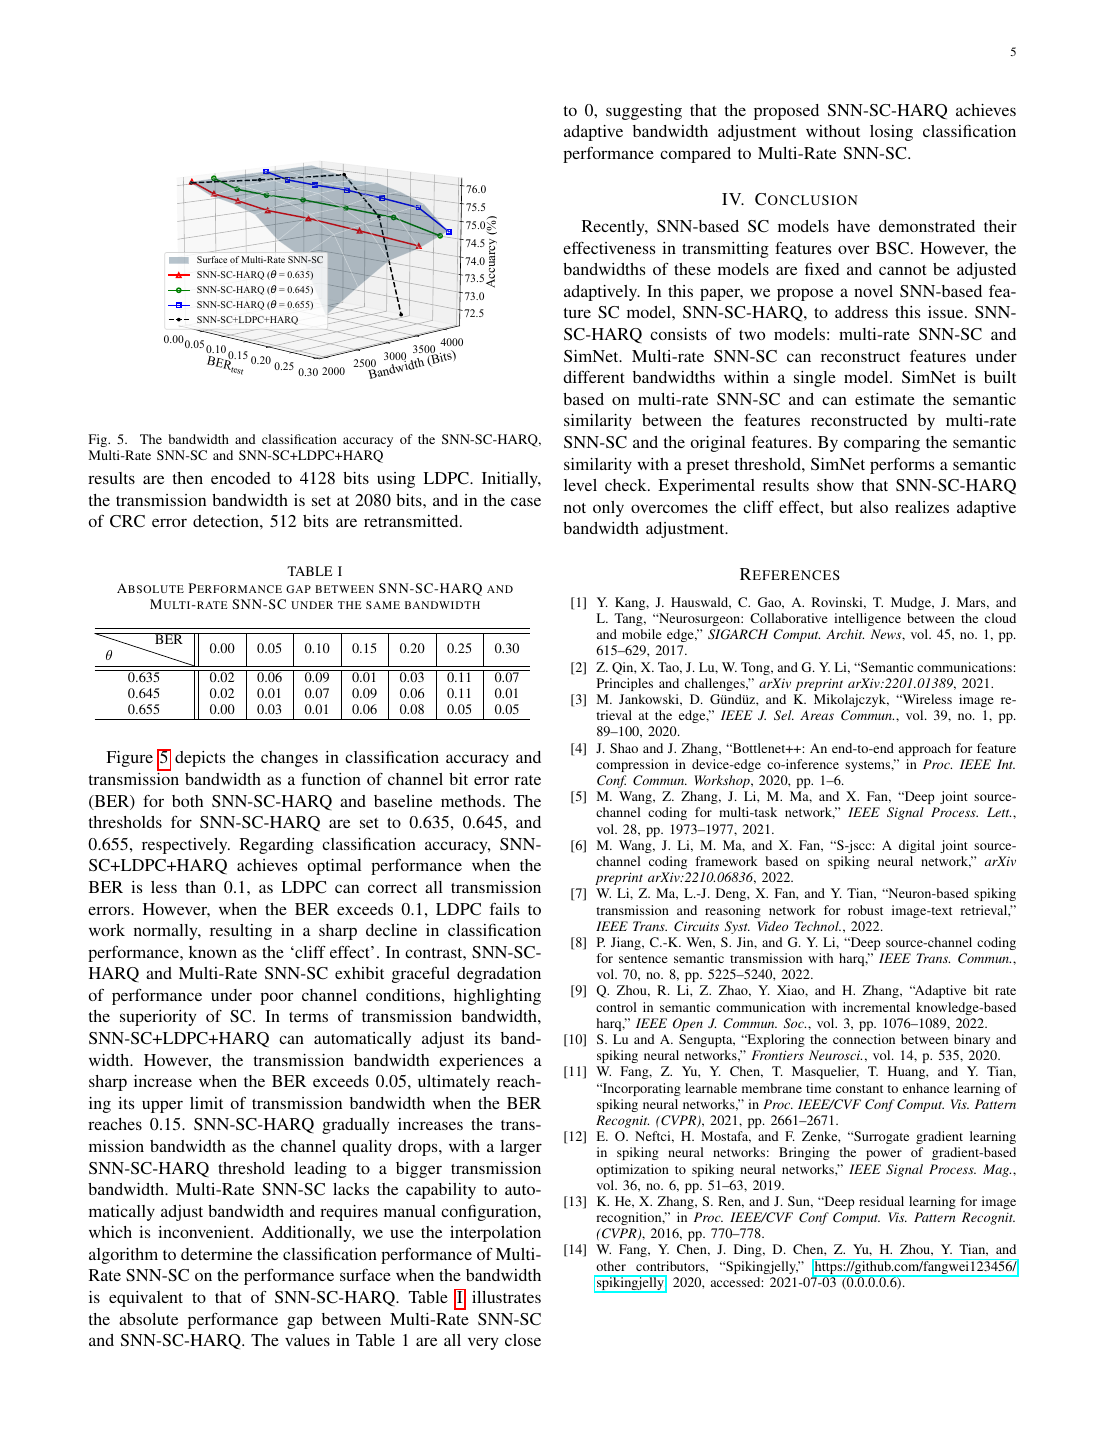
架构/方法图|来源:《Spiking Semantic Communication for Feature Transmission With HARQ》,原 PDF p.2,Fig. 1 The structure of the SNN-SC-HARQ 核对论文关键实验结果图/表|来源:《Spiking Semantic Communication for Feature Transmission With HARQ》,原 PDF p.5,Fig. 5 The bandwidth and classification accuracy of the SNN-SC-HARQ, Multi-Rate SNN-SC and SNN-SC+LDPC+HARQ RESULTS are then encoded to 4128 bits using LDPC 核对论文
核心纳入2025任务导向推理
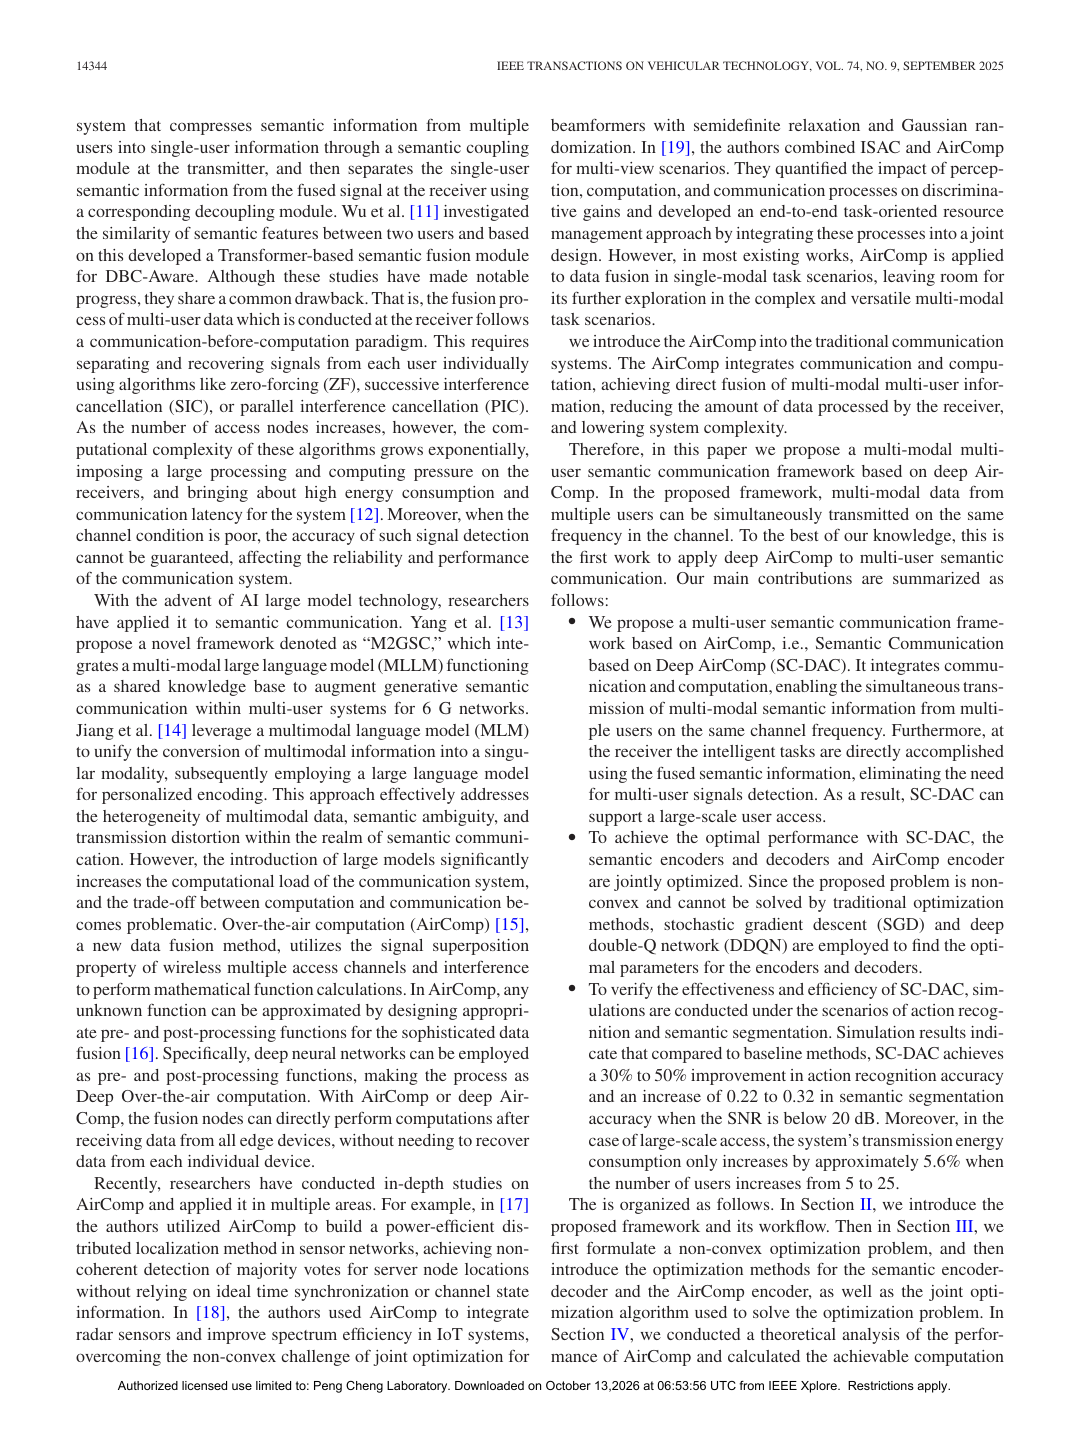
Task-Oriented Multi-User Semantic Communication Based on Deep Over-the-Air Computation
现有进展:另一方面,人工智能(AI)技术的快速发展使得物联网应用朝着更加智能、高效和个性化的方向发展。W接收日期:2024年6月9日;修订日期:2024年11月1日,2025年1月17日,当前版本日期:2025年9月19日。 PDF p.1
仍然存在的问题:为此,本文提出了一种新的基于深度空中计算的多用户语义通信框架--SC-DAC。 PDF p.1
为什么已有方法解决不了:把单用户语义编解码器逐个复制给多个用户,会忽略共享内容、异构信道、干扰和公平性,因而不能直接得到频谱有效的网络方案。 PDF p.1
为什么这个问题重要:边缘设备常需要及时决策而不是完整副本;只发送任务充分信息可以降低时延与带宽,但前提是关键证据确实能穿过信道。 PDF p.1
本文提出什么:为此,本文提出了一种新的基于深度空中计算的多用户语义通信框架--SC-DAC。 PDF p.1
方案为何可能有效:通过深度空中计算(AirComp)编码器集成通信和计算,SC-DAC能够利用多个接入信道的叠加,促进传输期间的多用户信息融合,并消除接收端对多用户检测的需求。 PDF p.1
作者希望证明什么:仿真结果表明,随着用户数的增加,系统的性能保持相对稳定,并显示出潜在的资源利用率。 PDF p.1
方法与端到端信息流
本文提出了一种新的基于深度空中计算的多用户语义通信框架SC-DAC来解决这一挑战。通过深度空中计算(AirComp)编码器将通信和计算集成在一起,SC-DAC能够利用多个接入信道的叠加,便于在传输过程中进行多用户信息融合,并且消除了在接收机处进行多用户检测的需要。然而,在大多数现有的工作中,将AirComp应用于单模态任务场景的数据融合,为复杂多变的多模态任务场景留下了进一步探索的空间。 PDF p.1PDF p.2
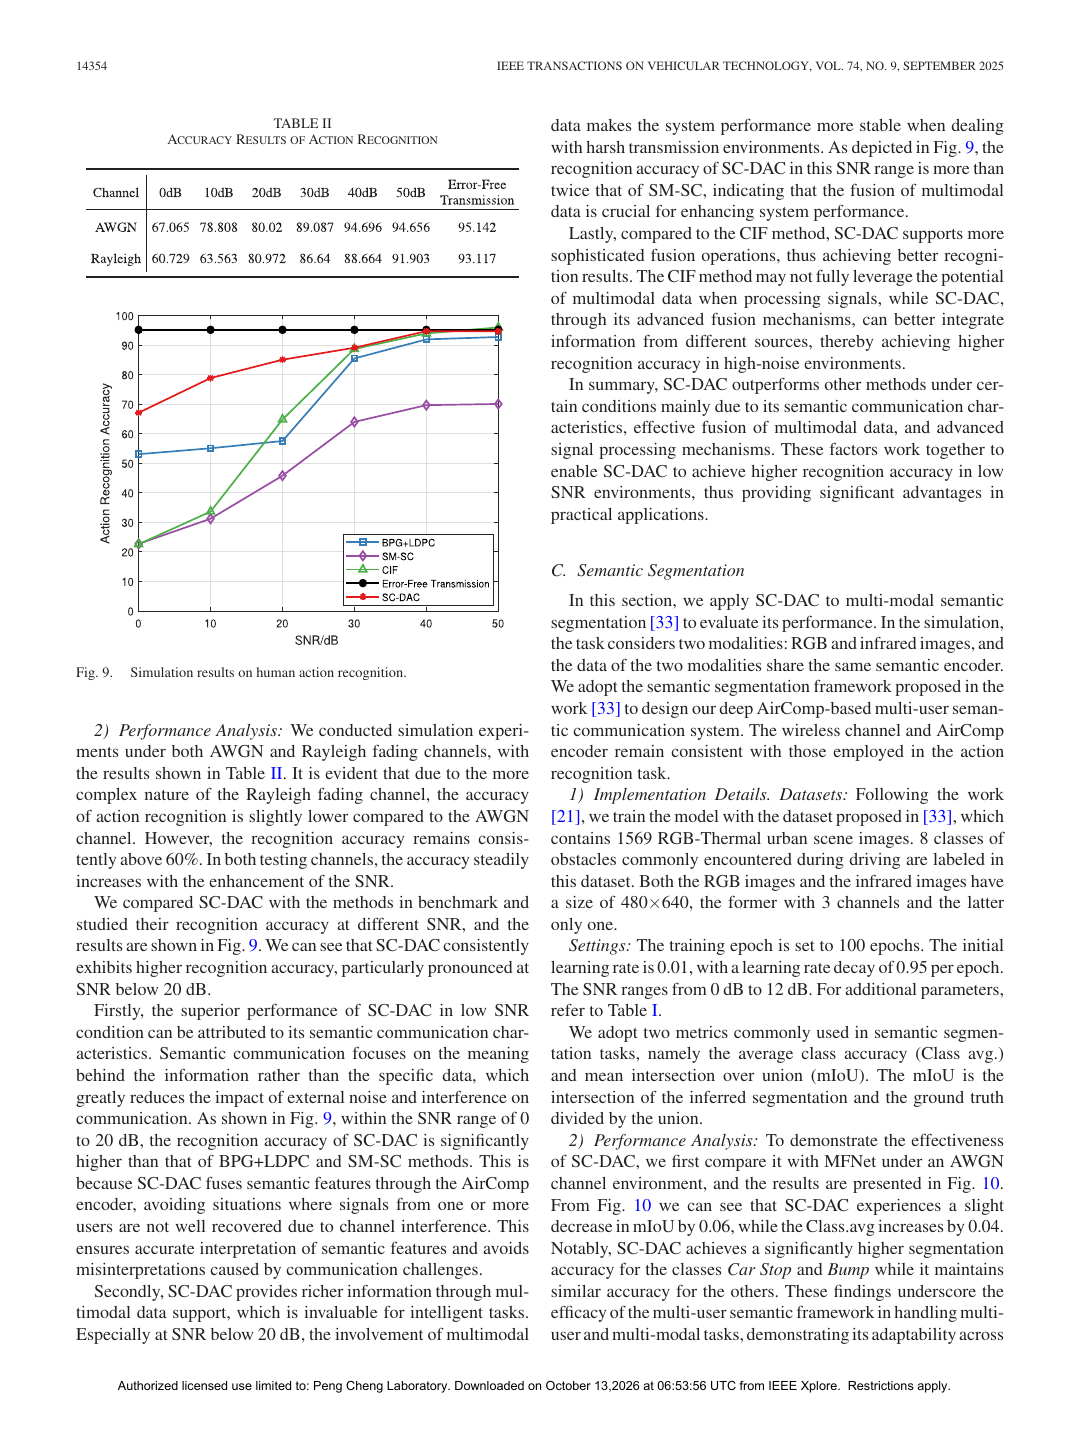
架构/方法图|来源:《Task-Oriented Multi-User Semantic Communication Based on Deep Over-the-Air Computation》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Task-Oriented Multi-User Semantic Communication Based on Deep Over-the-Air Computation》,原 PDF p.12,Fig. 9 SIMULATION RESULTS on human action recognition 核对论文
核心纳入2025图像传输、压缩或生成
Zero-Delay Communications: A Predictive Semantic Communication Scheme Based on PCVAE
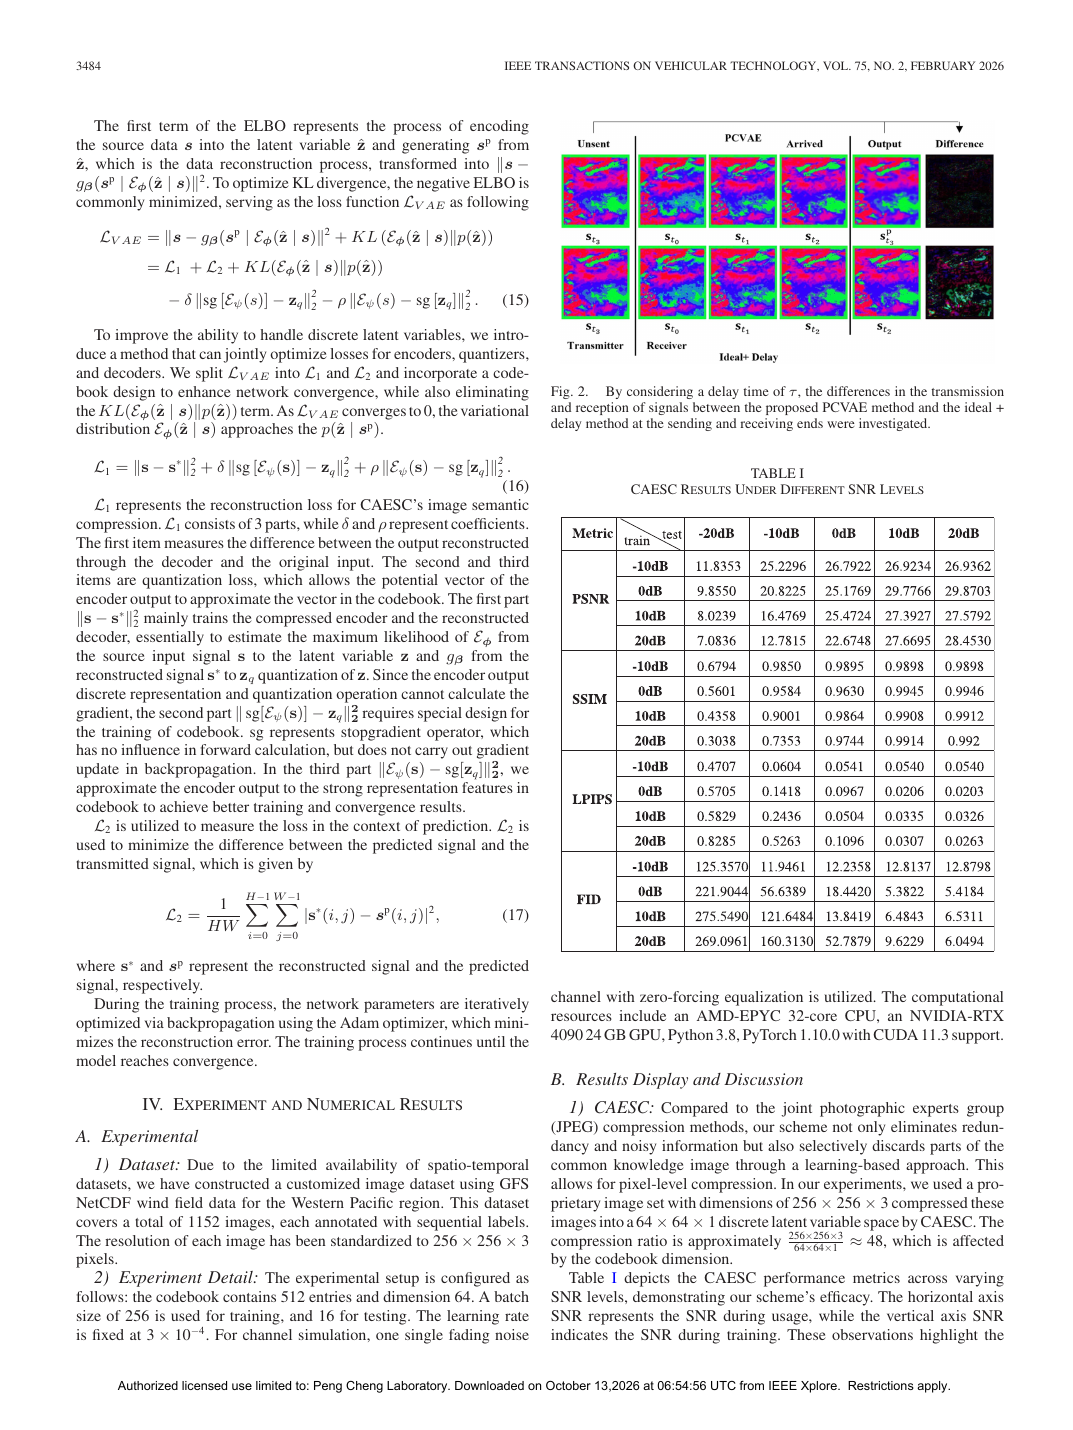
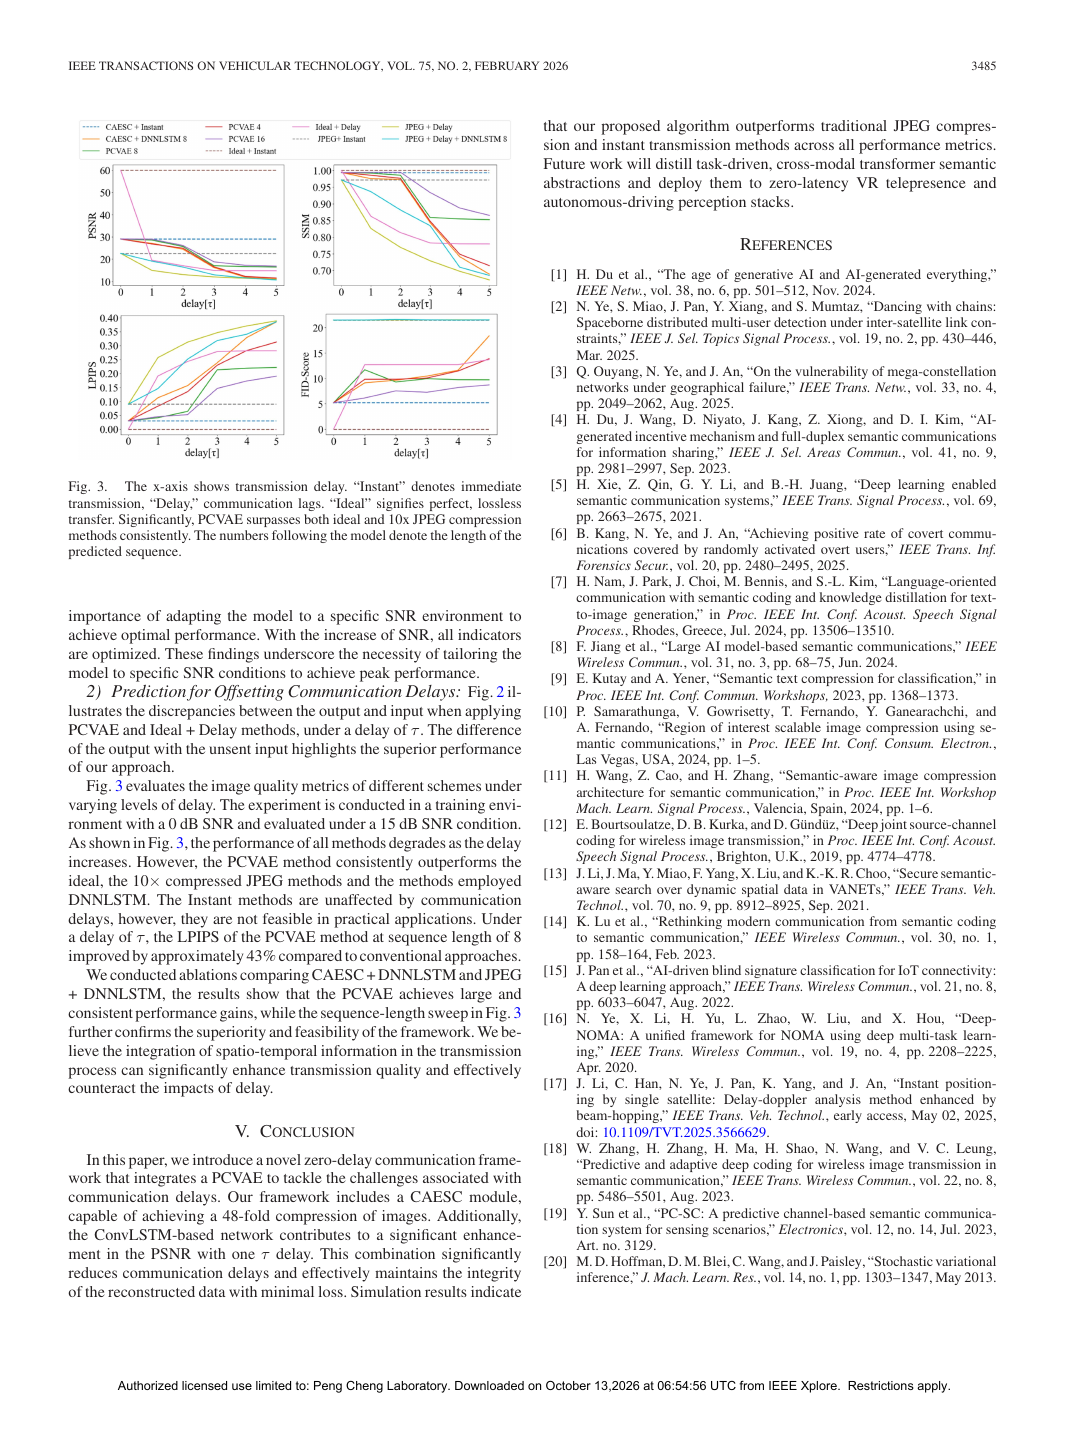
架构/方法图|来源:《Zero-Delay Communications: A Predictive Semantic Communication Scheme Based on PCVAE》,原 PDF p.4,Fig. 2 By considering a delay time of τ , the differences in the transmission and reception of signals between the proposed PCVAE METHOD and the ideal + delay METHOD at the sending and receiving ends were investigated 核对论文关键实验结果图/表|来源:《Zero-Delay Communications: A Predictive Semantic Communication Scheme Based on PCVAE》,原 PDF p.5,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2025多模态检索与任务通信
Zero-Shot Semantic Communication With Multimodal Foundation Models
现有进展:大多数现有的语义通信(SemCom)系统使用深度联合信源信道编码(DeepJSCC)以面向目标的方式编码特定于任务的语义。 PDF p.1
仍然存在的问题:然而,它们对预定义任务和数据集的依赖极大地限制了它们在实际部署中的灵活性和通用性。 PDF p.1
为什么已有方法解决不了:把生成模型放在接收端并不等于通信开销自然降低;仍需明确发送什么条件、条件占多少资源,以及信道破坏条件时怎样约束幻觉和时延。 PDF p.1
为什么这个问题重要:语义质量必须在真实的带宽、功率和时延预算下成立,否则模型收益不能转化为通信系统收益。 PDF p.1
本文提出什么:受此启发,在本文中,我们提出了SemCLIP,这是一个利用对比语言图像预训练(CLIP)模型的零拍摄SemCom框架。 PDF p.1
方案为何可能有效:具体来说,我们提出了一个DeepJSCC方案,用于高效的CLIP令牌编码。 PDF p.1
作者希望证明什么:仿真结果表明,SemCLIP优于基线,在低信噪比下零拍性能提高了41%。 PDF p.1
方法与端到端信息流
受此启发,在本文中,我们提出了SemCLIP,一个利用对比语言图像预训练(CLIP)模型的零触发SemCom框架。具体来说,我们提出了一个用于高效CLIP令牌编码的DeepJSCC方案。为了解决这些挑战并开发零触发SemCom框架,我们提出了SemCLIP,一个基于CLIP模型的SemCom方案。 PDF p.1PDF p.2
架构/方法图|来源:《Zero-Shot Semantic Communication With Multimodal Foundation Models》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Zero-Shot Semantic Communication With Multimodal Foundation Models》,原 PDF p.7,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2026语义感知资源分配与网络优化
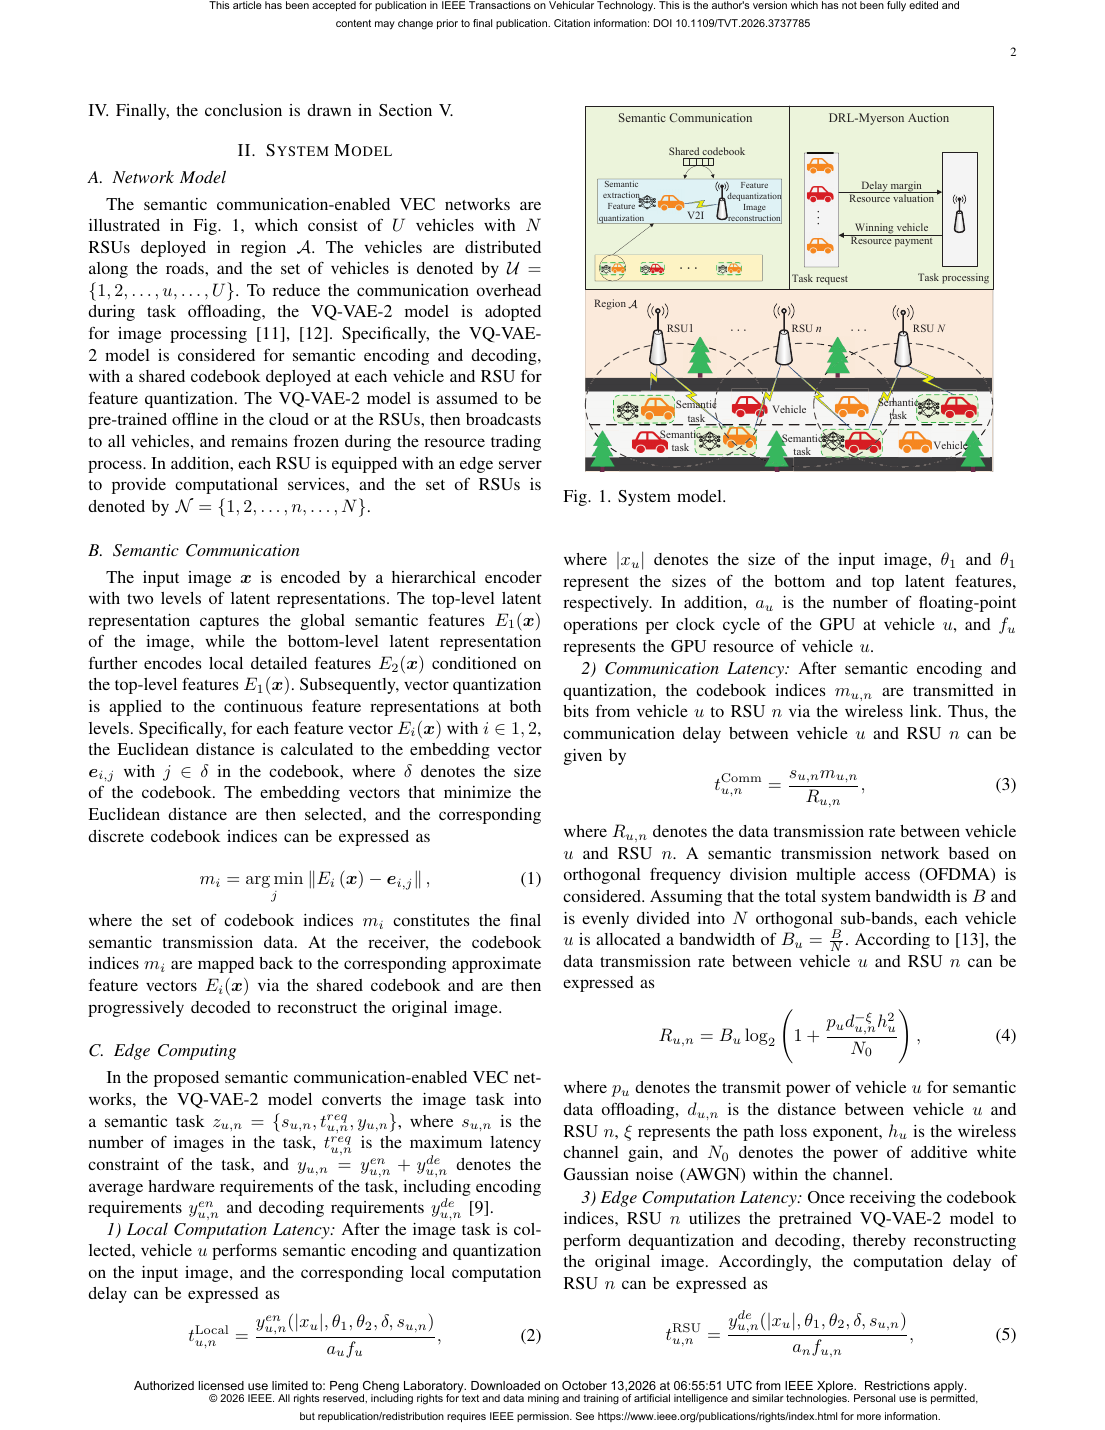
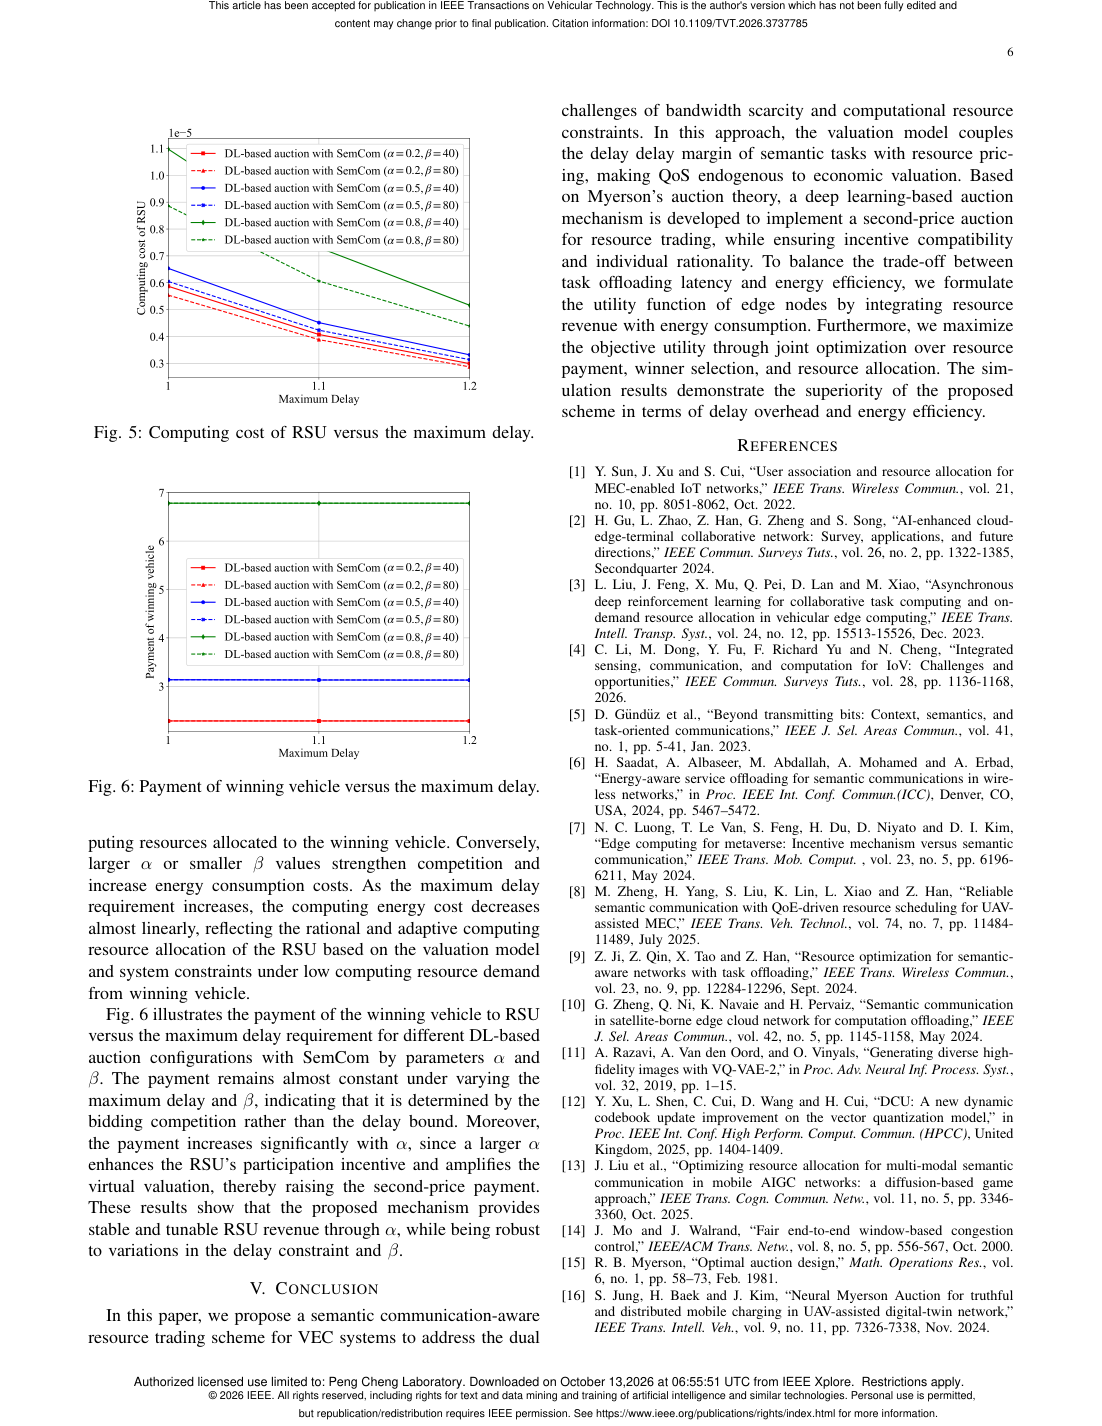
A Deep Learning-Based Myerson Auction for Semantic Communications in Vehicular Edge Computing Networks
架构/方法图|来源:《A Deep Learning-Based Myerson Auction for Semantic Communications in Vehicular Edge Computing Networks》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《A Deep Learning-Based Myerson Auction for Semantic Communications in Vehicular Edge Computing Networks》,原 PDF p.28,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2026语义感知资源分配与网络优化
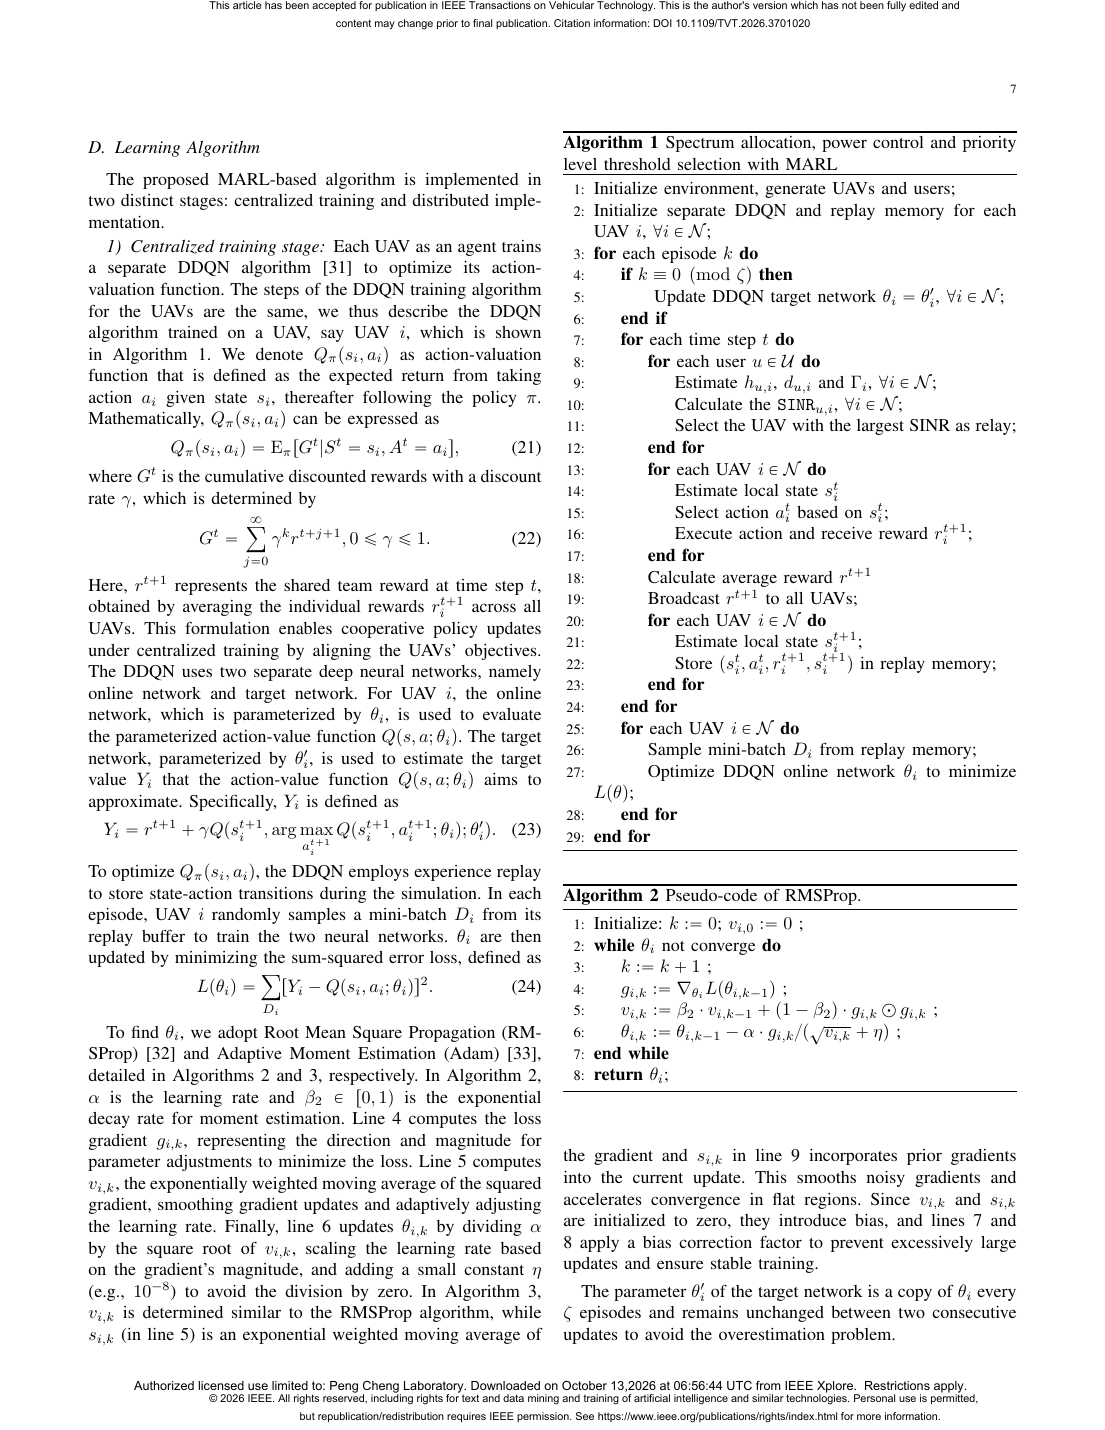
Adaptive Resource Allocation and Semantic Priority Control for Multi-UAV-Aided Relaying Systems
现有进展:本文研究了一种支持语义通信(SemCom)的多无人机(UAV)辅助中继系统,该系统工作在多时隙框架内,每个时隙包括两个不同的阶段。 PDF p.1
仍然存在的问题:虽然可以使用信号与干扰加噪声比(SINR)度量来有效地管理用户关联,但是由于可用信道的有限数量以及用户数据和语义三元组的异构性质和变化的优先级,在第二阶段中的数据传输遇到了重大挑战。 PDF p.1
为什么已有方法解决不了:只按 bit rate、吞吐量或平均失真分配资源,无法区分不同样本和任务的语义价值;外层优化必须得到可用的语义效用—资源曲线。 PDF p.1
为什么这个问题重要:功率、带宽、算力和时延是共享资源;若调度器不知道语义效用,它可能增加吞吐量却没有改善任何用户真正关心的任务。 PDF p.1
本文提出什么:针对这一问题,提出了一种计算复杂度较低的多智能体强化学习(MARL)算法。 PDF p.1
方案为何可能有效:为了解决这一问题,我们提出了一个优化问题,旨在联合优化信道关联、发射功率和UAV三元组选择的优先级阈值。 PDF p.1
作者希望证明什么:值得注意的是,以系统为中心的模式和增强的UAV协调性明显优于以用户为中心的方法。 PDF p.1
方法与端到端信息流
为了解决这一问题,本文提出了一种计算复杂度较低的多智能体强化学习(MARL)算法。为了解决这一问题,我们提出了一个优化问题,旨在联合优化信道关联、发射功率和无人机三元组选择的优先级阈值。激励和贡献在现有工作的激励下,我们研究了一个多无人机辅助中继系统,其中无人机充当空中中继,将多个地面用户的数据转发到远程BS。 PDF p.1PDF p.2
架构/方法图|来源:《Adaptive Resource Allocation and Semantic Priority Control for Multi-UAV-Aided Relaying Systems》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Adaptive Resource Allocation and Semantic Priority Control for Multi-UAV-Aided Relaying Systems》,原 PDF p.7,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2026语义感知资源分配与网络优化
Adaptive Semantic Communication for UAV/UGV Cooperative Path Planning
现有进展:有效的路径规划是无人机(UAV)和无人地面车辆(UGV)系统协调的基础,特别是在监视、导航和应急响应等应用中。 PDF p.1
仍然存在的问题:然而,在这种复杂环境下,由于严重的干扰和非视距条件,无线通信往往不稳定,难以为UAV-UGV协同提供及时、准确的路径规划支持。 PDF p.1
为什么已有方法解决不了:只按 bit rate、吞吐量或平均失真分配资源,无法区分不同样本和任务的语义价值;外层优化必须得到可用的语义效用—资源曲线。 PDF p.1
为什么这个问题重要:功率、带宽、算力和时延是共享资源;若调度器不知道语义效用,它可能增加吞吐量却没有改善任何用户真正关心的任务。 PDF p.1
本文提出什么:为此,提出了一种基于语义通信(SemCom)的无人机/无人地面车协同路径规划框架,以提高不可靠无线环境下的无人机/无人地面车协同路径规划能力。 PDF p.1
方案为何可能有效:提出了一种基于控制感知的无人机/无人地面运载器协同路径规划SemCom框架,并在路径规划关键语义的指导下,以一个动态稀疏收发器为例进行了实例化。 PDF p.2
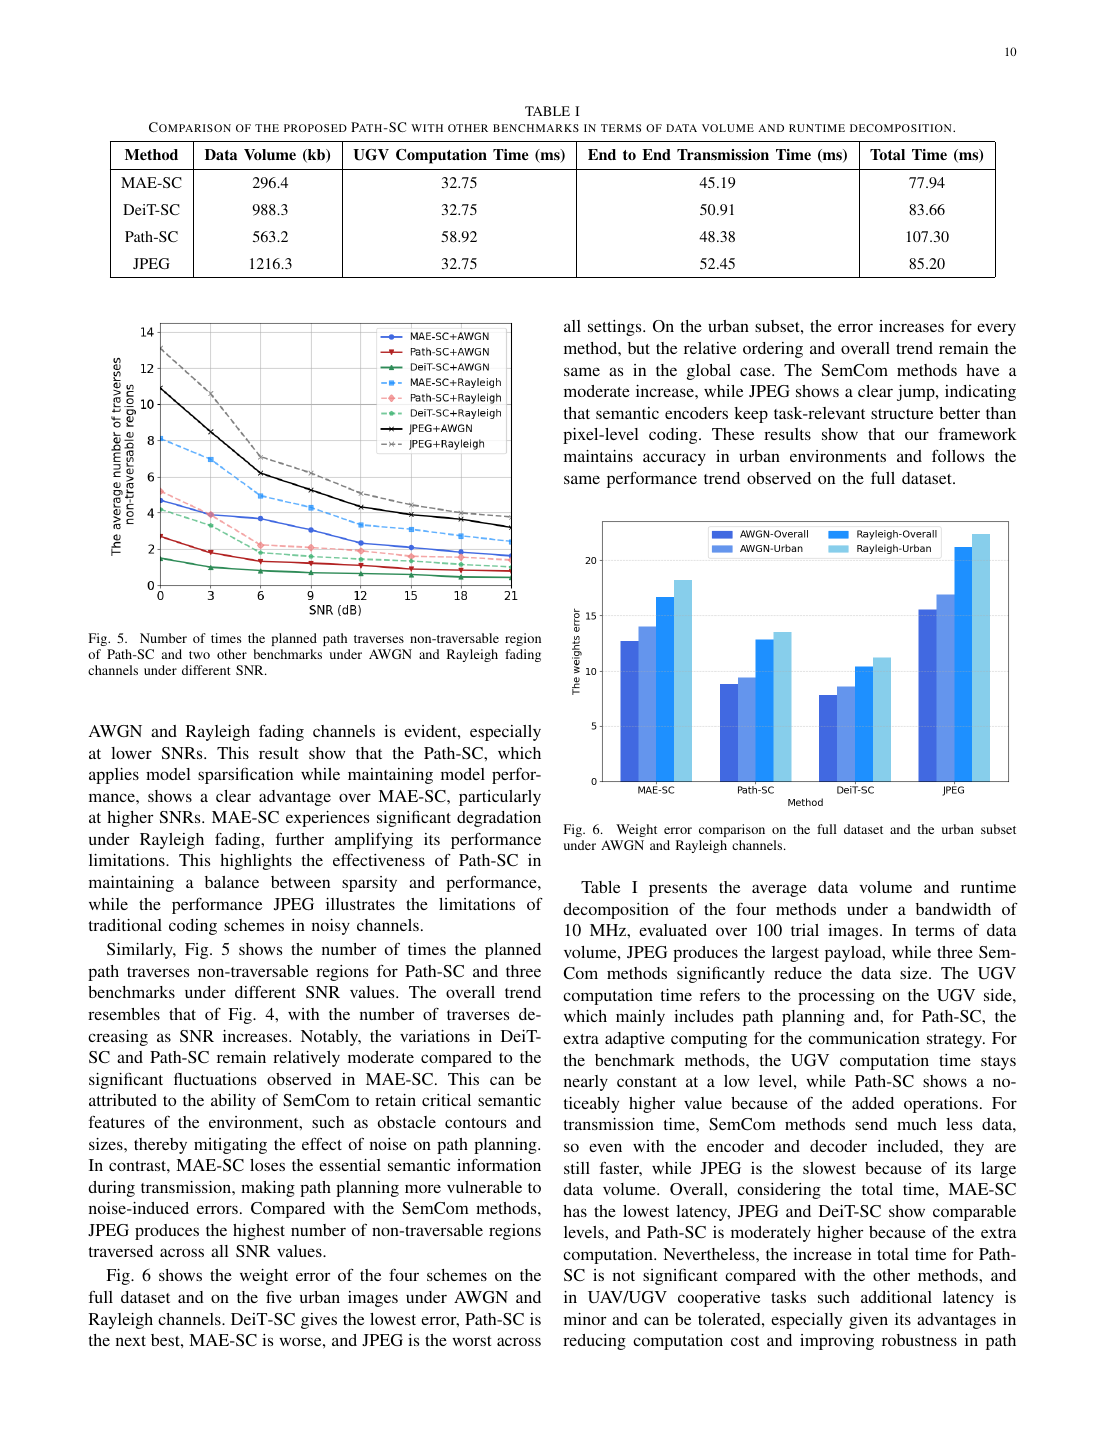
作者希望证明什么:仿真结果表明新设计的SemCom收发器与传统的SemCom收发器相比,在保持路径规划精度的同时,显著降低了数据传输量,提高了系统协作效率。 PDF p.1
方法与端到端信息流
为此,本文提出了一种基于语义通信的无人机/无人地面运载器(UAV/UGV)协同路径规划框架(SemCom),并在路径规划关键语义的指导下,提出了一种控制感知的SemCom协同路径规划框架,通过一个动态稀疏的收发器实现了该框架。有必要开发一种定制的SemCom收发机,这种收发机在UAV/UGV合作中,既要兼顾效率和可靠性,又要注重路径规划的关键语义。 PDF p.1PDF p.2
架构/方法图|来源:《Adaptive Semantic Communication for UAV/UGV Cooperative Path Planning》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Adaptive Semantic Communication for UAV/UGV Cooperative Path Planning》,原 PDF p.10,Fig. 6 Weight error comparison on the full dataset and the urban subset under AWGN and Rayleigh channels 核对论文
核心纳入2026任务导向推理
BidDeepSC-1.58b: 1.58-Bit Bidirectional Slimmable Semantic Communication System
现有进展:其次,当前的支持深度学习的语义通信系统由于其巨大的模型大小和计算复杂度而面临显著的资源约束。 PDF p.1
仍然存在的问题:然而,TW-SC必须在每个端点存储发射机和接收机的权重,与其单向对等物相比,存储要求加倍。 PDF p.2
为什么已有方法解决不了:只按 bit rate、吞吐量或平均失真分配资源,无法区分不同样本和任务的语义价值;外层优化必须得到可用的语义效用—资源曲线。 PDF p.2
为什么这个问题重要:边缘设备常需要及时决策而不是完整副本;只发送任务充分信息可以降低时延与带宽,但前提是关键证据确实能穿过信道。 PDF p.1PDF p.2
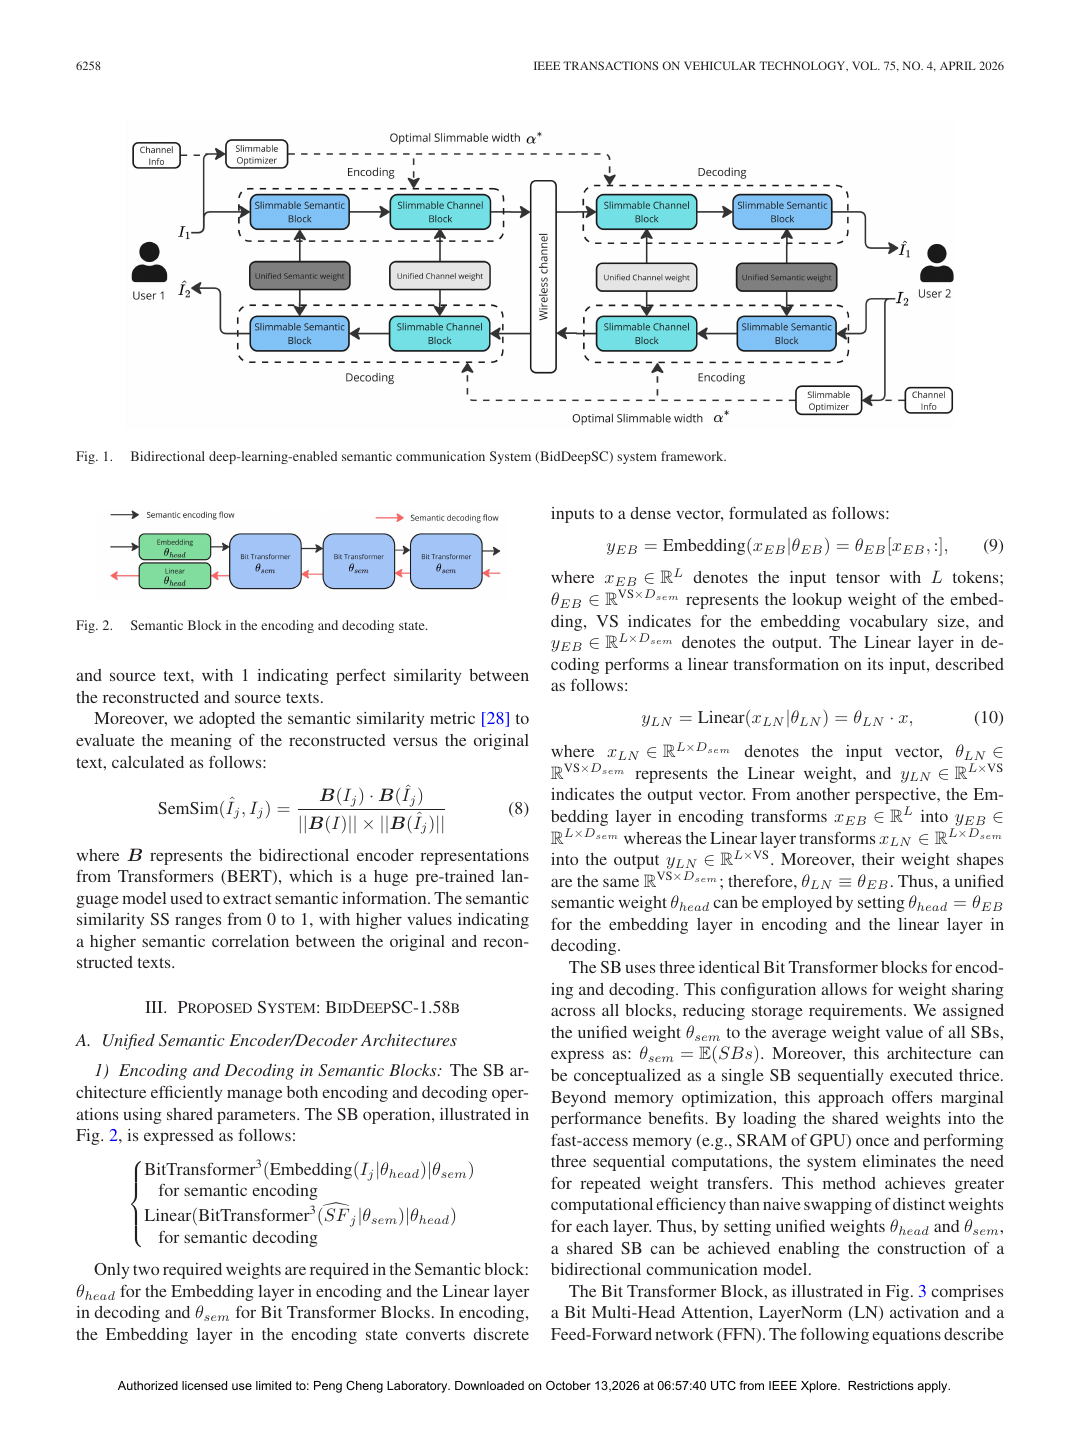
本文提出什么:为了应对这些挑战,我们提出了一种BidDeepSC-1.58b,集成了三项互补的创新:一个统一的编码器-解码器架构,支持双向通信,参数计数减半; 1.58位量化,用于极端模型压缩;以及一个可精简的神经网络,带有智能语义保真度预测器,可动态选择最佳宽度配置。 PDF p.1
方案为何可能有效:在所提出的BidDeepSC框架中,我们为SB和CB应用了一种可精简机制。 PDF p.7
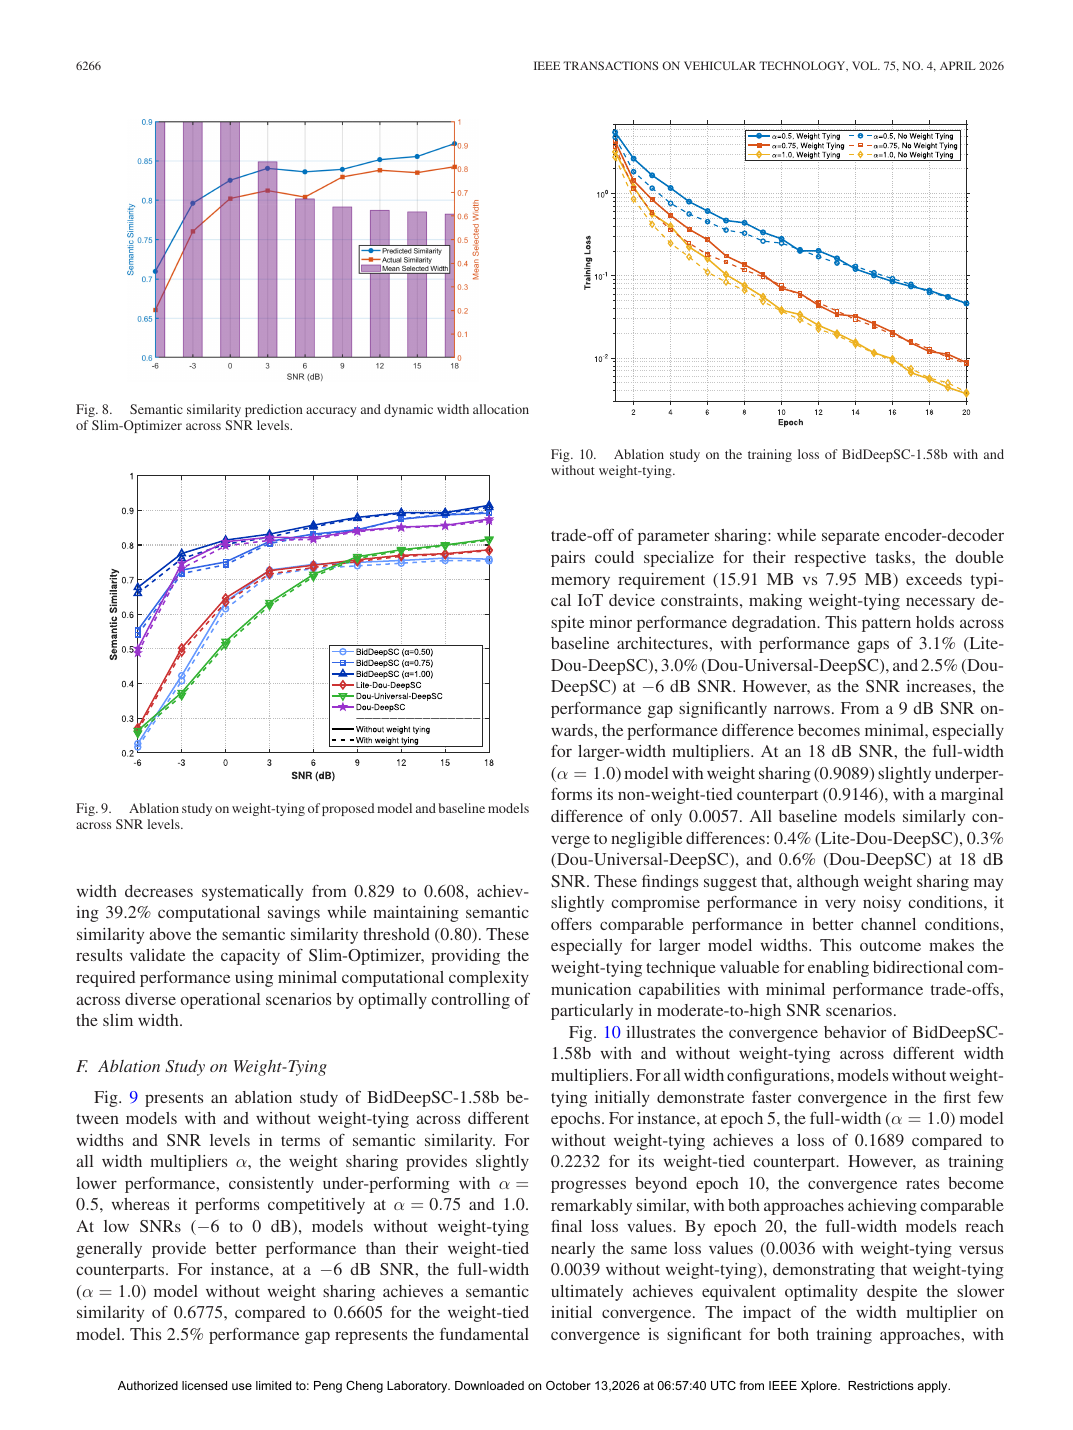
作者希望证明什么:该框架将推理延迟减少了88%,并支持动态宽度适配,在保持语义性能阈值的同时节省了39.2%的计算量。 PDF p.1
方法与端到端信息流
为了解决这些挑战,我们提出了一种BidDeepSC-1.58b,它集成了三种互补的创新:一个统一的编码器-解码器架构,支持双向通信,参数计数减半,用于极端模型压缩的1.58位量化,以及一个可瘦身的神经网络,带有一个智能语义保真度预测器,动态选择最佳宽度配置。在所提出的BidDeepSC框架中,我们对SB和CB都采用了一种可精简的机制。为了解决这种低效的问题,我们提出了一种新的μ-BitLinear推理模式。 PDF p.1PDF p.7
架构/方法图|来源:《BidDeepSC-1.58b: 1.58-Bit Bidirectional Slimmable Semantic Communication System》,原 PDF p.5,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《BidDeepSC-1.58b: 1.58-Bit Bidirectional Slimmable Semantic Communication System》,原 PDF p.13,Fig. 8 Semantic similarity prediction accuracy and dynamic width allocation of Slim-Optimizer across SNR levels 核对论文
相关但非核心2026图像传输、压缩或生成
Channel Assignment for a Polar Code-Based Semantic Communication System
现有进展:语义通信(SemCom)被认为是一种关注语义而非原始数据的高效、鲁棒的信息传输模式。 PDF p.1
仍然存在的问题:如前所述,这种统一的保护无法有效地应用于语义重要性不同的SemCom系统,因为在这些系统中,关键信息的失真会对理解造成不成比例的影响。 PDF p.1
为什么已有方法解决不了:只按 bit rate、吞吐量或平均失真分配资源,无法区分不同样本和任务的语义价值;外层优化必须得到可用的语义效用—资源曲线。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
本文提出什么:提出了一种基于极化码的SemCom信道分配方法。 PDF p.1
方案为何可能有效:然后,基于计算得到的极化信道的语义重要性和可靠性,将极化信道分配问题描述为一个0-1规划问题,并针对不同的传输场景提出了两种分配策略。 PDF p.1
作者希望证明什么:仿真结果表明,与传统的极化信道分配方法相比,该方法通过有效地将语义实体与合适的信道资源进行匹配,提高了语义传输效率和鲁棒性。 PDF p.1
方法与端到端信息流
该文提出了一种基于极化码的SemCom信道分配方法,该方法将信道极化与语义重要性联系起来,然后根据计算出的极化信道的语义重要性和可靠性,将极化信道分配问题描述为一个0-1规划问题,并针对不同的传输场景提出了两种分配策略。文中,提出了一种基于语义重要性的SemCom极化编码信道分配方法。 PDF p.1PDF p.2
输入输入是图像传输、压缩或生成所需的图像及其视觉/任务语义。
发送端发送端采用 Channel Assignment for a Polar Code-Based Semantic Communication System:该文提出了一种基于极化码的SemCom信道分配方法,该方法将信道极化与语义重要性联系起来,然后根据计算出的极化信道的语义重要性和可靠性,将极化信道分配问题描述为一个0-1规划问题,并针对不同的传输场景提出了两种分配策略。文中,提出了一种基于语义重要性的SemCom极化编码信道分配方法。
实际发送实际发送对象是系统模型定义的语义速率、任务效用或信道资源变量。
信道信道作用方式按“类别 5:沿用底层链路或抽象速率—效用模型”解释。
接收端接收端从系统公式假设的接收端输出或语义质量曲线开始,再执行语义解码、任务推理或生成。
输出最终输出为重建/生成图像或视觉任务输出。
它在通信系统中的位置:把语义/任务质量映射为网络效用,再分配功率、带宽、算力或时延。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:上层理论/资源变量;论文不单独定义可发送语义格式
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“上层理论/资源变量;论文不单独定义可发送语义格式”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:Channel Assignment for a Polar Code-Based Semantic Communication System 的主传输单位属于“上层理论/资源变量;论文不单独定义可发送语义格式”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
论文优化的是功率、带宽、时隙、用户调度或语义效用等上层资源变量,并未定义一条可逐 bit 复现的语义 codec。因而这里只报告系统约束和效用曲线,不能从优化变量反推 token/index 总 bit 数。 PDF p.2PDF p.15
仿真结果表明,与传统的极化信道分配方法相比,该方法通过有效地将语义实体与合适的信道资源进行匹配,提高了语义传输效率和鲁棒性,例如,当码率从0.75降低到0.25时,汽车实体的性能得到了133%的提高(从28.27dB到65.84dB),而已经得到良好保护的个人实体显示出更适度的29%的改善(从69.75dB到90.00dB)。 PDF p.1PDF p.23
架构/方法图|来源:《Channel Assignment for a Polar Code-Based Semantic Communication System》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Channel Assignment for a Polar Code-Based Semantic Communication System》,原 PDF p.10,Fig. 6 Average semantic recovery vs channel number (ε=0.5, K/N=0.75), with 95% confidence intervals (CI) 核对论文
核心纳入2026图像传输、压缩或生成
Communicate Less, Synthesize the Rest: Latency-Aware Intent-Based Generative Semantic Multicasting With Diffusion Models
现有进展:最近,生成扩散模型(GDM)在合成具有高感知质量的多媒体信号方面表现出了巨大的成功,使得能够在未来的无线网络中进行高效的语义通信。 PDF p.1
仍然存在的问题:基于预训练的扩散模型,本文结合多播技术,提出了一种基于意图感知的生成式语义多播框架。 PDF p.1
为什么已有方法解决不了:把生成模型放在接收端并不等于通信开销自然降低;仍需明确发送什么条件、条件占多少资源,以及信道破坏条件时怎样约束幻觉和时延。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
本文提出什么:基于预训练的扩散模型,本文结合多播技术,提出了一种基于意图感知的生成式语义多播框架。 PDF p.1
方案为何可能有效:在所提出的框架中,发射机基于多用户意图将源信号分解为多个语义类,即,假设每个用户仅对语义类的子集的细节感兴趣。 PDF p.1
作者希望证明什么:仿真结果表明,与非生成和意图不感知的多播基准相比,在保持用户处检索到的信号的高感知质量的同时,显著降低了每个用户的延迟。 PDF p.1
方法与端到端信息流
该文提出了一种基于多用户意图的语义组播生成框架,该框架利用预先训练好的扩散模型,将源信号分解为多个语义类,即假设每个用户只对语义类的一个子集的细节感兴趣。文中,我们开发了一种可伸缩的感知延迟的生成式语义组播框架,该框架具有利用预先训练的扩散模型的自适应的基于意图的资源分配。 PDF p.1PDF p.2
输入输入是图像传输、压缩或生成所需的图像及其视觉/任务语义。
发送端发送端采用 Communicate Less, Synthesize the Rest: Latency-Aware Intent-Based Generative Semantic Multicasting With Diffusion Models:该文提出了一种基于多用户意图的语义组播生成框架,该框架利用预先训练好的扩散模型,将源信号分解为多个语义类,即假设每个用户只对语义类的一个子集的细节感兴趣。文中,我们开发了一种可伸缩的感知延迟的生成式语义组播框架,该框架具有利用预先训练的扩散模型的自适应的基于意图的资源分配。
实际发送实际发送对象是语义 feature 或未完整规定 bit 映射的 latent。
信道信道作用方式按“类别 0:信道作用点不足,或由外部传统链路抽象承担”解释。
接收端接收端从论文假设已经恢复的语义特征开始,再执行语义解码、任务推理或生成。
输出最终输出为重建/生成图像或视觉任务输出。
它在通信系统中的位置:利用接收端生成先验,把可预测细节从空口发送对象中移除。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:语义 feature/latent;量化到 bitstream 的接口未完整报告
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“语义 feature/latent;量化到 bitstream 的接口未完整报告”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:Communicate Less, Synthesize the Rest: Latency-Aware Intent-Based Generative Semantic Multicasting With Diffusion Models 的主传输单位属于“语义 feature/latent;量化到 bitstream 的接口未完整报告”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
论文未同时报告输入尺寸、encoder 输出尺寸、量化精度/码本大小和帧级开销,因此不能从全文唯一重建总 bit 数。页面保留论文实际使用的 CBR、bpp、token 数或信道使用次数;缺失项不作臆测。 PDF p.2PDF p.7
架构/方法图|来源:《Communicate Less, Synthesize the Rest: Latency-Aware Intent-Based Generative Semantic Multicasting With Diffusion Models》,原 PDF p.12,Fig. 14 Visual quality of the proposed generative semantic multicasting framework for typical street scene 1, where (ε(r) , ε(s) ) = (0.02850, 0.58705), kl k T ∗ = 12.824 ms, λ∗ = 6.0689 核对论文关键实验结果图/表|来源:《Communicate Less, Synthesize the Rest: Latency-Aware Intent-Based Generative Semantic Multicasting With Diffusion Models》,原 PDF p.14,Fig. 18 Visual quality comparisons for Diffusion vs 核对论文
核心纳入2026语义感知资源分配与网络优化
Design and Demonstration of a Visible Light Based Semantic Communication System
现有进展:可见光通信(VLC)是未来网络中满足高业务需求的关键技术,而发光二极管(LED)固有的有限调制带宽要求必须采用创新的方法来提高数据吞吐量。 PDF p.1
仍然存在的问题:然而,尽管有这些优势,VLC在实际部署中面临着一个关键瓶颈:商用LED的调制带宽非常有限,这严重制约了它们的数据速率和系统性能。 PDF p.1
为什么已有方法解决不了:连续 latent 或独立设计的传统链路没有回答语义特征怎样量化、映射为有限符号,以及 bit/index 出错后为何不会跳到完全不同的语义。仅改进信源网络无法补上这一接口。 PDF p.1
为什么这个问题重要:功率、带宽、算力和时延是共享资源;若调度器不知道语义效用,它可能增加吞吐量却没有改善任何用户真正关心的任务。 PDF p.1
本文提出什么:语义通信(SemCom)侧重于传递数据的意义而不是原始比特,是解决VLC中这一瓶颈的理想候选方案。 PDF p.1
方案为何可能有效:首先,我们针对VLC环境定制了我们的系统设计,引入了一组与照明和有限LED带宽相关的物理层约束。 PDF p.2
作者希望证明什么:最后,搭建了一个初步的硬件演示平台,在真实的的VLC链路上实现了SemCom的功率分配策略。 PDF p.1
方法与端到端信息流
SemCom(Semantic communication)是克服VLC中这一瓶颈的最佳选择。SemCom专注于传输数据的含义,而不是原始比特。首先,我们专门针对VLC环境定制了我们的系统设计,引入了一组与照明和有限的LED带宽相关的物理层约束。引入了与照明和有限的LED带宽相关的一组物理层约束。 PDF p.1PDF p.2
输入输入是语义感知资源分配与网络优化所需的用户、任务、信道和资源状态。
发送端发送端采用 Design and Demonstration of a Visible Light Based Semantic Communication System:SemCom(Semantic communication)是克服VLC中这一瓶颈的最佳选择。SemCom专注于传输数据的含义,而不是原始比特。首先,我们专门针对VLC环境定制了我们的系统设计,引入了一组与照明和有限的LED带宽相关的物理层约束。引入了与照明和有限的LED带宽相关的一组物理层约束。
语义信道容量建模经典的香农容量表示信道的数据速率极限(以比特每秒为单位,bit/s)。叠加信号被量化为离散的强度级别,并作为PWM信号序列传输。 表示判定:Design and Demonstration of a Visible Light Based Semantic Communication System 的主传输单位属于“有限星座/标准数字波形接口”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.4PDF p.7
论文未同时报告输入尺寸、encoder 输出尺寸、量化精度/码本大小和帧级开销,因此不能从全文唯一重建总 bit 数。页面保留论文实际使用的 CBR、bpp、token 数或信道使用次数;缺失项不作臆测。 PDF p.2PDF p.19
最后,我们搭建了一个初步的硬件演示平台,在真实的VLC链路上实现了所提出的功率分配策略,从而降低了分配给U2的功率,因此(a)显示U2接收U2接收U2恢复U1接收21.37 dB 24.42 dB 24.66 dB 26.54 dB 31.68 dB 28.01 dB 0.3658 0.5203 0.6255 0.6871 0.8528 0.6955 0.4460 0.2834 0.1432 0.1115 0.0588 0.1753含噪声的初始信号。 PDF p.1PDF p.24
架构/方法图|来源:《Design and Demonstration of a Visible Light Based Semantic Communication System》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Design and Demonstration of a Visible Light Based Semantic Communication System》,原 PDF p.19,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2026语义感知资源分配与网络优化
Design of Multi-UAV Cooperative Deep Semantic Autoencoders for Communication Networks
现有进展:多用户语义通信的研究表明,用户间的协作可以通过促进信息交互来提高任务的执行效率。 PDF p.1
仍然存在的问题:然而,在带宽受限的场景下,无人机网络在任务执行效率和智能处理能力方面仍面临重大挑战。 PDF p.1
为什么已有方法解决不了:只按 bit rate、吞吐量或平均失真分配资源,无法区分不同样本和任务的语义价值;外层优化必须得到可用的语义效用—资源曲线。 PDF p.1
为什么这个问题重要:功率、带宽、算力和时延是共享资源;若调度器不知道语义效用,它可能增加吞吐量却没有改善任何用户真正关心的任务。 PDF p.1
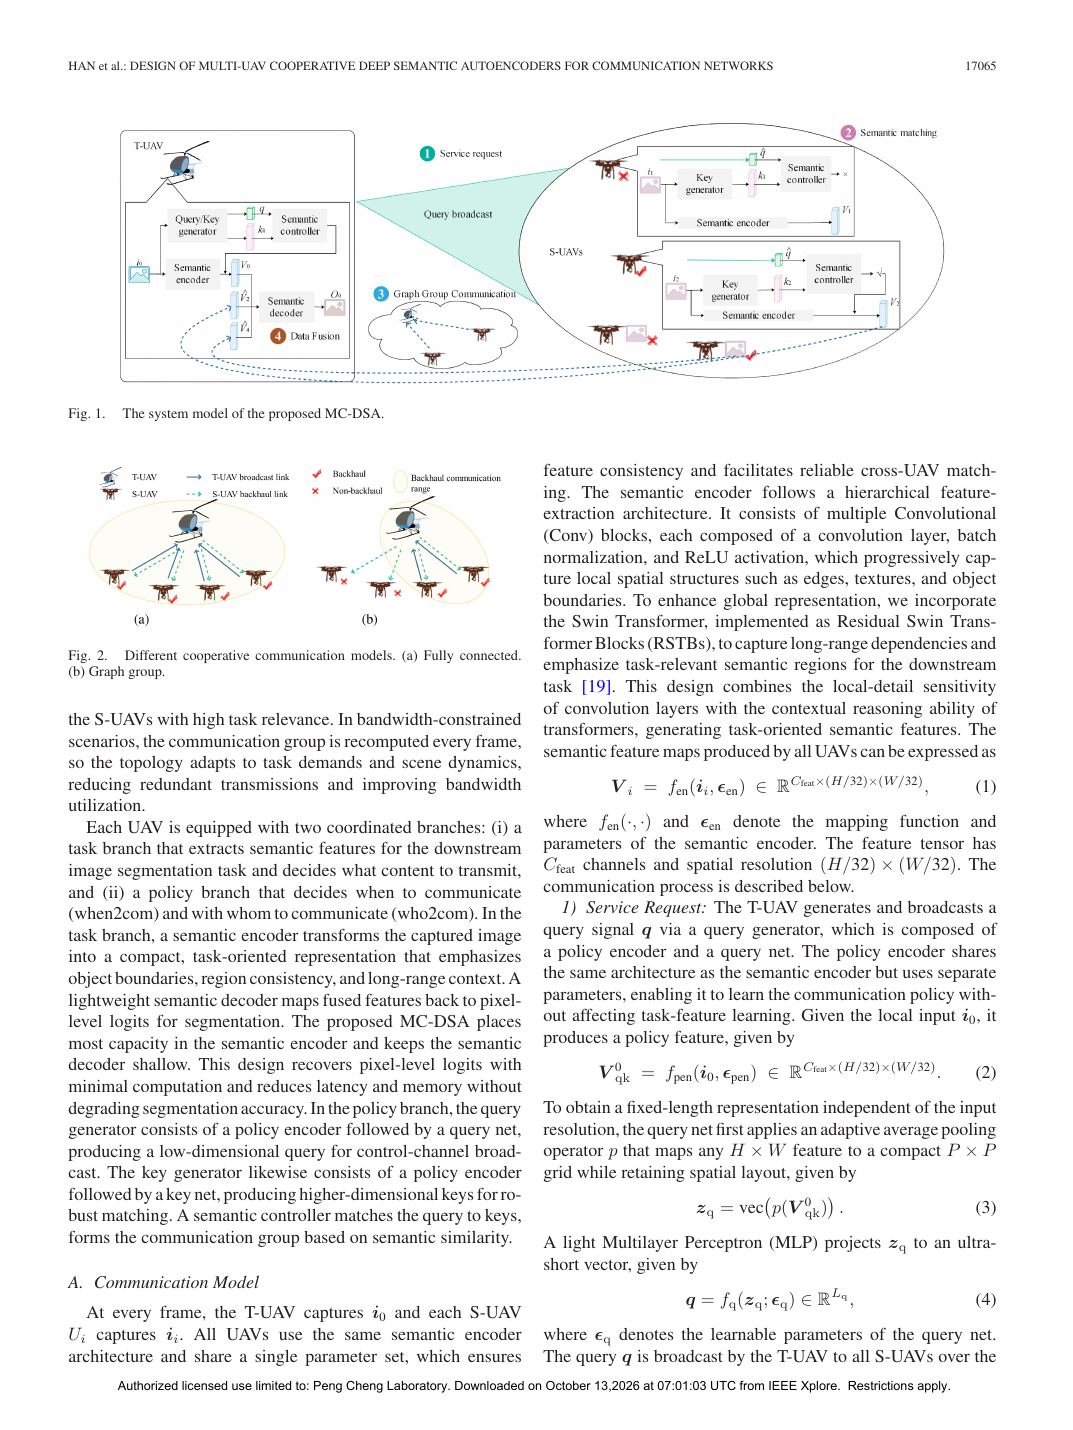
本文提出什么:为解决该问题,提出了一种面向通信网络的多无人机协作式深度语义自动编码器(MC-DSA)。 PDF p.1
方案为何可能有效:该体系结构由一个任务无人机(T-UAV)和多个支持无人机(S-UAV)组成,通过语义通信和协作,共同提高通信效率和数据处理能力。 PDF p.1
作者希望证明什么:该方法减少了冗余传输,为多无人机通信网络提供了一种有效的解决方案。 PDF p.1
方法与端到端信息流
针对这些问题,提出了一种基于多无人机协作的通信网络深度语义自动编码器(MC-DSA),该架构由一个任务无人机(T-UAV)和多个支持无人机(S-UAV)组成,通过语义通信和协作,共同提高通信效率和数据处理能力,我们提出了用于通信网络的多UAV协作深度语义自动编码器(MC-DSA)。 PDF p.1PDF p.2
输入输入是语义感知资源分配与网络优化所需的用户、任务、信道和资源状态。
发送端发送端采用 Design of Multi-UAV Cooperative Deep Semantic Autoencoders for Communication Networks:针对这些问题,提出了一种基于多无人机协作的通信网络深度语义自动编码器(MC-DSA),该架构由一个任务无人机(T-UAV)和多个支持无人机(S-UAV)组成,通过语义通信和协作,共同提高通信效率和数据处理能力,我们提出了用于通信网络的多UAV协作深度语义自动编码器(MC-DSA)。
实际发送实际发送对象是系统模型定义的语义速率、任务效用或信道资源变量。
信道信道作用方式按“类别 5:沿用底层链路或抽象速率—效用模型”解释。
接收端接收端从系统公式假设的接收端输出或语义质量曲线开始,再执行语义解码、任务推理或生成。
输出最终输出为资源/部署策略及其语义效用。
它在通信系统中的位置:把语义/任务质量映射为网络效用,再分配功率、带宽、算力或时延。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:上层理论/资源变量;论文不单独定义可发送语义格式
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“上层理论/资源变量;论文不单独定义可发送语义格式”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:Design of Multi-UAV Cooperative Deep Semantic Autoencoders for Communication Networks 的主传输单位属于“上层理论/资源变量;论文不单独定义可发送语义格式”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
论文优化的是功率、带宽、时隙、用户调度或语义效用等上层资源变量,并未定义一条可逐 bit 复现的语义 codec。因而这里只报告系统约束和效用曲线,不能从优化变量反推 token/index 总 bit 数。 PDF p.2PDF p.9
信道与工作点AWGN、Rayleigh、Rician、fading channel、wireless channel、SNR of -20 dB、SNR of -10 dB
实验小节中明确出现的比较对象包括ResNet;指标包括accuracy、latency、throughput、PER;信道/链路条件包括AWGN、Rayleigh、Rician、fading channel、wireless channel;正文可定位的代表性工作点有SNR of -20 dB、SNR of -10 dB。 PDF p.9
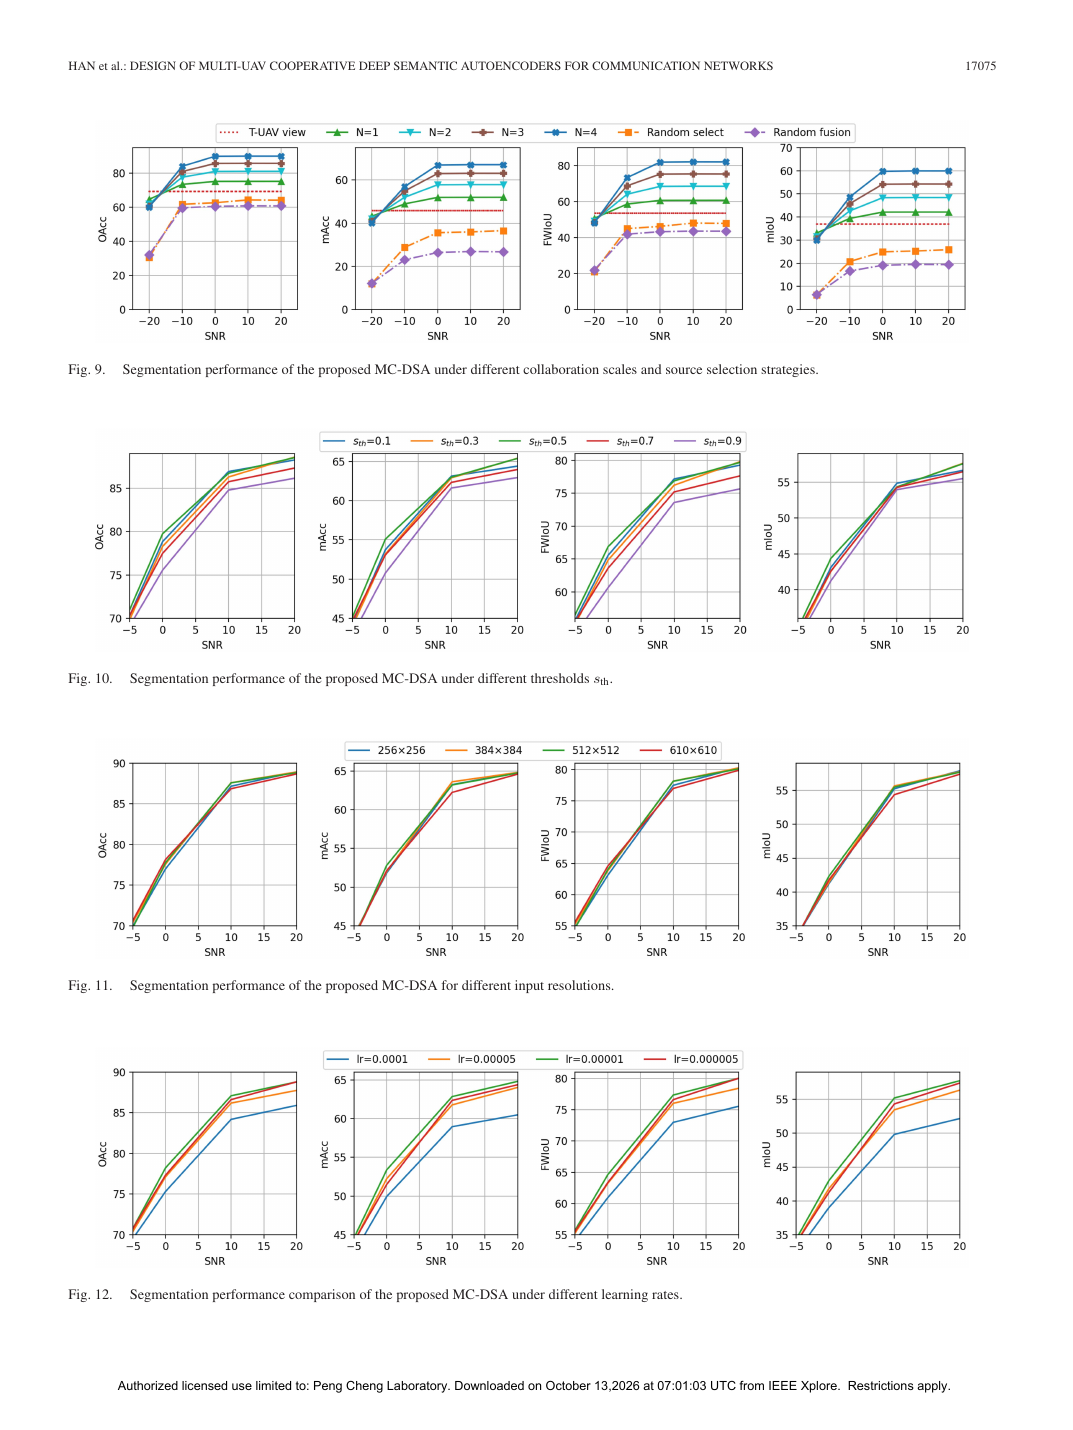
总体而言,MC-DSA在从低信噪比到高信噪比的所有指标上均优于MC-DSA@Cooperative,并随着信道的改善快速接近MCDSA@Standalone的上界。 PDF p.1PDF p.9
架构/方法图|来源:《Design of Multi-UAV Cooperative Deep Semantic Autoencoders for Communication Networks》,原 PDF p.3,Fig. 1 The SYSTEM MODEL of the proposed MC-DSA 核对论文关键实验结果图/表|来源:《Design of Multi-UAV Cooperative Deep Semantic Autoencoders for Communication Networks》,原 PDF p.13,Fig. 9 Segmentation performance of the proposed MC-DSA under different collaboration scales and source selection strategies 核对论文
核心纳入2026多模态检索与任务通信
Efficient Multimodal Task-Oriented Communication with Dynamic Modality Selection
架构/方法图|来源:《Efficient Multimodal Task-Oriented Communication with Dynamic Modality Selection》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Efficient Multimodal Task-Oriented Communication with Dynamic Modality Selection》,原 PDF p.3,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2026图像传输、压缩或生成
Foundation Model-Based Adaptive Semantic Image Transmission for Dynamic Wireless Environments
仍然存在的问题:然而,现有方法存在两个主要局限性:(i)它们未能考虑不同下游任务中语义组件的不同重要性,以及(ii)它们没有充分利用无线域知识,这导致动态信道条件下的鲁棒性有限。 PDF p.1
为什么已有方法解决不了:分离压缩与信道编码优化的是中间 bit 可靠性,未必等价于本文关心的语义/任务质量;反过来,只做端到端网络而不交代带宽、功率和信道作用点也无法形成公平通信比较。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
本文提出什么:然而,现有方法存在两个主要局限性:(i)它们未能考虑不同下游任务中语义组件的不同重要性,以及(ii)它们没有充分利用无线域知识,这导致动态信道条件下的鲁棒性有限。 PDF p.1
方案为何可能有效:该系统将每个图像分解为语义分割图和压缩表示,从而实现关键对象和细粒度纹理的任务感知优先级。 PDF p.1
作者希望证明什么:在动态信道质量、信道估计失配和不完美信道状态信息(CSI)下进一步验证稳健性能,从而在感知质量(例如,SSIM、LPIPS、FID)、任务准确性(IoU)和传输效率方面产生一致增益。 PDF p.1
方法与端到端信息流
然而,现有方法表现出两个主要局限性:(i)它们未能考虑不同下游任务中语义分量的不同重要性,以及(ii)它们没有充分利用无线域知识,这导致在动态信道条件下的有限鲁棒性。这项工作的主要贡献总结如下:r多任务语义编码器和解码器:为了适应不同的环境需求,本文将图像分解为语义分割图和压缩表示。 PDF p.1PDF p.2
输入输入是图像传输、压缩或生成所需的图像及其视觉/任务语义。
发送端发送端采用 Foundation Model-Based Adaptive Semantic Image Transmission for Dynamic Wireless Environments:然而,现有方法表现出两个主要局限性:(i)它们未能考虑不同下游任务中语义分量的不同重要性,以及(ii)它们没有充分利用无线域知识,这导致在动态信道条件下的有限鲁棒性。这项工作的主要贡献总结如下:r多任务语义编码器和解码器:为了适应不同的环境需求,本文将图像分解为语义分割图和压缩表示。
信道与工作点MIMO、OFDM、wireless channel、at 10dB SNR、SNR of -8 dB、SNR = -8 dB
数据集为Cityscapes、BDD100K;实验小节中明确出现的比较对象包括JSCC、QAM、OFDM;指标包括SSIM、LPIPS、FID、MSE、NMSE、accuracy、mAP、IoU、latency、throughput;信道/链路条件包括MIMO、OFDM、wireless channel;正文可定位的代表性工作点有at 10dB SNR、SNR of -8 dB、SNR = -8 dB。 PDF p.8
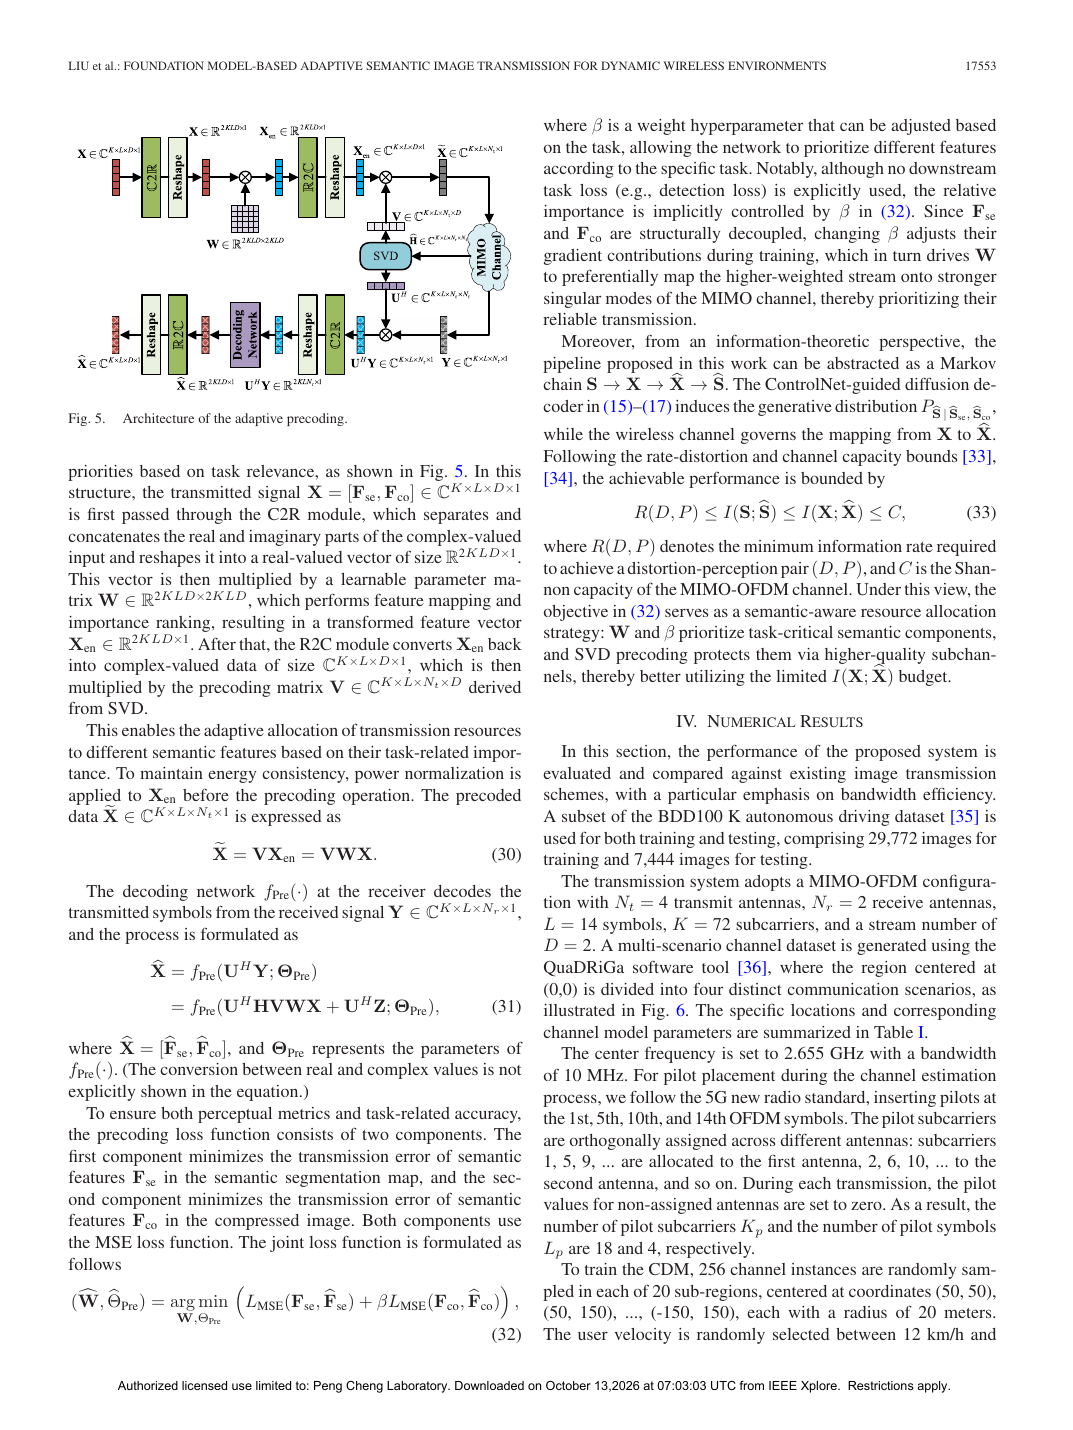
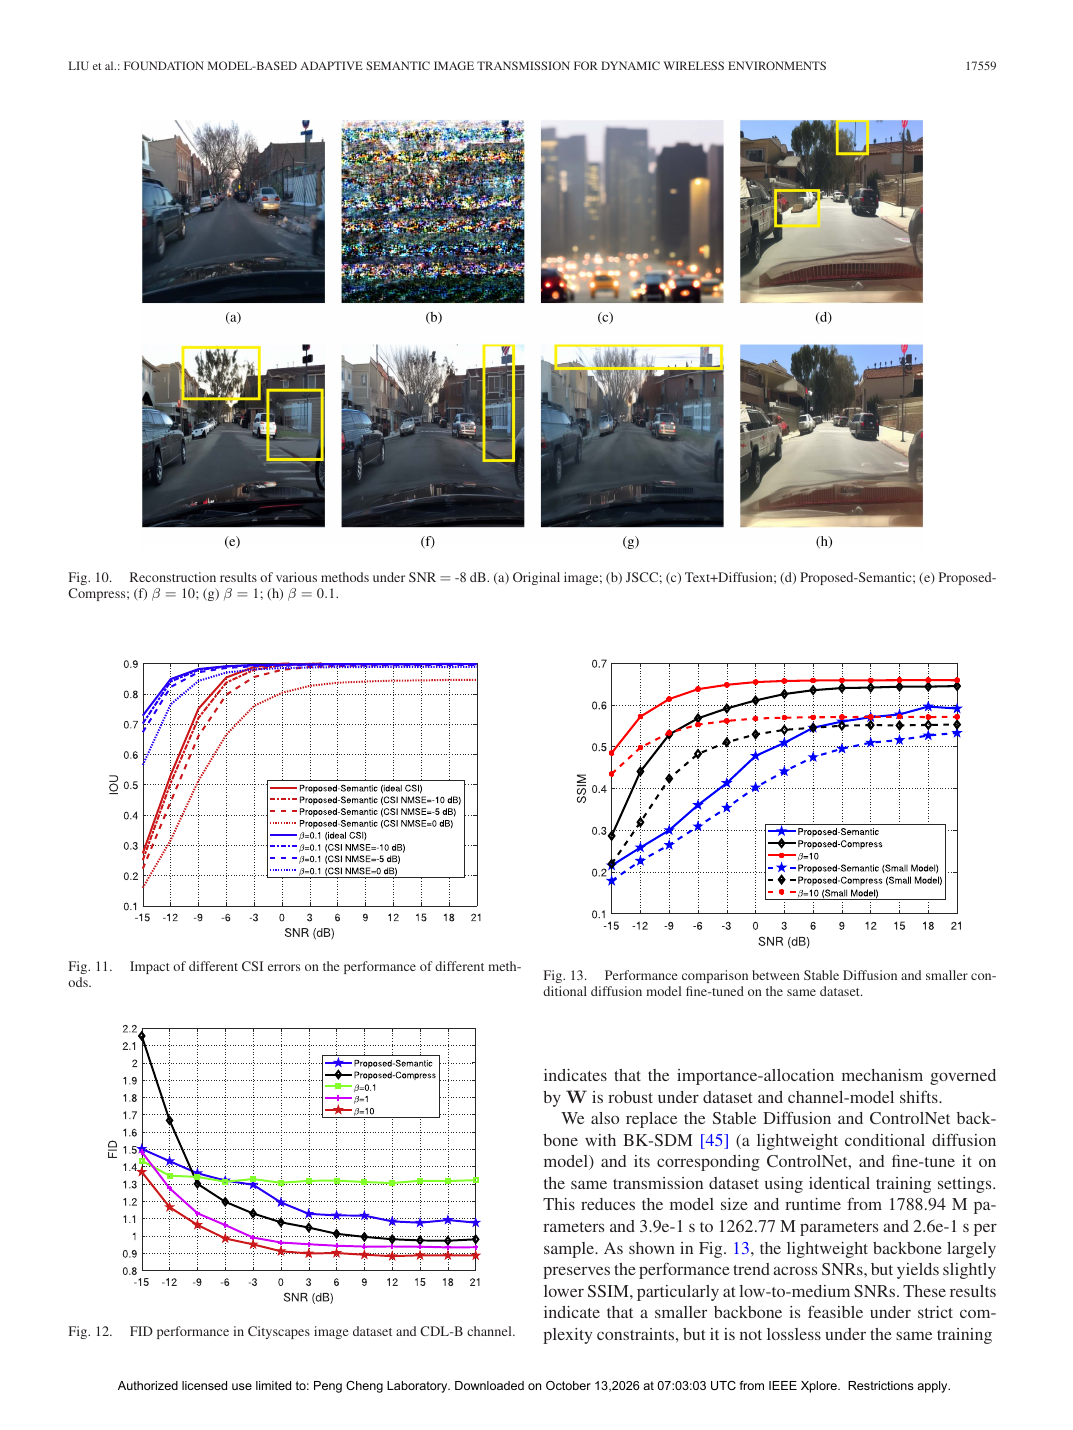
在动态信道质量、信道估计失配和不完美信道状态信息(CSI)的情况下,进一步验证了鲁棒性能,在感知质量方面产生一致的增益(例如,SSIM、LPIPS、FID)、任务准确度(IoU)和传输效率。由于使用了大尺度扩散模型,因此,所提出的框架和文本+扩散方法都会产生更高的计算成本(仅用10个推理步骤执行),但它们显著地减少了传输开销。 PDF p.1PDF p.10
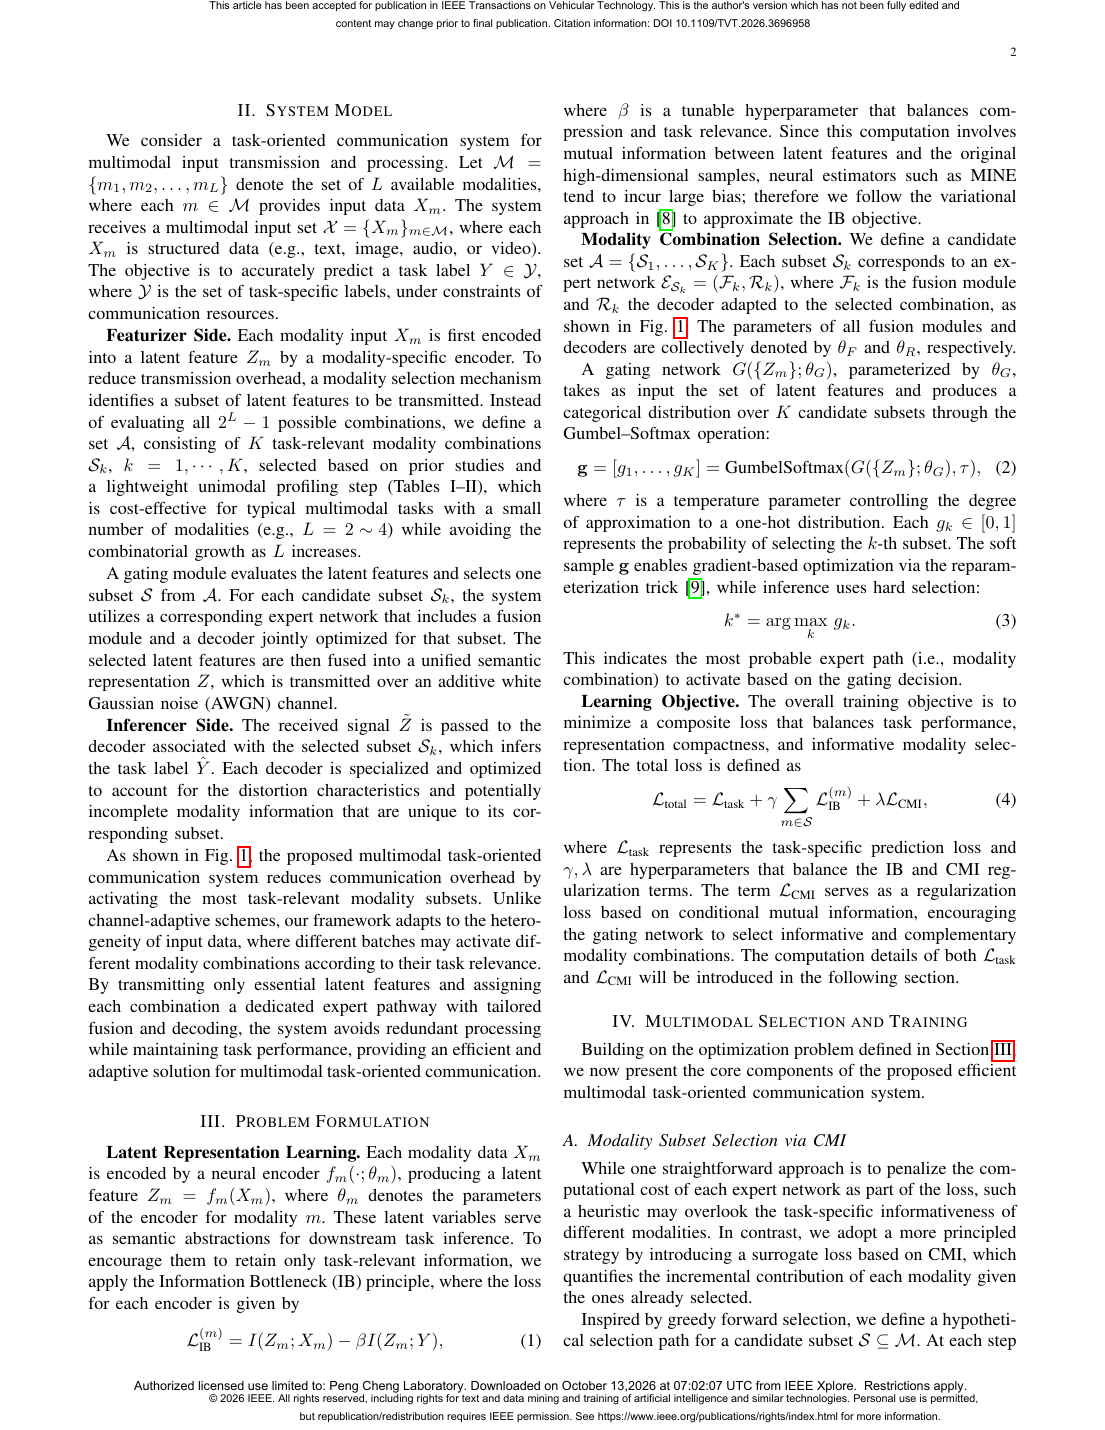
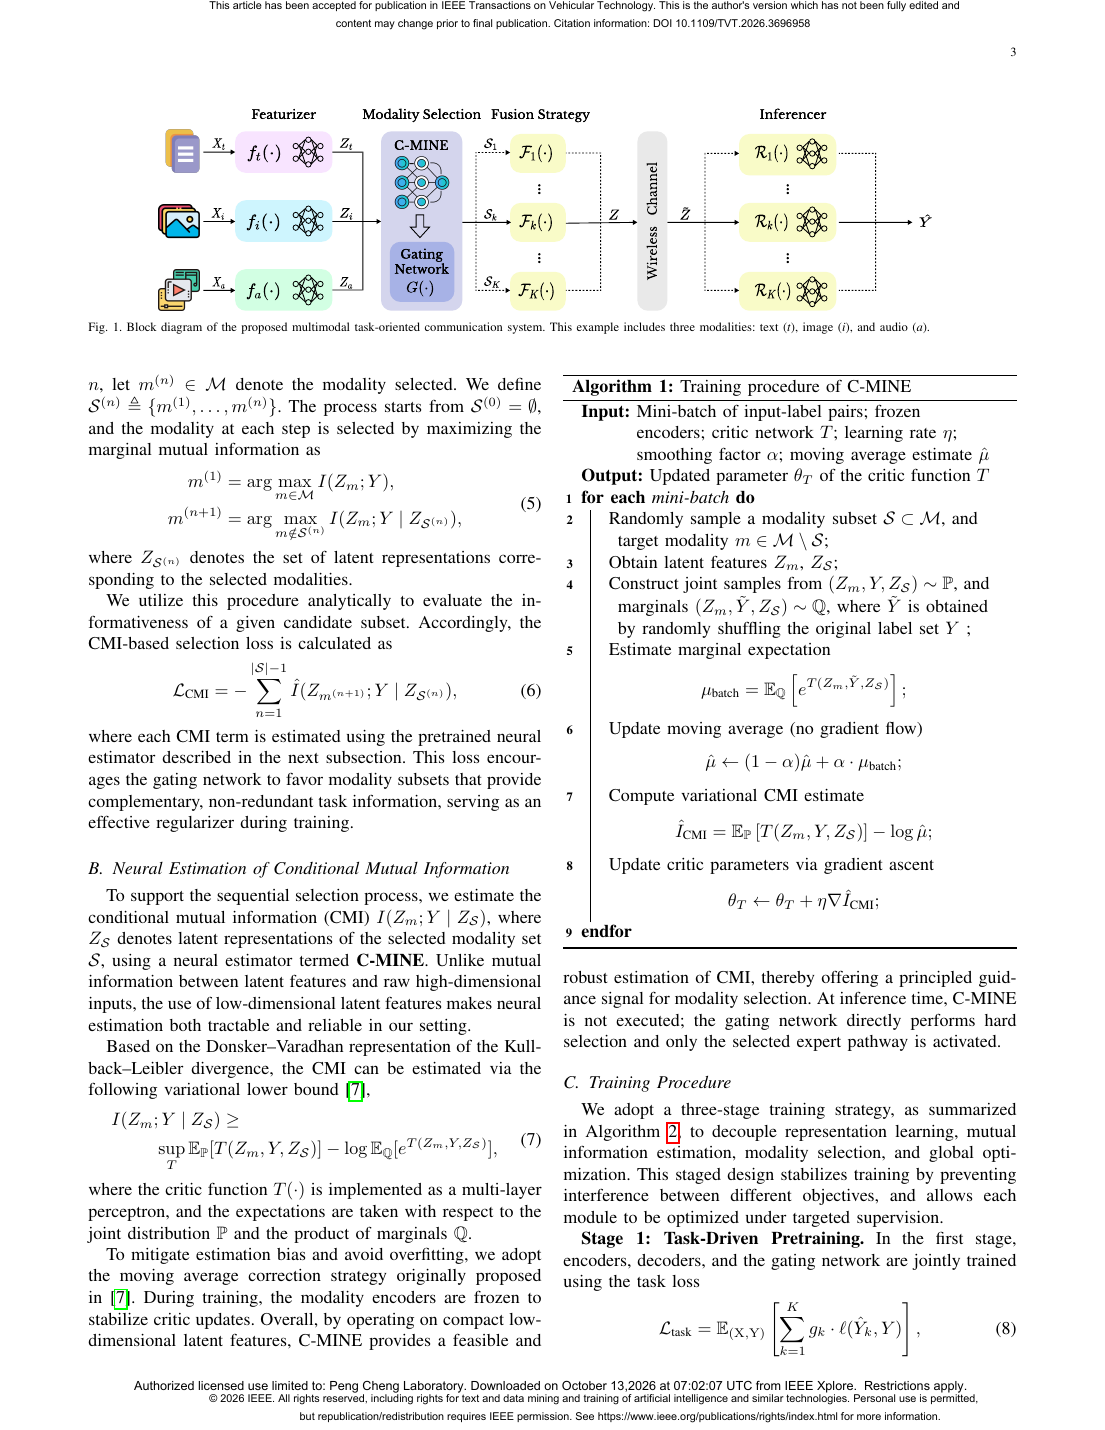
架构/方法图|来源:《Foundation Model-Based Adaptive Semantic Image Transmission for Dynamic Wireless Environments》,原 PDF p.8,Fig. 5 Architecture of the adaptive precoding 核对论文关键实验结果图/表|来源:《Foundation Model-Based Adaptive Semantic Image Transmission for Dynamic Wireless Environments》,原 PDF p.14,Fig. 10 Reconstruction RESULTS of various methods under SNR = -8 dB 核对论文
核心纳入2026图像传输、压缩或生成
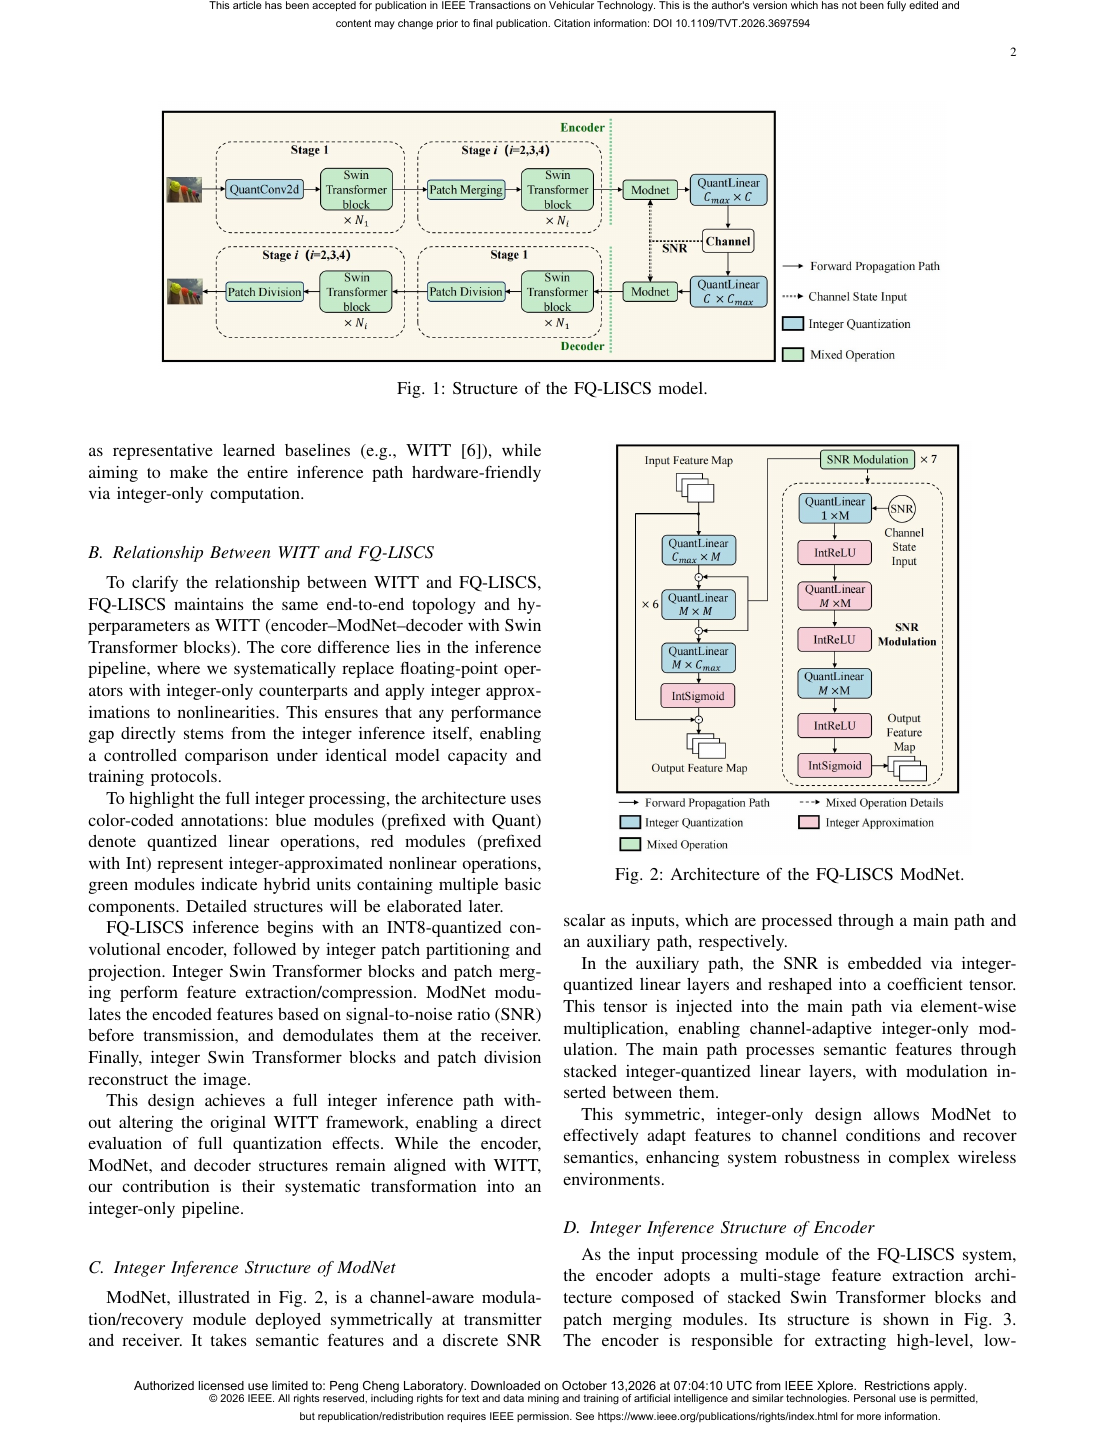
FQ-LISCS: Fully Quantized Lightweight Image Semantic Communication System for Edge Devices
现有进展:物联网(IoT)和边缘计算的兴起增加了在严格的延迟、内存和功率预算下进行高效图像传输的需求。 PDF p.1
仍然存在的问题:虽然学习的语义通信可以通过传输任务相关的表示而不是原始像素来减少带宽,但由于其依赖于浮点计算和沉重的内存占用,因此很难在资源受限的设备上部署最先进的模型。 PDF p.1
为什么已有方法解决不了:连续 latent 或独立设计的传统链路没有回答语义特征怎样量化、映射为有限符号,以及 bit/index 出错后为何不会跳到完全不同的语义。仅改进信源网络无法补上这一接口。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
本文提出什么:为了弥补这一差距,我们提出了一个完全量化的轻量级图像语义通信系统(EST-LISCS),它构建了一个完整的路径,只有整数推理管道的语义图像传输。 PDF p.1
方案为何可能有效:具体而言,FQ-LISCS将8位整数(INT 8)量化应用于线性运算符,并为关键非线性引入了高效的整数近似,从而实现了在推理期间无需浮点运算的端到端部署。 PDF p.1
作者希望证明什么:实验结果表明,FQ-LISCS的传输质量接近于全精度基线,峰值信噪比(PSNR)仅比柯达测试台上的无线图像传输Transformer(WITT)降低0.18dB,同时大大降低了硬件资源消耗。 PDF p.1
方法与端到端信息流
为了弥补这一不足,我们提出了一个完全量化的轻量级图像语义通信系统(FQ-LISCS),构造了一个全路径的纯整数推理流水线用于语义图像的传输,具体地说,FQ-LISCS将8位整数(INT 8)量化应用于线性算子,并对关键的非线性引入了有效的整数逼近,在推理过程中无需浮点运算即可实现端到端部署。核心区别在于推理管道,其中我们系统地将浮点运算符替换为仅限整数的对应项,并将整数近似应用于非线性。 PDF p.1PDF p.2
架构/方法图|来源:《FQ-LISCS: Fully Quantized Lightweight Image Semantic Communication System for Edge Devices》,原 PDF p.2,Fig. 3 The encoder is responsible for extracting high-level, low- 核对论文关键实验结果图/表|来源:《FQ-LISCS: Fully Quantized Lightweight Image Semantic Communication System for Edge Devices》,原 PDF p.4,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2026图像传输、压缩或生成
Generative AI-Driven Semantic Communication Framework for NextG Wireless Network
现有进展:这项工作设计了一种新的语义通信(SemCom)框架,下一代无线网络,以解决高带宽消耗,延迟和服务质量(QoS)下降。 PDF p.1
仍然存在的问题:然而,这两种方法都传递潜像表示而不是提取语义信息。 PDF p.1
为什么已有方法解决不了:把生成模型放在接收端并不等于通信开销自然降低;仍需明确发送什么条件、条件占多少资源,以及信道破坏条件时怎样约束幻觉和时延。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
本文提出什么:这项工作设计了一种新的语义通信(SemCom)框架,下一代无线网络,以解决高带宽消耗,延迟和服务质量(QoS)下降。 PDF p.1
方案为何可能有效:以下是贡献的总结:首先,我们提出了一种新的语义通信框架,该框架被明确设计用于在边缘设备上传输视频监控摄像头捕获的图像或视频。 PDF p.2
作者希望证明什么:实验结果表明,所提出的SemCom框架的有效性,通过实现高质量的重建在各种SNR信道条件下,导致在通信中的数据减少89.45%。 PDF p.1
方法与端到端信息流
这项工作为下一代无线网络设计了一种新的语义通信(SemCom)框架,以解决高带宽消耗、延迟和服务质量(QoS)下降的问题。·首先,我们提出了一种新的语义通信框架,该框架被明确地设计用于在边缘设备上传输由视频监控摄像机捕获的图像或视频。鉴于这些复杂性和现有解决方案的局限性,本研究的中心研究问题是:·我们如何设计一个有效的语义通信架构,用于在ITS中传输序列图像,不仅考虑任务相关性和现实世界的约束,如低延迟和有限的资源,而且还确保车辆,人员或任何其他实体的准确识别? PDF p.1PDF p.2
架构/方法图|来源:《Generative AI-Driven Semantic Communication Framework for NextG Wireless Network》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Generative AI-Driven Semantic Communication Framework for NextG Wireless Network》,原 PDF p.5,Fig. 4 Comparison of the MS-SSIM score among different training setup 核对论文
核心纳入2026图像传输、压缩或生成
Importance-Aware OFDM Transmission for VQ-VAE Based Digital Semantic Communications
现有进展:语义通信(SemCom)通过提取信息的潜在特征,显著减少了冗余数据,提高了传输效率。 PDF p.1
仍然存在的问题:然而,传统的基于深度学习的SemCom系统大多数侧重于模拟传输,缺乏与实际数字通信的兼容性。 PDF p.1
为什么已有方法解决不了:连续 latent 或独立设计的传统链路没有回答语义特征怎样量化、映射为有限符号,以及 bit/index 出错后为何不会跳到完全不同的语义。仅改进信源网络无法补上这一接口。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
本文提出什么:该文提出了一种基于矢量量化变分自动编码器(VQ-VAE)的数字SemCom系统,该系统直接传输语义特征,并结合重要性感知的正交频分复用(OFDM)传输来提高SemCom性能。 PDF p.1
方案为何可能有效:接下来,对所提出的语义传输方案进行详细介绍。 PDF p.2
作者希望证明什么:通过实验验证了和传统的DeepSC算法相比,这种算法在低信噪比下具有更好的重构性能。 PDF p.1
方法与端到端信息流
本文提出了一种基于矢量量化变分自动编码器(VQ-VAE)的数字SemCom系统,该系统直接传输语义特征,并结合重要性感知正交频分复用(OFDM)传输来提高SemCom的性能,其中VQ-VAE产生一个在发送机和接收机之间共享的离散码本。接着,介绍了所提出的语义传输方案的细节。 PDF p.1PDF p.2
架构/方法图|来源:《Importance-Aware OFDM Transmission for VQ-VAE Based Digital Semantic Communications》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Importance-Aware OFDM Transmission for VQ-VAE Based Digital Semantic Communications》,原 PDF p.6,Fig. 5 Visual reconstruction RESULTS under different semantic transmission schemes versus SNR 核对论文
相关但非核心2026任务导向推理
Integrated Sensing, Computing, Communication, and Control for Time-Sequence-Based Semantic Communications
现有进展:实时无线控制系统(WCS)是互联和自动驾驶汽车以及机器人应用的基础,在这些应用中,超可靠和低延迟的通信对于及时交换控制信息至关重要。 PDF p.1
仍然存在的问题:然而,由于时间序列中的因果相关性,控制信息不呈现马尔可夫性质。 PDF p.1
为什么已有方法解决不了:像素级重建是比下游决策更强、也更昂贵的目标;但只压缩 feature 又可能丢掉决定任务的少量证据,因此需要把任务 loss 与通信瓶颈联合设计。 PDF p.1
为什么这个问题重要:边缘设备常需要及时决策而不是完整副本;只发送任务充分信息可以降低时延与带宽,但前提是关键证据确实能穿过信道。 PDF p.1
本文提出什么:为了实现这一目的,我们提出了一种新的基于时间序列的语义通信范式,其中集成的传感,计算,通信和控制(ISC 3)架构的开发,使合理的语义推理(SI)的控制信息的时间序列,使自适应控制的机器人。 PDF p.1
方案为何可能有效:我们设计了上述模块/策略的神经网络结构,并通过一种新的混合奖励多智能体深度强化学习框架来训练它们的参数。 PDF p.1
作者希望证明什么:现场实验进行了评估,我们提出的方法在实践中的性能,这表明显着的收益比其他基线计划。 PDF p.1
方法与端到端信息流
为了实现这一目的,我们提出了一种新型的基于时间序列的语义通信范式,其中开发了集成的传感、计算、通信和控制(ISC 3)架构,以对时间序列上的控制信息进行明智的语义推理(SI),实现了机器人的自适应控制。我们设计了上述模块的神经网络结构。策略,并通过一种新的混合奖励多智能体深度强化学习框架训练它们的参数。此外,我们提出的方案的实现依赖于已建立的通信系统,并且不需要额外设计语义编码和调制技术。 PDF p.1PDF p.2
架构/方法图|来源:《Integrated Sensing, Computing, Communication, and Control for Time-Sequence-Based Semantic Communications》,原 PDF p.8,Fig. 6 The Q and target Q network architectures 核对论文关键实验结果图/表|来源:《Integrated Sensing, Computing, Communication, and Control for Time-Sequence-Based Semantic Communications》,原 PDF p.11,Fig. 8 Robot control error versus PSNR 核对论文
相关但非核心2026通用语义通信系统
Joint Beamforming for Multi-RIS-Aided Semantic Communication Systems
仍然存在的问题:然而,这些组件之间的耦合效应对导出封闭形式的解决方案提出了重大挑战,可能导致显著的性能下降。 PDF p.1
为什么已有方法解决不了:只按 bit rate、吞吐量或平均失真分配资源,无法区分不同样本和任务的语义价值;外层优化必须得到可用的语义效用—资源曲线。 PDF p.1
为什么这个问题重要:语义质量必须在真实的带宽、功率和时延预算下成立,否则模型收益不能转化为通信系统收益。 PDF p.1
本文提出什么:本文在充分挖掘多RIS辅助语义通信系统潜力的基础上,提出了一种联合优化框架RISSC。 PDF p.1
方案为何可能有效:具体地,RISSC结合了语义编解码器和信道编解码器以实现语义信息的生成和重构,以及用于高效波束成形的预编码器和组合器。 PDF p.1
作者希望证明什么:仿真结果表明,所提出的RISSC算法在低信噪比(SNR)环境下显著提高了多RIS辅助语义通信系统的性能,同时增强了系统的鲁棒性。 PDF p.1
方法与端到端信息流
本文提出了一个联合优化框架RISSC,该框架结合了语义编码器和信道编码器来实现语义信息的生成和重构,提出了一种用于多RIS系统的RISSC算法,该算法采用了预编码器和组合器来实现有效的波束形成。辅助语义通信系统,用户被障碍物严重阻挡时,在基站和用户附近部署两个RIS,以增强通信链路。 PDF p.1PDF p.2
架构/方法图|来源:《Joint Beamforming for Multi-RIS-Aided Semantic Communication Systems》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Joint Beamforming for Multi-RIS-Aided Semantic Communication Systems》,原 PDF p.3,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2026通用语义通信系统
Knowledge Graph Based Semantic Communication Networks With Deep Reinforcement Learning Enhancement
现有进展:随着信源编码和信道编码等物理层技术的发展,传统通信系统的频谱效率已经接近香农极限。 PDF p.1
仍然存在的问题:探索语义通信范式对于解决超越位级精度的挑战、满足下一代智能应用(如增强现实、数字孪生和触觉互联网)的需求至关重要,这些应用可以在数据传输中有效地传达意义和上下文。 PDF p.1
为什么已有方法解决不了:连续 latent 或独立设计的传统链路没有回答语义特征怎样量化、映射为有限符号,以及 bit/index 出错后为何不会跳到完全不同的语义。仅改进信源网络无法补上这一接口。 PDF p.1
为什么这个问题重要:语义质量必须在真实的带宽、功率和时延预算下成立,否则模型收益不能转化为通信系统收益。 PDF p.1
本文提出什么:为此,本文提出了一种自恢复语义通信(SR-SC)体系结构,该结构利用知识图推理(KGR)编解码器、语义恢复器和语义约简器来提高通信网络的性能。 PDF p.1
方案为何可能有效:据我们所知,这是第一个试图利用知识图的拓扑结构来优化语义通信性能的研究。 PDF p.2
作者希望证明什么:在公开数据集上的仿真结果表明,SR-SC结构显著降低了语义符号的错误率,改善了语义通信网络的有效性和可靠性。 PDF p.1
方法与端到端信息流
因此,我们提出了一种自恢复语义通信(SR-SC)体系结构,该结构利用知识图推理(KGR)编解码器、语义恢复器和语义约简器来提高通信网络的性能,这是第一个尝试利用知识图的拓扑结构来优化语义通信性能的研究。针对上述问题,本文提出了一种新的自恢复语义通信(SR-SC)体系结构。 PDF p.1PDF p.2
输入输入是通用语义通信系统所需的信源数据和接收端任务。
发送端发送端采用 Knowledge Graph Based Semantic Communication Networks With Deep Reinforcement Learning Enhancement:因此,我们提出了一种自恢复语义通信(SR-SC)体系结构,该结构利用知识图推理(KGR)编解码器、语义恢复器和语义约简器来提高通信网络的性能,这是第一个尝试利用知识图的拓扑结构来优化语义通信性能的研究。针对上述问题,本文提出了一种新的自恢复语义通信(SR-SC)体系结构。
实际发送实际发送对象是量化 bit、离散 token 或码本 index。
信道信道作用方式按“类别 2:数字语义变量接入调制、信道编码或 OFDM 链路”解释。
接收端接收端从解调/信道译码后的 bit 或 index;残余错误是否进入语义 decoder 需单独判断开始,再执行语义解码、任务推理或生成。
架构/方法图|来源:《Knowledge Graph Based Semantic Communication Networks With Deep Reinforcement Learning Enhancement》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Knowledge Graph Based Semantic Communication Networks With Deep Reinforcement Learning Enhancement》,原 PDF p.7,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2026视频传输、生成或控制
LGVSC: A Large-Model-Driven Generative Video Semantic Communication Framework
现有进展:在万物互联的大规模视频传输需求的驱动下,语义通信有望在传输效率和质量之间取得平衡。 PDF p.1
仍然存在的问题:但是,若要将本材料用于任何其他目的,必须通过向pubs-permission@ieee.org发送请求,从IEEE获得许可。 PDF p.1
为什么已有方法解决不了:分离压缩与信道编码优化的是中间 bit 可靠性,未必等价于本文关心的语义/任务质量;反过来,只做端到端网络而不交代带宽、功率和信道作用点也无法形成公平通信比较。 PDF p.1
为什么这个问题重要:视频持续占用带宽且具有严格时延,单帧错误还会跨帧传播;通信系统必须同时处理时序一致性、资源占用和渐进退化。 PDF p.1
本文提出什么:本文介绍了一个大模型驱动的生成式视频语义通信(LGVSC)框架,使高效的视频语义传输在极低的带宽条件下。 PDF p.1
方案为何可能有效:此外,我们在接收端设计了一个生成式大模型驱动的动态语义自适应解码器,它可以适应任意长度的视频。 PDF p.1
作者希望证明什么:仿真结果表明,LGVSC显着优于传统的计划,实现了10-4到10-3的数量级的信道带宽比,同时保持强大的零拍泛化跨下游任务。 PDF p.1
方法与端到端信息流
本文介绍了一种大模型驱动的生成式视频语义通信(LGVSC)框架,可以在极低带宽条件下实现高效的视频语义传输。此外,我们在接收端设计了一个生成式大模型驱动的动态语义自适应解码器,它可以适应任意长度的视频。建议LGVSC框架使用SKEM(或SKIM)在发射机和DSA(或SFA)用于自适应时间信息选择的语义相似性度量。 PDF p.1PDF p.2
架构/方法图|来源:《LGVSC: A Large-Model-Driven Generative Video Semantic Communication Framework》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《LGVSC: A Large-Model-Driven Generative Video Semantic Communication Framework》,原 PDF p.7,Fig. 5 A particularly illustrative cross-case comparison arises between Kitchen cupboard (1) in Type 1 ( 核对论文
相关但非核心2026语义感知资源分配与网络优化
LLM-Enhanced Generative Semantic Communication and DRL Resource Management for UAV-Assisted Emergency Response
仍然存在的问题:然而,由于图像承载量大、灾后信道不畅以及丢包导致的语义失真等因素,解译图像的可靠传输仍然是一个挑战。 PDF p.1
为什么已有方法解决不了:只按 bit rate、吞吐量或平均失真分配资源,无法区分不同样本和任务的语义价值;外层优化必须得到可用的语义效用—资源曲线。 PDF p.1
为什么这个问题重要:功率、带宽、算力和时延是共享资源;若调度器不知道语义效用,它可能增加吞吐量却没有改善任何用户真正关心的任务。 PDF p.1
本文提出什么:为了克服上述缺陷,本文提出了一种基于检索增强生成(RAG)和大语言模型(LLM)的无人机辅助应急响应生成式语义通信框架(RLE-GSC)。 PDF p.1
方案为何可能有效:在RLE-GSC中,无人机端的轻量级LLM将感知图像转换为低比特率的语义文本,而基站(BS)端的LLM对受损文本执行基于知识的校正。 PDF p.1
作者希望证明什么:仿真结果表明,语义校正和RBCSIR分别提高了文本和图像语义相似度10%~25%和12%~27%,而LE-DRL的QoE增益最高可达38%。 PDF p.1
方法与端到端信息流
针对这些问题,提出了一种基于检索增强生成(RAG)和大语言模型(LLM)的无人机辅助应急语义生成框架(RLE-GSC),在该框架中,无人机侧的轻量级LLM将感知图像转换为低比特率的语义文本,而基站侧的LLM则对受损文本进行基于知识的修正。基于以上分析,为解决这些挑战,我们提出了一种LLM增强型无人机辅助应急响应系统。 PDF p.1PDF p.2
架构/方法图|来源:《LLM-Enhanced Generative Semantic Communication and DRL Resource Management for UAV-Assisted Emergency Response》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《LLM-Enhanced Generative Semantic Communication and DRL Resource Management for UAV-Assisted Emergency Response》,原 PDF p.12,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2026图像传输、压缩或生成
Multi-Dimensional Multiple Access-Based Hybrid Semantic-Bit Communications for Individualized QoS Provisioning
现有进展:未来的无线网络必须支持多样化的设备和应用,从物联网支持的低延迟服务(如自动驾驶)到数据密集型智能应用(如虚拟现实)。 PDF p.1
仍然存在的问题:然而,传统的系统设计在实现SemCom和BitCom用户的共存方面面临两个基本限制。 PDF p.1
为什么已有方法解决不了:把单用户语义编解码器逐个复制给多个用户,会忽略共享内容、异构信道、干扰和公平性,因而不能直接得到频谱有效的网络方案。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
本文提出什么:在这些挑战的推动下,我们为汇丰提出了一个量身定制的并购计划,该计划利用多域资源共享来灵活管理 PDF p.1
方案为何可能有效:(2a)(2b)2)MDMA框架:在本工作中,所提出的MDMA框架包括四种多址变体:OMA、PDNOMA、SD-NOMA和混合NOMA。 PDF p.2
作者希望证明什么:通过启发式匹配算法有效地解决了由此产生的非凸问题,与传统的基线相比实现了显著的性能提升。 PDF p.1
方法与端到端信息流
在这些挑战的推动下,我们为汇丰银行提出了一个量身定制的MA方案,该方案利用多域资源共享来灵活管理(2a)(2b)2)MDMA框架:在这项工作中,提出的MDMA框架包括四种多址变体:OMA、PDNOMA、SD-NOMA和混合NOMA。r我们为汇丰银行提出了一种自适应多维多址(MDMA)机制,该机制可在多个域之间灵活地协调无线电资源和通信模式,从而通过这种自适应性增强干扰管理。 PDF p.1PDF p.2
架构/方法图|来源:《Near-Field Integrated Sensing, Computing and Semantic Communication in Digital Twin-Assisted Vehicular Networks》,原 PDF p.4,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Near-Field Integrated Sensing, Computing and Semantic Communication in Digital Twin-Assisted Vehicular Networks》,原 PDF p.6,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2026多模态检索与任务通信
Perception Enhanced Multimodal Multitask Semantic Communication and Resource Management for UAV-Assisted ISAC Systems
架构/方法图|来源:《Perception Enhanced Multimodal Multitask Semantic Communication and Resource Management for UAV-Assisted ISAC Systems》,原 PDF p.11,Fig. 2 Additionally, the NN layer structure used is consistent with the hierarchical configuration listed in 核对论文关键实验结果图/表|来源:《Perception Enhanced Multimodal Multitask Semantic Communication and Resource Management for UAV-Assisted ISAC Systems》,原 PDF p.14,Fig. 13 Total QoE VS Iteration 核对论文
核心纳入2026图像传输、压缩或生成
Quantum Communication for Semantic Communication Based Image Transmission
该系统首先使用语义编码器生成紧凑的潜在表示,然后通过噪声量子信道发送得到的量子态,在接收端对量子态进行测量和解码,恢复出相应的经典bitstream。 表示判定:Quantum Communication for Semantic Communication Based Image Transmission 的主传输单位属于“显式数字语义表示:bit、离散 token 或码本 index”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.1
论文未同时报告输入尺寸、encoder 输出尺寸、量化精度/码本大小和帧级开销,因此不能从全文唯一重建总 bit 数。页面保留论文实际使用的 CBR、bpp、token 数或信道使用次数;缺失项不作臆测。 PDF p.2PDF p.6
架构/方法图|来源:《Quantum Communication for Semantic Communication Based Image Transmission》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Quantum Communication for Semantic Communication Based Image Transmission》,原 PDF p.6,该页包含论文的关键实验结果图或表。 核对论文
相关但非核心2026语义信息度量与理论
Random Access for Semantic Transmission Under Finite Buffer and Retransmission in Vehicular Networks
架构/方法图|来源:《Random Access for Semantic Transmission Under Finite Buffer and Retransmission in Vehicular Networks》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Random Access for Semantic Transmission Under Finite Buffer and Retransmission in Vehicular Networks》,原 PDF p.5,Fig. 7 Semantic rate versus SNR at different compression ratios 核对论文
相关但非核心2026通用语义通信系统
Rate Maximization for Fluid Antenna System Assisted Semantic Communication
架构/方法图|来源:《Rate Maximization for Fluid Antenna System Assisted Semantic Communication》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Rate Maximization for Fluid Antenna System Assisted Semantic Communication》,原 PDF p.3,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2026图像传输、压缩或生成
Robust Image Semantic Communication via Wavelet-Attentive JSCC Under Adversarial and Channel Perturbations
现有进展:语义通信因其能够有效地传输有意义的信息而不是追求比特级的准确性,从而最小化资源消耗而受到广泛关注。 PDF p.1
仍然存在的问题:然而,除了无线信道干扰之外,该范例还容易受到由对抗性攻击引起的语义损伤。 PDF p.1
为什么已有方法解决不了:分离压缩与信道编码优化的是中间 bit 可靠性,未必等价于本文关心的语义/任务质量;反过来,只做端到端网络而不交代带宽、功率和信道作用点也无法形成公平通信比较。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
本文提出什么:本文提出了一种基于小波变换的频域注意力特征(WTAF)模型,该模型采用多级小波分解,有效地将语义结构从高频对抗噪声中分离出来。 PDF p.1
方案为何可能有效:本文提出了一种基于小波变换的频域注意力特征(WTAF)模型,该模型采用多级小波分解,有效地将语义结构从高频对抗噪声中分离出来。 PDF p.1
作者希望证明什么:仿真结果显示,与已有的JSCC模型和传统的信源信道分离编码相比,该方案在重构质量、语义完整性和整体鲁棒性等方面都具有明显的优势。 PDF p.1
方法与端到端信息流
本文提出了一种小波变换频域注意特征(WTAF)模块,该模块采用多级小波分解,有效地将语义结构从高频对抗性噪声中分离出来,本文的目标是设计N以实现对抗性语义攻击条件下的鲁棒图像语义通信。 PDF p.1PDF p.2
输入输入是图像传输、压缩或生成所需的图像及其视觉/任务语义。
发送端发送端采用 Robust Image Semantic Communication via Wavelet-Attentive JSCC Under Adversarial and Channel Perturbations:本文提出了一种小波变换频域注意特征(WTAF)模块,该模块采用多级小波分解,有效地将语义结构从高频对抗性噪声中分离出来,本文的目标是设计N以实现对抗性语义攻击条件下的鲁棒图像语义通信。
实际发送实际发送对象是量化 bit、离散 token 或码本 index。
信道信道作用方式按“类别 2:数字语义变量接入调制、信道编码或 OFDM 链路”解释。
接收端接收端从解调/信道译码后的 bit 或 index;残余错误是否进入语义 decoder 需单独判断开始,再执行语义解码、任务推理或生成。
输出最终输出为重建/生成图像或视觉任务输出。
它在通信系统中的位置:在同一系统中共同设计压缩、语义保真和抗信道噪声机制。
数字化方案与真实传输开销
是否属于严格数字语义通信:是:存在明确的离散/有限数字接口
表示判断:显式数字语义表示:bit、离散 token 或码本 index
具体地说,在第l层(l = 1,2,. ..,L),输入特征映射表示为F(l-1),在L个DWT之后,为了恢复空间结构,我们应用L个逆离散小波变换(IDWT)W-1来重构残差特征映射。 表示判定:Robust Image Semantic Communication via Wavelet-Attentive JSCC Under Adversarial and Channel Perturbations 的主传输单位属于“显式数字语义表示:bit、离散 token 或码本 index”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.3
论文未同时报告输入尺寸、encoder 输出尺寸、量化精度/码本大小和帧级开销,因此不能从全文唯一重建总 bit 数。页面保留论文实际使用的 CBR、bpp、token 数或信道使用次数;缺失项不作臆测。 PDF p.2PDF p.3
架构/方法图|来源:《Robust Image Semantic Communication via Wavelet-Attentive JSCC Under Adversarial and Channel Perturbations》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Robust Image Semantic Communication via Wavelet-Attentive JSCC Under Adversarial and Channel Perturbations》,原 PDF p.4,Fig. 4 Overall comparison under different channels and adversarial settings 核对论文
核心纳入2026图像传输、压缩或生成
Robust MIMO Semantic Communication With Imperfect CSI via Knowledge Distillation
架构/方法图|来源:《Robust MIMO Semantic Communication With Imperfect CSI via Knowledge Distillation》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Robust MIMO Semantic Communication With Imperfect CSI via Knowledge Distillation》,原 PDF p.9,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2026任务导向推理
SComCP: Task-Oriented Semantic Communication for Collaborative Perception
架构/方法图|来源:《SComCP: Task-Oriented Semantic Communication for Collaborative Perception》,原 PDF p.11,Fig. 8 Examples of 3D detection outputs produced by our PROPOSED METHOD 核对论文关键实验结果图/表|来源:《SComCP: Task-Oriented Semantic Communication for Collaborative Perception》,原 PDF p.8,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2026图像传输、压缩或生成
Semantic Communication for High-Speed Mobility Scenarios: A Semantic-OTFS Scheme
架构/方法图|来源:《Semantic Communication for High-Speed Mobility Scenarios: A Semantic-OTFS Scheme》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《Semantic Communication for High-Speed Mobility Scenarios: A Semantic-OTFS Scheme》,原 PDF p.8,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2026图像传输、压缩或生成
Space-Time Deep Joint Source-Channel Coding for Wireless Image Transmission with Imperfect CSI
现有进展:这些最新的工作表明,多天线传输和高级神经网络结构都可以提高DeepJSCC系统的重构性能。 PDF p.1
仍然存在的问题:现有的基于卷积神经网络(CNN)的多输入多输出(MIMO)JSCC框架在信道状态信息(CSI)不完善的情况下,性能严重下降。 PDF p.1
为什么已有方法解决不了:连续 latent 或独立设计的传统链路没有回答语义特征怎样量化、映射为有限符号,以及 bit/index 出错后为何不会跳到完全不同的语义。仅改进信源网络无法补上这一接口。 PDF p.1
为什么这个问题重要:有限信道使用迫使系统决定哪些视觉内容值得保护;低 SNR 或高压缩率下,任务/感知关键结构往往比平均像素误差更重要。 PDF p.1
本文提出什么:现有的基于卷积神经网络(CNN)的多输入多输出(MIMO)JSCC框架在信道状态信息(CSI)不完善的情况下,性能严重下降。 PDF p.1
方案为何可能有效:具体地说,构建了一种嵌入了基于注意力的特征增强模块和SNR自适应注意力融合模块的增强型编解码器体系结构,以生成内容感知和信道自适应的特征表示。 PDF p.1
作者希望证明什么:在多个图像数据集上的实验结果表明,在不完美CSI下,所提出的框架实现了基于CNN和基于Transformer的DeepJSCC基线的改进的重建性能。 PDF p.1
方法与端到端信息流
现有的基于卷积神经网络(CNN)的多输入多输出(MIMO)JSCC框架通常在不完美的信道状态信息(CSI)下遭受严重的性能降级。构建了嵌入有基于注意力的特征增强块和SNR自适应注意力融合模块的增强的编码器解码器体系结构,以生成内容感知和信道自适应的特征表示。本文提出了一种用于在具有不完美CSI的MIMO信道上进行无线图像传输的空时DeepJSCC框架。 PDF p.1PDF p.2
架构/方法图|来源:《Space-Time Deep Joint Source-Channel Coding for Wireless Image Transmission with Imperfect CSI》,原 PDF p.8,Fig. 5 Comparison of the proposed framework with DeepJSCC and SwinJSCC baselines under perfect and imperfect CSI on the DIV2K dataset (SNR: -3 dB to 17 dB) 核对论文关键实验结果图/表|来源:《Space-Time Deep Joint Source-Channel Coding for Wireless Image Transmission with Imperfect CSI》,原 PDF p.9,Fig. 8 PSNR and SSIM performance of different ablated variants on the DIV2K dataset under imperfect CSI (SNR: -3 dB to 17 dB) 核对论文
相关但非核心2026任务导向推理
The Search for Relevance: A Context-Aware Paradigm Shift in Semantic and Task-Oriented V2X Communications
现有进展:这些挑战在V2X领域尤为关键,在V2X领域,支持V2X的CCAM应用将需要CAV持续广播丰富的信息。 PDF p.1
仍然存在的问题:然而,向数据驱动的超连接社会和经济发展所面临的可扩展性挑战需要新的通信模式,精心策划传输的内容。 PDF p.1
为什么已有方法解决不了:像素级重建是比下游决策更强、也更昂贵的目标;但只压缩 feature 又可能丢掉决定任务的少量证据,因此需要把任务 loss 与通信瓶颈联合设计。 PDF p.1
为什么这个问题重要:边缘设备常需要及时决策而不是完整副本;只发送任务充分信息可以降低时延与带宽,但前提是关键证据确实能穿过信道。 PDF p.1
本文提出什么:本文提出了一种联合语义和面向任务的通信模式,连接的设备只传输必要的信息,以传达所需的意义,是相关的预期接收端,根据他们的上下文。 PDF p.1
方案为何可能有效:我们相信,V2X领域为开发和部署拟议的语义和面向任务的通信范式提供了一个独特的生态系统。 PDF p.2
作者希望证明什么:定量分析数值表明,语义和面向任务的V2X通信可以实现通信效率的双重提高,这可以显着有利于未来V2X网络的可扩展性。 PDF p.1
方法与端到端信息流
本文提出了一种联合语义和面向任务的通信范式,其中连接的设备仅发送传达与预期接收者相关的期望含义所必需的信息,本文提出了一种新的基于语义和面向任务的通信模式,并在此基础上,提出了一种基于语义和面向任务的通信模式,该模式能够有效地支持语义和面向任务的通信,并能有效地支持语义和面向任务的通信。面向1的通信范式,通过将搜索相关性作为数据交换的核心原则,联合解决B级(语义)和C级(有效性)问题。 PDF p.1PDF p.2
输入输入是任务导向推理所需的源数据与下游任务所需特征。
发送端发送端采用 The Search for Relevance:本文提出了一种联合语义和面向任务的通信范式,其中连接的设备仅发送传达与预期接收者相关的期望含义所必需的信息,本文提出了一种新的基于语义和面向任务的通信模式,并在此基础上,提出了一种基于语义和面向任务的通信模式,该模式能够有效地支持语义和面向任务的通信,并能有效地支持语义和面向任务的通信。面向1的通信范式,通过将搜索相关性作为数据交换的核心原则,联合解决B级(语义)和C级(有效性)问题。
实际发送实际发送对象是语义 feature 或未完整规定 bit 映射的 latent。
信道信道作用方式按“类别 0:信道作用点不足,或由外部传统链路抽象承担”解释。
接收端接收端从论文假设已经恢复的语义特征开始,再执行语义解码、任务推理或生成。
输出最终输出为分类、分割、检索或其他任务决策。
它在通信系统中的位置:只传下游任务需要的信息,并以任务质量而不是逐 bit 正确作为最终目标。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:语义 feature/latent;量化到 bitstream 的接口未完整报告
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“语义 feature/latent;量化到 bitstream 的接口未完整报告”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:The Search for Relevance 的主传输单位属于“语义 feature/latent;量化到 bitstream 的接口未完整报告”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
论文未同时报告输入尺寸、encoder 输出尺寸、量化精度/码本大小和帧级开销,因此不能从全文唯一重建总 bit 数。页面保留论文实际使用的 CBR、bpp、token 数或信道使用次数;缺失项不作臆测。 PDF p.2PDF p.9
架构/方法图|来源:《The Search for Relevance: A Context-Aware Paradigm Shift in Semantic and Task-Oriented V2X Communications》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《The Search for Relevance: A Context-Aware Paradigm Shift in Semantic and Task-Oriented V2X Communications》,原 PDF p.9,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2026图像传输、压缩或生成
TokenComSR: Task-Sensitivity-Guided Token Communication for Wireless Image Super-Resolution
架构/方法图|来源:《TokenComSR: Task-Sensitivity-Guided Token Communication for Wireless Image Super-Resolution》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《TokenComSR: Task-Sensitivity-Guided Token Communication for Wireless Image Super-Resolution》,原 PDF p.4,该页包含论文的关键实验结果图或表。 核对论文
核心纳入2026文本传输或语言任务
World Knowledge Enhanced Task-Oriented Semantic Communication Based on Large Language Model
现有进展:语义通信(SC)以其高效节能、高性能和智能任务执行能力,成为下一代无线网络中一项很有前途的技术。 PDF p.1
仍然存在的问题:然而,大多数现有的工作忽略了边缘设备在执行智能任务时遇到的多样化和复杂的物理环境,这可能会显着阻碍其在现实世界场景中的任务执行效率。 PDF p.1
为什么已有方法解决不了:像素级重建是比下游决策更强、也更昂贵的目标;但只压缩 feature 又可能丢掉决定任务的少量证据,因此需要把任务 loss 与通信瓶颈联合设计。 PDF p.1
为什么这个问题重要:一个 token 错误就可能改变整句含义,因此仅看 BER 不足以评价链路;必须追踪最终语言意义或任务输出。 PDF p.1
本文提出什么:为了解决这个问题,我们提出了一个世界知识增强面向任务的SC的基础上LLM,它可以提高下游的物理世界推理能力的接收端LLM,而不影响的通用性。 PDF p.1
方案为何可能有效:具体而言,知识提取方法的开发,以获得不同的体现经验的世界模型。 PDF p.1
作者希望证明什么:仿真结果表明,该方案增强了SC系统在任务执行中的空间推理能力,并优于其他基线方法在不同的信道。 PDF p.1
方法与端到端信息流
为了解决这一问题,本文提出了一种基于LLM的世界知识增强的面向任务的SC方案,该方案能够在不影响通用性的前提下提高接收端LLM的下游物理世界推理能力,并提出了一种从世界模型中获取丰富经验的知识提取方法,从而解决了上述问题。 PDF p.1PDF p.2
输入输入是文本传输或语言任务所需的句子、token 序列或语言语义。
发送端发送端采用 World Knowledge Enhanced Task-Oriented Semantic Communication Based on Large Language Model:为了解决这一问题,本文提出了一种基于LLM的世界知识增强的面向任务的SC方案,该方案能够在不影响通用性的前提下提高接收端LLM的下游物理世界推理能力,并提出了一种从世界模型中获取丰富经验的知识提取方法,从而解决了上述问题。
实际发送实际发送对象是语义 feature 或未完整规定 bit 映射的 latent。
信道信道作用方式按“类别 0:信道作用点不足,或由外部传统链路抽象承担”解释。
接收端接收端从论文假设已经恢复的语义特征开始,再执行语义解码、任务推理或生成。
输出最终输出为恢复文本、翻译结果或语言任务输出。
它在通信系统中的位置:只传下游任务需要的信息,并以任务质量而不是逐 bit 正确作为最终目标。
数字化方案与真实传输开销
是否属于严格数字语义通信:否/不适用:主接口为连续 JSCC 或上层模型
表示判断:语义 feature/latent;量化到 bitstream 的接口未完整报告
论文没有给出可复核的 VQ/codebook/index-to-bit 接口。系统模型中的传输表示属于“语义 feature/latent;量化到 bitstream 的接口未完整报告”;网络 latent 的浮点维度不能直接当作固定 bit。 表示判定:World Knowledge Enhanced Task-Oriented Semantic Communication Based on Large Language Model 的主传输单位属于“语义 feature/latent;量化到 bitstream 的接口未完整报告”。只有论文明确给出量化和映射时,才能把 token/index 数换算成总 bit;连续 channel symbol 只能按 channel uses/CBR 比较。 PDF p.2
论文未同时报告输入尺寸、encoder 输出尺寸、量化精度/码本大小和帧级开销,因此不能从全文唯一重建总 bit 数。页面保留论文实际使用的 CBR、bpp、token 数或信道使用次数;缺失项不作臆测。 PDF p.2PDF p.5
架构/方法图|来源:《World Knowledge Enhanced Task-Oriented Semantic Communication Based on Large Language Model》,原 PDF p.2,该页包含论文的主要方法/架构图。 核对论文关键实验结果图/表|来源:《World Knowledge Enhanced Task-Oriented Semantic Communication Based on Large Language Model》,原 PDF p.5,该页包含论文的关键实验结果图或表。 核对论文